引言 PostgreSQL 18 查询优化一书的范围、前置条件和演示数据库,以及本书与 QPT 课程的关系。
本书介绍 PostgreSQL 中查询优化的基础知识。
Postgres Professional 为数据库管理员和应用开发者开发培训课程。其中一门课程就是“QPT:查询性能调优”。
既然课程和本书讨论的是同一主题,为什么还要同时提供两者?
本书源自 QPT 课程的修订版,因此两者有大量重叠。差异在于形式。
课程从 PostgreSQL 用来规划和优化查询的基本算法讲起,系统地展开主题。课程分为多个模块和相关主题,每个主题都包含理论与实践。理论内容并不局限于幻灯片:大多数主题都会在课程虚拟机中实际运行的 PostgreSQL 实例上进行演示。学员会获得带有详细讲稿备注的幻灯片、演示输出、实践练习的解答以及额外的参考材料。课程可以在讲师指导下学习,也可以独立学习;包括视频录制在内的材料都可以从我们的网站获取。
如果你能亲自运行演示并完成练习,课程的效果最好。本书的用途有所不同。
你可以在地铁上或等公交车时阅读本书,夹上书签,之后继续阅读,无需启动计算机,也无需重新创建课程环境。
这种形式上的差异意味着,不能只是把课程文字搬到纸面上。过长的代码行不适合排在书页上,而课程中分开的理论和演示区块放进书里会显得生硬。因此,我们把演示结果重新编织进叙述中,修改了一些示例,也删去了主要用于说明附加细节的其他示例。为了让本书保持紧凑,我们还删去了“索引类型”主题,并合并了若干主题,其中包括“访问方法”和“并行访问”。
在阅读本书之前,你应当熟悉 SQL 和类 Unix 操作系统。了解 PL/pgSQL 会有帮助,但不是必需条件。我们还假定你具备 DBA1 或 DEV1 课程所覆盖的大致背景知识。对于那些不能直接帮助理解查询优化的服务器配置和内部实现细节,我们有意略去。
所有示例都使用日期为 2025 年 9 月 1 日的“Airlines”演示数据库。我们使用的是包含六个月航班数据的版本。面向 PostgreSQL 16 的 QPT 课程使用的是较早的演示数据库版本,日期为 2017 年 8 月 15 日。
参考资源 1 演示数据库探索 Airlines 演示数据库:其模式、bookings、tickets、flights、routes,以及 PostgreSQL 18 示例中使用的数据。
1. 基本信息 要处理更复杂的查询,我们需要一个规模可观的数据库:其中有九张填充了逼真数据的表。我们选择航空旅行作为主题。这个数据库包含某个时间段内由一家虚构航空公司运营的航班信息。
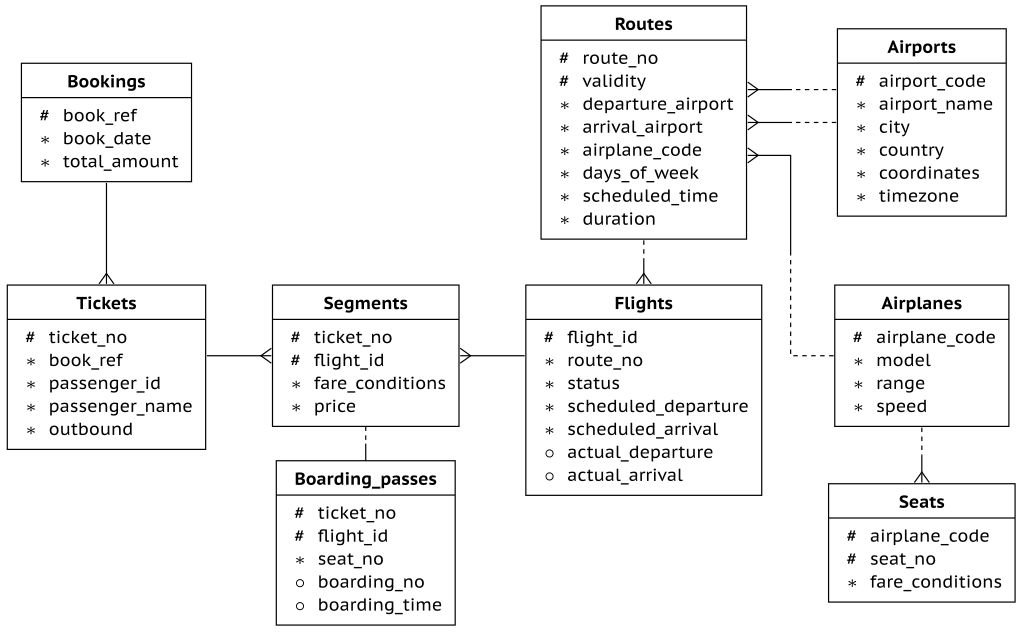
数据库模式如下图所示。我们尽量让它既不过于复杂,也不过于简单:足够简单,可以避免不必要的细节;又足够丰富,可以支持有意义且有趣的查询。
网站上提供四种大小的数据库。本书关于查询优化的示例使用的是 2025 年 9 月 1 日的版本,大小约为 2.7 GB,其中包含六个月的航班数据。
可以使用下面的函数检查版本:
SELECT bookings . version ();
version
-----------------------------------
PostgresPro 2025 - 09 - 01 ( 181 days )
( 1 row )
图 1.1 Airlines 数据库模式
2. 主要实体 核心实体是一个预订 (bookings)。
SELECT * FROM bookings b WHERE b . book_ref = '03RUKL' ;
book_ref | book_date | total_amount
----------+-------------------------------+--------------
03 RUKL | 2026 - 01 - 04 08 : 01 : 43 . 367932 + 03 | 84850 . 00
( 1 row ) 这行数据给出了预订日期和总金额。按照真实时钟,距离预订的时间每天都会增加:
SELECT now () - b . book_date
FROM bookings b
WHERE b . book_ref = '03RUKL' ;
? column ?
--------------------------
264 days 09 : 13 : 04 . 888436
( 1 row ) 不过,演示数据库有一个固定的“当前”时间:
SELECT bookings . now ();
now
------------------------
2026 - 03 - 01 03 : 00 : 00 + 03
( 1 row ) 相对于这个时钟,距离预订的时间就短得多:
SELECT bookings . now () - b . book_date
FROM bookings b
WHERE b . book_ref = '03RUKL' ;
? column ?
-------------------------
55 days 18 : 58 : 16 . 632068
( 1 row )
一笔预订可以包含多名乘客。每名乘客都会为去程行程获得一张单独的机票 (tickets);如果需要返程,还会再获得一张机票。
所选预订包含以下机票:
SELECT t . ticket_no , t . passenger_id , t . passenger_name
FROM bookings b
JOIN tickets t ON t . book_ref = b . book_ref
WHERE b . book_ref = '03RUKL' ;
ticket_no | passenger_id | passenger_name
---------------+------------------+--------------------
0005435998767 | RU 3761090132061 | Evgeniy Kondratyev
0005435998770 | RU 3761090132061 | Evgeniy Kondratyev
0005435998774 | RU 5595520101762 | Oleg Golubev
0005435998776 | RU 5595520101762 | Oleg Golubev
( 4 rows ) 如果出发地和目的地之间有直达航班,一张机票只包含一个航段 (segments);如果旅程需要转机,则会包含多个航段。
我们的乘客经过哪些航段?只需查看一名乘客,因为同一笔预订中的所有乘客都遵循相同的行程:
SELECT s . *
FROM tickets t
JOIN segments s ON s . ticket_no = t . ticket_no
WHERE t . ticket_no = '0005435998767' ;
ticket_no | flight_id | fare_conditions | price
---------------+-----------+-----------------+----------
0005435998767 | 17386 | Economy | 6750 . 00
0005435998767 | 17606 | Economy | 14500 . 00
( 2 rows ) 这是去程机票。把它与返程机票进行比较:
   ticket_no   | flight_id | fare_conditions |  price
---------------+-----------+-----------------+---------
 0005435998770 |     26693 | Comfort         | 3575.00
 0005435998770 |     27013 | Comfort         | 5525.00
 0005435998770 |     27375 | Economy         | 2750.00
 0005435998770 |     27537 | Economy         | 8250.00
(4 rows)
去程和返程的行程不必相同:返程时,Evgeniy 要转机三次,而且其中两趟航班 (flights)属于 Comfort 舱等。
每趟航班都沿着一条航线 (routes)从一个机场飞往另一个机场。航线号相同的航线具有相同的出发机场和到达机场,而单独的航班则由出发日期区分。
要找出所选航班对应的航线,必须考虑这两张表之间的时间关系。航班时刻表会随时间变化,因此连接条件不仅要匹配航线号,还要匹配航线的有效时间区间与航班出发时间。
SELECT r . route_no , f . scheduled_departure , f . status ,
r . departure_airport dep , r . arrival_airport arr
FROM tickets t
JOIN segments s ON s . ticket_no = t . ticket_no
JOIN flights f ON f . flight_id = s . flight_id
JOIN routes r ON r . route_no = f . route_no
AND r . validity @> f . scheduled_departure
WHERE t . ticket_no = '0005435998767'
ORDER BY f . scheduled_departure ;
route_no | scheduled_departure | status | dep | arr
----------+------------------------+---------+-----+-----
PG0177 | 2026 - 01 - 05 15 : 05 : 00 + 03 | Arrived | SVO | AER
PG0587 | 2026 - 01 - 06 19 : 00 : 00 + 03 | Arrived | AER | LHR
( 2 rows )
时刻表 (timetable)视图隐藏了这种复杂性。它像航班信息显示屏一样,在隐藏两张表之间连接的同时,展示我们需要的信息:
SELECT tt . route_no , tt . scheduled_departure , tt . status ,
tt . departure_airport dep , tt . arrival_airport arr
FROM tickets t
JOIN segments s ON s . ticket_no = t . ticket_no
JOIN timetable tt ON tt . flight_id = s . flight_id
WHERE t . ticket_no = '0005435998770'
ORDER BY tt . scheduled_departure ;
route_no | scheduled_departure | status | dep | arr
----------+------------------------+-----------+-----+-----
PG0272 | 2026 - 02 - 27 06 : 25 : 00 + 03 | Arrived | LHR | CDG
PG0781 | 2026 - 03 - 01 02 : 50 : 00 + 03 | Departed | CDG | MUC
PG0358 | 2026 - 03 - 03 03 : 50 : 00 + 03 | Scheduled | MUC | VIE
PG0165 | 2026 - 03 - 04 02 : 20 : 00 + 03 | Scheduled | VIE | SVO
( 4 rows ) 两趟去程航班和一趟返程航班已经抵达(状态为 Arrived)。按照演示数据库的当前时间,乘客正在从 CDG 飞往 MUC(状态为 Departed)。其余航班的值机尚未开放(状态为 Scheduled)。
机场 (airports)使用标准的三字母机场代码作为键。下面是一座机场的完整记录:
SELECT * FROM airports WHERE airport_code = 'CDG' \ gx
- [ RECORD 1 ] + ------------------
airport_code | CDG
airport_name | Charles de Gaulle
city | Paris
country | France
coordinates | ( 2 . 55 , 49 . 0128 )
timezone | Europe / Paris 下面是我们关心的航线:
SELECT lower ( r . validity ) valid_from ,
upper ( r . validity ) valid_to , r . airplane_code ,
r . days_of_week , r . scheduled_time , r . duration
FROM routes r
WHERE r . route_no = 'PG0781'
AND r . validity @> '2026-03-01 02:50:00+03' :: timestamptz \ gx
- [ RECORD 1 ] --+-----------------------
valid_from | 2026 - 02 - 01 03 : 00 : 00 + 03
valid_to | 2026 - 03 - 01 03 : 00 : 00 + 03
airplane_code | CR7
days_of_week | { 1 , 2 , 3 , 4 , 5 , 6 , 7 }
scheduled_time | 00 : 50 : 00
duration | 01 : 25 : 00 在这个有效期内,航线每周运行七天,使用一架 CR7 飞机 (airplanes):
SELECT * FROM airplanes WHERE airplane_code = 'CR7' ;
airplane_code | model | range | speed
---------------+-------------------+-------+-------
CR7 | Bombardier CRJ700 | 3100 | 829
( 1 row ) 座位 (seats)的数量及其在各票价舱等中的分布,取决于航班使用的飞机型号。在演示数据库中,同一型号的所有飞机都有相同的客舱配置。
例如,下面是第一排座位:
SELECT s . *
FROM airplanes a
JOIN seats s ON s . airplane_code = a . airplane_code
WHERE a . airplane_code = 'CR7'
AND s . seat_no ~ '^1.$' ;
airplane_code | seat_no | fare_conditions
---------------+---------+-----------------
CR7 | 1 A | Business
CR7 | 1 C | Business
CR7 | 1 D | Business
( 3 rows )
这些是 Business 舱座位。下面是这架飞机每个票价舱等中的座位总数:
SELECT s . fare_conditions , count ( * )
FROM seats s
WHERE s . airplane_code = 'CR7'
GROUP BY s . fare_conditions ;
fare_conditions | count
-----------------+-------
Business | 6
Comfort | 12
Economy | 52
( 3 rows ) 下面是所选航线上的一趟航班的完整记录。实际时间可能与时刻表不同:通常不会相差太多(本例中的出发时间延误了六分钟),但有时也可能相差数小时:
SELECT * FROM flights f
WHERE f . flight_id = 27013 \ gx
- [ RECORD 1 ] -------+----------------------------
flight_id | 27013
route_no | PG0781
status | Departed
scheduled_departure | 2026 - 03 - 01 02 : 50 : 00 + 03
scheduled_arrival | 2026 - 03 - 01 04 : 15 : 00 + 03
actual_departure | 2026 - 03 - 01 02 : 56 : 02 . 8521 + 03
actual_arrival | 当乘客为第一趟航班办理值机时,会为机票上的所有航班签发登机牌 (boarding_passes)。登机牌会指定座位。航班和座位的组合是唯一的:两名乘客不能占用同一个座位。登机时,登机牌会记录乘客的登机顺序号以及其通过登机口的时间。
我们的乘客坐过、或将要坐哪些座位?
SELECT f . status , f . flight_id , bp . seat_no , bp . boarding_no
FROM tickets t
JOIN segments s ON s . ticket_no = t . ticket_no
JOIN flights f ON f . flight_id = s . flight_id
LEFT JOIN boarding_passes bp
ON bp . ticket_no = s . ticket_no
AND bp . flight_id = s . flight_id
WHERE t . ticket_no IN ( '0005435998767' , '0005435998770' )
ORDER BY f . scheduled_departure ;
status | flight_id | seat_no | boarding_no
-----------+-----------+---------+-------------
Arrived | 17386 | 50 A | 41
Arrived | 17606 | 21 D | 16
Arrived | 26693 | 11 A | 176
Departed | 27013 | 7 C | 49
Scheduled | 27375 | 45 D |
Scheduled | 27537 | 13 B |
( 6 rows ) 演示数据库可以用不同语言显示机场、城市、国家和飞机名称。显示语言由数据库级别设置的配置参数控制:
SHOW bookings . lang ;
bookings . lang
---------------
en
( 1 row ) 把当前会话切换为俄语:
SET bookings . lang = 'ru' ;
SELECT * FROM airports a WHERE a . airport_code = 'SVO' \ gx
- [ RECORD 1 ] + ------------------
airport_code | SVO
airport_name | Шереметьево
city | Москва
country | Россия
coordinates | ( 37 . 4146 , 55 . 9726 )
timezone | Europe / Moscow
实现方式是在以 JSON 存储译名的基表之上创建视图:
SELECT ml . airport_name , ml . country , ml . city
FROM airports_data ml
WHERE ml . airport_code = 'SVO' \ gx
- [ RECORD 1 ] + --------------------------------------------
airport_name | { "en" : "Sheremetyevo" , "ru" : "Шереметьево" }
country | { "en" : "Russia" , "ru" : "Россия" }
city | { "en" : "Moscow" , "ru" : "Москва" } 最后总结一下,演示数据库中包含以下表和视图:
\dtv
               List of relations
  Schema  |      Name       | Type  |  Owner
----------+-----------------+-------+----------
 bookings | airplanes       | view  | postgres
 bookings | airplanes_data  | table | postgres
 bookings | airports        | view  | postgres
 bookings | airports_data   | table | postgres
 bookings | boarding_passes | table | postgres
 bookings | bookings        | table | postgres
 bookings | flights         | table | postgres
 bookings | routes          | table | postgres
 bookings | seats           | table | postgres
 bookings | segments        | table | postgres
 bookings | tickets         | table | postgres
 bookings | timetable       | view  | postgres
(12 rows)
2 规划与执行跟踪查询从解析到执行的过程,阅读 EXPLAIN 输出,并理解基数、代价估计、预备语句和游标。
1. 简单查询协议
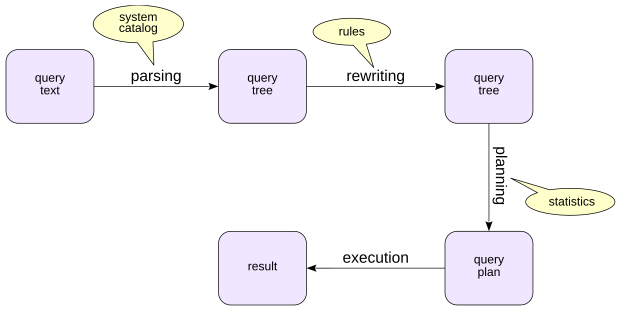
先从最简单的情况开始:当你在 psql 中输入一条 SELECT 命令时会发生什么?查询处理会经历以下几个阶段:
解析
重写
规划(优化)
执行
解析
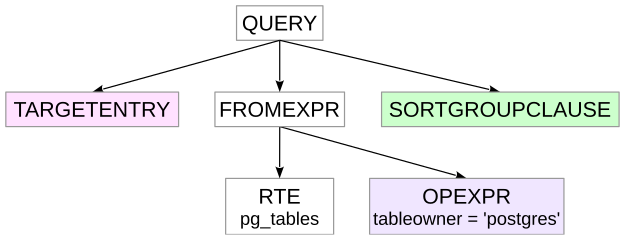
语法分析 第一步是解析:PostgreSQL 将查询文本拆分为标识符、数字、字符串字面量等词法单元,并检查这些词法单元能否组成语法有效的结构。
以一条简单查询为例:
SELECT schemaname , tablename
FROM pg_tables
WHERE tableowner = 'postgres'
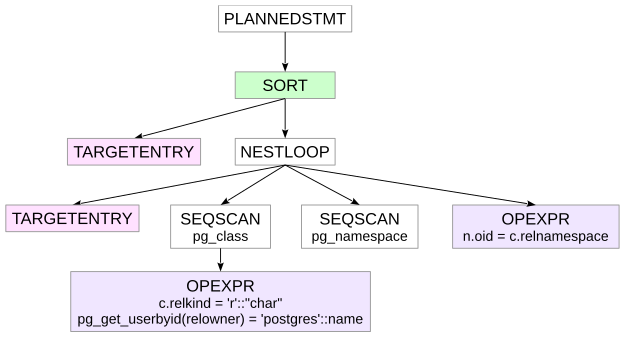
ORDER BY tablename ; 图 2.1 语法分析后的查询树 在这个阶段,后端会在内存中构建一棵语法解析树(parse tree)。图中展示了这棵树的简化版本。颜色表示查询文本各部分与树中节点之间的大致对应关系。
RTE 是范围表项(Range Table Entry)的缩写,这个名称从外部看并不直观。PostgreSQL 在内部使用 RTE 表示表、子查询、连接结果以及 SQL 查询中可能出现的其他行集。
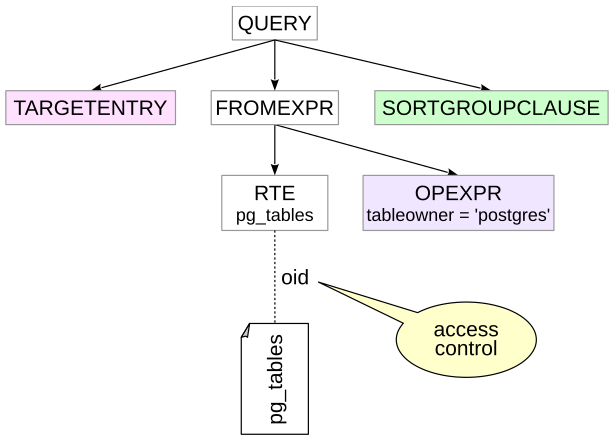
语义分析 接下来是语义分析,在 PostgreSQL 中称为解析分析(parse analysis)。在这个阶段,PostgreSQL 会确定查询引用了哪些数据库对象,以及用户是否有权访问这些对象。
SELECT schemaname , tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename ;
图 2.2 语义分析与访问控制 在解析分析期间,PostgreSQL 会查询系统目录。在这个例子中,它把名称 pg_tables 解析为目录中由 oid 标识的某个具体视图,同时也会检查该视图上的访问权限。
重写 然后,查询会根据规则进行重写。
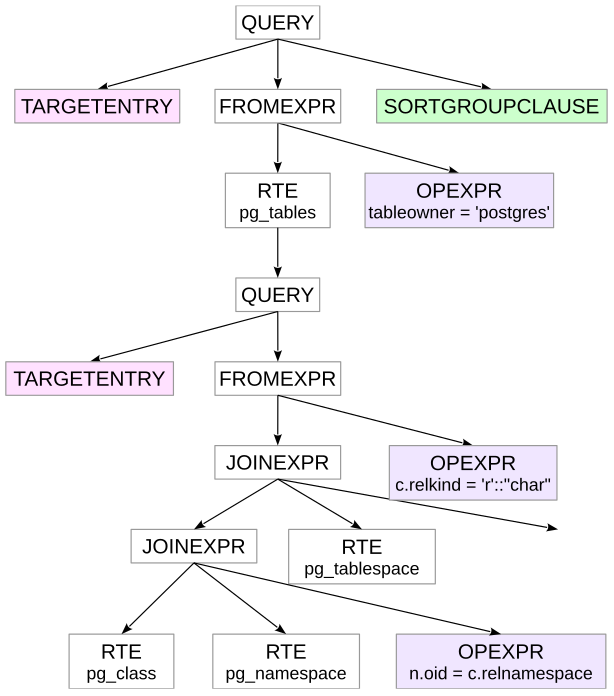
其中一个重要的特殊情况是视图:对视图的引用会展开为定义该视图的查询。严格来说,处理过程并不像这个简化序列所暗示的那样泾渭分明,因为视图定义本身也必须经过解析和分析。
对于我们的示例,可以近似地把结果画成下面这样:
SELECT schemaname , tablename
FROM (
SELECT ...
FROM pg_class c
LEFT JOIN pg_namespace n
ON n . oid = c . relnamespace
LEFT JOIN pg_tablespace t
ON t . oid = c . reltablespace
WHERE c . relkind = 'r' :: "char"
)
WHERE tableowner = 'postgres'
ORDER BY tablename ; 图 2.3 查询重写期间展开视图
这里的 SQL 仅用于说明。重写操作的对象是查询树,而不是替换 SQL 文本。在树中,与视图查询对应的节点会挂接到 pg_tables 的 RTE 下方。
规划 接下来 PostgreSQL 会规划查询。
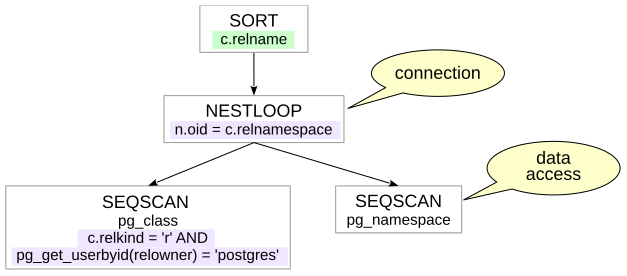
规划器(planner)会考虑执行查询的不同方式,并通过数学模型估计它们的代价。这个模型使用有关数据的信息,称为统计信息 (statistics)。估计代价最低的候选方案会表示为一棵计划树。
我们的示例对应的计划片段如下:
Sort
  Sort Key: c.relname
  ->  Nested Loop Left Join
        Join Filter: (n.oid = c.relnamespace)
        ->  Seq Scan on pg_class c
              Filter: ((relkind = 'r'::"char") AND pg_ge...
        ->  Seq Scan on pg_namespace n
图 2.4 从查询树到执行计划
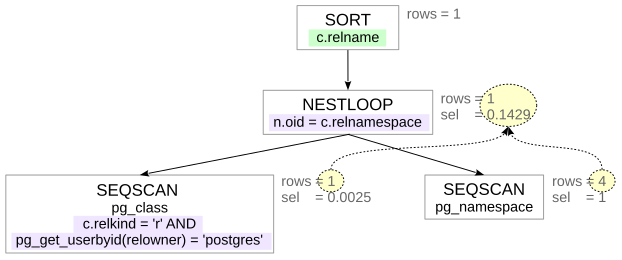
Seq Scan 从表中读取行,而 Nested Loop 连接两个行集。图中的文本表示形式就是 EXPLAIN 命令生成的形式。后续章节会详细讨论访问方法和连接方法。
注意,原来的三张表中现在只剩下两张:规划器已经确定其中一张表不是生成结果所必需的,因此将它从计划中移除了。
执行 最后,执行器运行选定的计划,并将结果返回给客户端。
计划树的工作方式类似一条流水线。下图重新绘制了计划树,只保留其基本结构。
图 2.5 执行计划节点 执行从树的根节点开始。在这个例子中,根节点是 Sort,它向子节点请求数据。获得所需数据后,根节点执行自己的操作并将行向上返回,最终送达客户端。
Nested Loop 这样的节点会组合来自不同来源的数据。连接节点向两个子节点请求行,根据连接条件比较这些行,然后把匹配的行对返回给父节点。下方的 Seq Scan 节点从对应的表中读取
有些节点必须读取完所需的全部输入后才能返回任何结果。普通排序就是一个例子:它必须先看到输入,才能确定排序后的顺序。
另一些节点可以随着行到达而返回行。例如,表扫描通常可以在读取表的同时产生行。这样就有可能迅速返回结果的前一部分,例如应用程序逐页显示数据时。PostgreSQL 文档把这种执行器机制称为按需拉取的流水线 (demand-pull pipeline):父节点向子节点请求下一行,这个请求沿着计划树向下传播。
图 2.6 查询处理阶段 2. 扩展查询协议 默认情况下,客户端使用简单查询协议:它向服务器发送一条 SQL 语句,然后对于 SELECT 或带有 RETURNING 的命令接收结果行。
例如:
SELECT model FROM airplanes WHERE airplane_code = '77W' ;
model
------------------
Boeing 777 - 300 ER
( 1 row ) 使用简单查询协议时,即使同一条查询被反复执行,每次查询仍然会经历上面描述的全部处理阶段。
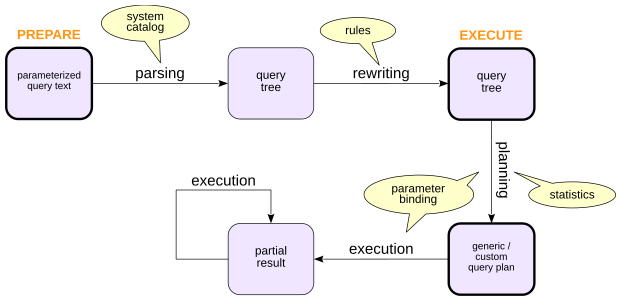
PostgreSQL 还提供扩展查询协议,把查询处理分成更明确的步骤。在实践中,这使得准备语句和使用游标成为可能。
预备语句 为了准备一条语句,客户端向服务器发送一个查询,其中可以包含参数。服务器会解析、分析并重写查询,然后在后端进程中保留预备语句状态。
要执行预备语句,客户端为它的参数提供值。然后,PostgreSQL 可以构建一份考虑了这些具体值的自定义计划 (custom plan)并执行它。
准备语句可以避免在同一会话中反复执行同一条语句时重复解析、分析和重写。
如果语句没有参数,那么没有必要为每次执行重新规划,因此 PostgreSQL 可以复用一份通用计划 (generic plan)。
如果语句确实有参数,PostgreSQL 起初可以使用自定义计划;当它估计通用计划的平均表现不会显著变差时,之后也可能切换到通用计划。我们会在 第六章“统计信息”
预备语句也是避免 SQL 注入的重要手段:来自不可信来源的值可以作为参数单独发送,而不必拼接进 SQL 文本。这种保护适用于作为参数传递的值;对于表名、列名等动态 SQL 结构,仍然必须采用安全方式构造。
准备一条参数化语句:
PREPARE model ( varchar ) AS
SELECT model
FROM airplanes
WHERE airplane_code = $ 1 ;
PREPARE 按名称执行它:
EXECUTE model('CR7');
       model
-------------------
 Bombardier CRJ700
(1 row)
在执行时,参数值会被绑定,语句按需进行规划,然后执行。
可以通过 pg_prepared_statements 视图检查预备语句:
SELECT * FROM pg_prepared_statements \ gx
- [ RECORD 1 ] ---+------------------------------
name | model
statement | PREPARE model ( varchar ) AS +
| SELECT model +
| FROM airplanes +
| WHERE airplane_code = $ 1 ;
prepare_time | 2026 - 09 - 25 17 : 14 : 48 . 990998 + 03
parameter_types | { "character varying" }
result_types | { text }
from_sql | t 使用通用计划的执行次数
generic_plans   | 0
custom_plans    | 1
使用自定义计划的执行次数
最后两列显示该语句使用通用计划和自定义计划的次数。当预备语句不再需要时,可以使用 DEALLOCATE 将其移除。
PREPARE、EXECUTE 和 DEALLOCATE 是 SQL 命令。其他编程语言以不同方式提供相同的功能,但数据库驱动最终都会使用相同的客户端/服务器协议。
游标 游标可以让我们逐步获取查询结果,而不是一次接收所有行。游标很常见,因为应用程序通常使用命令式语言编写,并且经常迭代处理结果集。
打开游标的信息保存在后端进程中。
在 SQL 中声明游标并获取第一行。游标通常存在于事务内部:
BEGIN ;
BEGIN
DECLARE c CURSOR FOR SELECT * FROM airplanes ;
DECLARE CURSOR
FETCH c ;
airplane_code | model | range | speed
---------------+-----------------+-------+-------
32 N | Aerobus A320neo | 6500 | 830
( 1 row ) 获取第二行(事务结束时游标会自动关闭):
FETCH c ;
airplane_code | model | range | speed
---------------+---------------------+-------+-------
339 | Aerobus A330 - 900 neo | 13300 | 870
( 1 row )
COMMIT ;
COMMIT 数据库 API 提供了判断是否还有结果数据的方法,因此应用程序可以在循环中从游标获取数据。
图 2.7 预备语句与游标执行
3. 深入了解规划 规划值得进一步了解,因为它既是查询性能的核心,也是查询处理过程中较为复杂的阶段之一。
规划过程 规划器会探索不同的执行计划,估计它们的代价,并从中选择找到的代价最低者。
计划节点的代价取决于正在执行的操作以及它所处理的数据的性质。显然,按顺序从表中读取行与通过索引获取行使用的是不同的代价模型,而正在处理的数据量也非常重要。
估计数据量时,有两个概念尤其重要:
估计选择率和基数需要有关数据的信息:表的大小、列中的值分布等等。在实践中,这会把我们引向统计信息 。PostgreSQL 通过 autovacuum 的自动分析工作以及 ANALYZE 命令收集和刷新统计信息。基数错误是造成糟糕计划的最重要原因之一。
基数错误可能来自统计信息不足,可能来自现有统计信息没有描述的相关性,可能来自没有可用有效统计信息的表达式,也可能来自
基数估计 基数估计是递归进行的。为了估计某个节点的基数,PostgreSQL 会先估计其子节点的基数,然后根据节点类型和节点的谓词估计该节点本身会产生多少行。
图 2.8 基数和选择率估计 这个过程从叶节点开始,访问方法在叶节点读取数据。估计叶节点需要知道关系的大小以及其谓词的选择率。后续章节会说明这些估计来自哪里。
暂且假设我们可以估计简单谓词的选择率。这样,就可以使用如下公式近似计算复合谓词的选择率:
sel x a n d y = sel x sel y sel x o r y = 1 − ( 1 − sel x ) ( 1 − sel y )
\begin{aligned}
\operatorname{sel}_{x\ \mathrm{and}\ y} = \operatorname{sel}_x\operatorname{sel}_y
\\
\operatorname{sel}_{x\ \mathrm{or}\ y} = 1 - (1 - \operatorname{sel}_x)(1 - \operatorname{sel}_y)
\end{aligned}
sel x and y = sel x sel y sel x or y = 1 − ( 1 − sel x ) ( 1 − sel y ) 这些公式假定条件 x 和 y 相互独立。如果谓词之间存在相关性,估计就可能
接下来是连接。我们已经有了两个输入行集的基数估计,因此还需要估计连接条件的选择率。具体细节暂且留到后面,之后会回到具体示例。
其他节点也可以用类似方式处理,例如聚合。排序通常保持基数不变,而其他操作可能会改变基数。
计划树底部引入的估计误差会向上传播。随着更多操作符依赖错误估计,误差可能会被放大,最终导致规划器选择一个糟糕的计划。
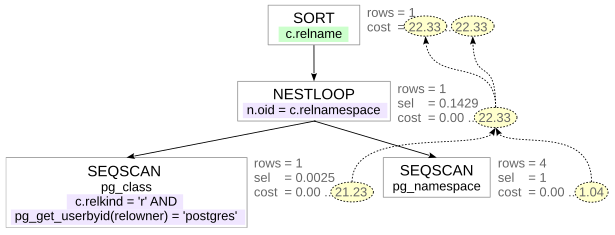
代价估计 代价估计同样是递归进行的。为了估计计划子树的代价,PostgreSQL 会从子节点的代价开始,再加上当前节点执行操作的代价。
图 2.9 启动代价与总代价估计 节点的代价由规划器的数学模型计算得出,该模型使用了为节点估计的基数和其他属性。
EXPLAIN 展示两个代价组成部分:启动代价 定义了节点开始产生行之前必须完成的工作量估计值;总代价 定义了产生全部行的代价估计值。
有些操作几乎不需要启动工作。另一些操作则必须在返回第一行之前完成大量工作。
例如,普通排序必须先读取要排序的输入,才能输出排好序的结果。这样的节点具有非零启动代价,即使消费者只需要最终结果中的一小部分,也必须支付这部分代价。
必须理解,代价反映的是规划器的估计,而且可能与实际执行时间没有关联。可以把代价看作用任意单位表示的量,这些单位本身没有意义。代价的用途只是让规划器能够比较同一查询的不同计划。
选择最佳计划 优化器会尝试在不过度耗费规划时间的前提下找到最佳计划。
对于连接,PostgreSQL 通常使用动态规划:从较小的连接关系构建更大的连接关系,同时丢弃那些按照规划器标准不可能胜出的替代方案。随着关系数量增加,穷举考虑所有连接顺序的代价会变得过高。PostgreSQL 可以通过只考虑部分成对连接方案,或切换到遗传查询优化器(Genetic Query Optimizer,GEQO),来减少需要考虑的计划数量。这又带来了计划不佳的另一种可能来源:问题不在于代价估计错误,而在于最佳计划从未被考虑。在这种情况下,
对于普通查询,什么样的计划算是“最佳”计划?PostgreSQL 通常会优化获取完整结果的过程,因此总代价占主导地位。
然而,使用游标时,快速获得前几行可能更加重要。参数 cursor_tuple_fraction(默认值为 0.1)告诉规划器预计会获取游标结果的多少比例。这个值越小,启动代价相对于总代价的影响就越大。
查看查询计划 EXPLAIN 会显示查询计划。它是查询性能工作不可或缺的工具,学会正确阅读它十分重要。下面是上面使用过的查询对应的计划:
EXPLAIN SELECT schemaname , tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename ;
QUERY PLAN
------------------------------------------------------------
Sort ( cost = 22 . 36 .. 22 . 37 rows = 1 width = 128 )
Sort Key : c . relname
-> Nested Loop Left Join
( cost = 0 . 00 .. 22 . 35 rows = 1 width = 128 )
Join Filter : ( n . oid = c . relnamespace )
-> Seq Scan on pg_class c
( cost = 0 . 00 .. 21 . 26 rows = 1 width = 72 )
Filter : (( relkind = ANY ( '{r,p}' :: "char" [])) ...
-> Seq Scan on pg_namespace n
( cost = 0 . 00 .. 1 . 04 rows = 4 width = 68 )
( 10 rows )
加入 analyze 后,PostgreSQL 会执行查询,并显示实际执行统计信息以及估计值:
EXPLAIN ( analyze , buffers off ) SELECT schemaname , tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename ;
QUERY PLAN
------------------------------------------------------------
Sort ( cost = 22 . 36 .. 22 . 37 rows = 1 width = 128 )
( actual time = 0 . 101 .. 0 . 103 rows = 77 . 00 loops = 1 )
Sort Key : c . relname
Sort Method : quicksort Memory : 35 kB
-> Nested Loop Left Join
( cost = 0 . 00 .. 22 . 35 rows = 1 width = 128 )
( actual time = 0 . 009 .. 0 . 080 rows = 77 . 00 loops = 1 )
Join Filter : ( n . oid = c . relnamespace )
Rows Removed by Join Filter : 112
-> Seq Scan on pg_class c
( cost = 0 . 00 .. 21 . 26 rows = 1 width = 72 )
( actual time = 0 . 006 .. 0 . 039 rows = 77 . 00 loops = 1 )
Filter : (( relkind = ANY ( '{r,p}' :: "char" [])) ...
Rows Removed by Filter : 382
-> Seq Scan on pg_namespace n
( cost = 0 . 00 .. 1 . 04 rows = 4 width = 68 )
( actual time = 0 . 000 .. 0 . 000 rows = 2 . 45 loops = 77 )
Planning Time : 0 . 080 ms
Execution Time : 0 . 113 ms
( 19 rows ) 对会修改数据的语句使用 EXPLAIN ANALYZE 时要小心:该语句确实会被执行。
在某些平台上,为每个计划节点收集计时信息可能会明显拖慢查询。如果不需要每个节点的计时信息,可以使用 timing off 将其禁用。
参考资源 3 访问方法比较顺序扫描、索引扫描、位图扫描、仅索引扫描和并行扫描,了解可见性检查、覆盖索引以及选择率的作用。
1. 顺序扫描 规划器有多种访问表数据的方式。最简单的一种是顺序扫描 (Seq Scan)。
顺序扫描逐页读取表的主分支。和通常一样,普通表通过共享缓冲区缓存读取;临时表使用会话的本地缓冲区。
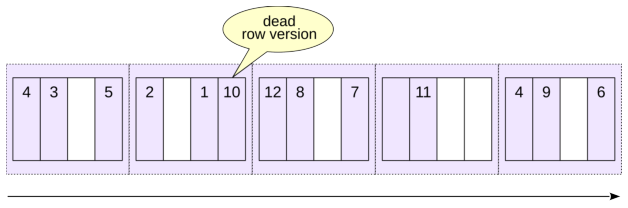
图 3.1 堆页的顺序扫描 顺序扫描期间,PostgreSQL 可以使用操作系统预读或异步 I/O 高效地预取相邻页面,而不必发起彼此无关的随机读取。
当查询必须读取整张表或表的大部分内容时,顺序扫描通常是不错的选择,也就是谓词筛选作用弱 时:输入行中有很大一部分能够通过谓词。
在查询计划中,顺序扫描由 Seq Scan 节点表示:
EXPLAIN SELECT * FROM flights ;
QUERY PLAN
-------------------------------------------
Seq Scan on flights
( cost = 0 . 00 .. 744 . 71 rows = 37671 width = 51 )
( 2 rows ) 括号中的值很重要:
cost 是估计代价。
rows 是该操作返回的估计行数。
width 是估计的平均行宽,单位为字节。
代价以规划器的任意单位计量,由两个部分组成。
PostgreSQL 的代价模型同时考虑 I/O 工作和 CPU 工作。在本例使用的简化计算中,I/O 部分等于表页数乘以一次顺序页面读取的代价:
SELECT relpages ,
current_setting ( 'seq_page_cost' ),
relpages * current_setting ( 'seq_page_cost' ):: real AS total
FROM pg_class WHERE relname = 'flights' ;
 relpages | current_setting | total
----------+-----------------+-------
      368 | 1               |   368
(1 row)
CPU 部分包括处理表行的代价:
SELECT reltuples ,
current_setting ( 'cpu_tuple_cost' ),
reltuples * current_setting ( 'cpu_tuple_cost' ):: real AS total
FROM pg_class WHERE relname = 'flights' ;
reltuples | current_setting | total
-----------+-----------------+--------
37671 | 0 . 01 | 376 . 71
( 1 row )
死行版本 顺序扫描期间,PostgreSQL 必须检查每个页面中的行版本,其中也包括尚未由清理操作移除的过时版本。如果一张表包含大量死行版本,扫描它的代价可能会显著增加。
这也是及时清理能够提升某些查询性能的原因之一。
创建 flights 的副本,并禁用自动清理,使死行版本不会被自动清理:
CREATE TABLE flights_copy
WITH ( autovacuum_enabled = false )
AS SELECT * FROM flights ;
SELECT 37671
SELECT pg_size_pretty (
pg_total_relation_size ( 'flights_copy' )
);
pg_size_pretty
----------------
3024 kB
( 1 row ) 删除所有行:
DELETE FROM flights_copy ;
DELETE 37671 旧的行版本会保留在表文件中,直到清理操作回收它们,因此文件大小仍然相同:
SELECT pg_size_pretty (
pg_total_relation_size ( 'flights_copy' )
);
pg_size_pretty
----------------
3024 kB
( 1 row ) 使用 analyze 选项获取查询计划。隐式启用的 buffers 选项会显示块的数量:
EXPLAIN ( analyze , timing off , summary off )
SELECT count ( * ) FROM flights_copy ;
QUERY PLAN
------------------------------------------------------------
Aggregate ( cost = 673 . 89 .. 673 . 90 rows = 1 width = 8 ) ( actual ...
Buffers : shared hit = 377
-> Seq Scan on flights_copy ( cost = 0 . 00 .. 614 . 51 rows = ...
Buffers : shared hit = 377
Planning :
Buffers : shared hit = 3
( 6 rows ) 这次扫描触碰了三百多个堆页,尽管其中已经没有任何存活行。清理表并再次检查大小:
VACUUM flights_copy ;
SELECT pg_size_pretty ( pg_total_relation_size ( 'flights_copy' ));
VACUUM
pg_size_pretty
----------------
24 kB
( 1 row ) 死行版本已经被移除,表的大小也随之减小。再次运行查询:
EXPLAIN ( analyze , timing off , summary off )
SELECT count ( * ) FROM flights_copy ;
QUERY PLAN
------------------------------------------------------------
Aggregate ( cost = 0 . 00 .. 0 . 01 rows = 1 width = 8 ) ( actual row ...
-> Seq Scan on flights_copy ( cost = 0 . 00 .. 0 . 00 rows = 1 ...
Planning :
Buffers : shared hit = 2
( 4 rows ) 表是空的,因此没有需要检查的行版本,估计代价也很小。在大得多的表上,
DROP TABLE flights_copy;
DROP TABLE
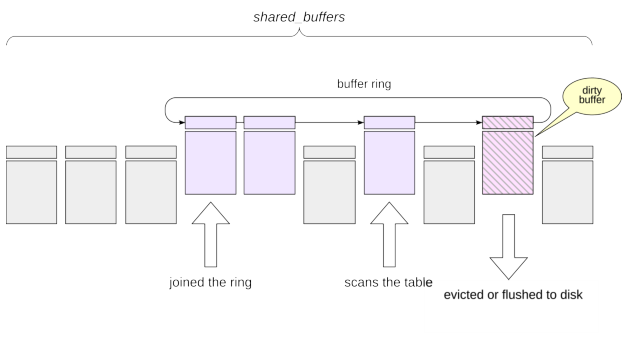
缓冲区环与同步扫描 大型顺序扫描可能会让许多只使用一次的页面经过缓冲区缓存,从而驱逐有用的缓存页面。为避免这种情况,对于足够大的堆扫描,PostgreSQL 会使用批量读取缓冲区访问策略。当一个关系大于缓冲区缓存的四分之一时,缓存中只有一部分会被用作缓冲区环 (buffer ring),替换操作只发生在这个环中,而缓存数据的其余部分不受影响。
图 3.2 顺序扫描的缓冲区环 大型顺序扫描还可以使用同步扫描 。当多个后端扫描同一张大表时,新扫描可以从另一个扫描当前所在的位置附近开始,继续读到末尾,然后绕回开头。这样一来,多个后端
临时表使用本地缓冲区,因此这种缓冲区缓存访问策略和同步扫描机制对临时表不起同样的作用。
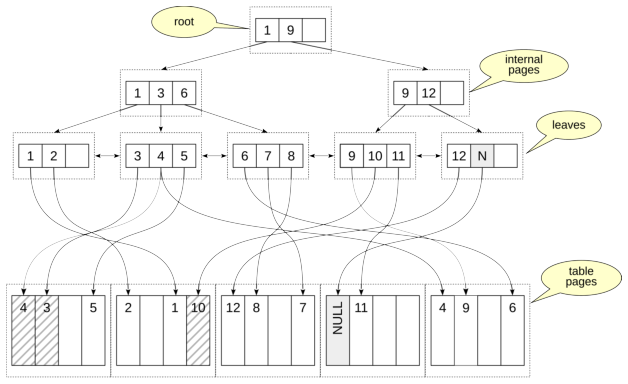
2. 索引扫描 我们将使用 PostgreSQL 的一种索引类型——B-树 (B-tree)——来解释 Index Scan。它是标量数据最常用的索引类型。
和 PostgreSQL 的其他索引一样,B-树是一种二级结构。它占用额外的磁盘空间,可以删除,再根据表中的数据重新创建。它的用途是降低访问表中相对较小部分数据的操作代价;B-树索引还用于实施主键约束和唯一约束。
索引把索引值——搜索键 ——与表行版本的引用关联起来。B-树按照明确的排序顺序保存键,因此 PostgreSQL 可以沿树导航到所需的键,然后通过相应的元组标识符进入表。B-树操作符类必须为数据类型定义线性排序。数字、字符串和日期是典型例子。相比之下,几何点没有适用于通常 B-树语义的单一自然全序;PostgreSQL 为空间数据提供了其他索引类型。
PostgreSQL 的 B-树是平衡的,并且具有很高的分支度。它的深度取决于键的大小和索引项的数量,但在实践中,即使是非常大的索引通常也只需要几层。
图 3.3 B-树索引与堆页 图中展示了一个 B-树示例。它的页面由索引项组成,每个索引项包含:
页面内的键按顺序排列。
叶页 是树的最底层。它们的索引项引用表行版本。叶页沿两个方向相互链接,因此可以高效地向前或向后扫描键。
内部页 指向下一层的页面。分隔键告诉搜索过程哪个子树可能包含请求的值。最顶层的页面是根页 。
B-树页面不必完全填满;空闲空间可供未来插入使用。
当一个页面无法容纳新项时,PostgreSQL 会拆分该页面。一半保留在原页面中,并分配一个新的兄弟页面。B-树页面通常不会在拆分后
默认情况下,B-树索引在升序时将空值存储在非空值之后(NULLS LAST)。创建索引时,可以结合 ASC 或 DESC(视需要而定)使用 NULLS FIRST 或 NULLS LAST 改变排序方式。
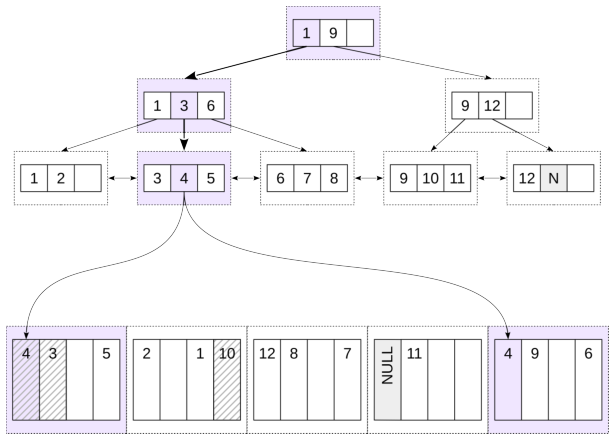
查找单个值 假设我们要查找索引值为 4 的行。
搜索从树的根开始。根页中的索引项定义了下方页面的键范围:“从 1 到 9”和“9 及以上”。我们需要“从 1 到 9”的范围,它对应于键为 1 的索引项。键是有序的,因此在页面内搜索非常高效。
图 3.4 单个值的索引查找 我们找到的索引项引用指向第二层的一个页面。在那里,我们找到“从 3 到 6”的范围
(键为 3),然后移动到第三层的一个页面。这是一个叶页。在那里我们找到键 4,并沿着它的引用进入表页。
请注意,即使是唯一索引也可能包含重复键,因为 MVCC 可以为同一行创建多个版本。为了节省空间,相等的键可以作为一个索引项存储在索引页中,该索引项包含多个指针。
返回一个堆元组之前,必须检查其可见性。
图中突出显示了必须访问的页面和索引项。
考虑 bookings 表。列 book_ref 是主键,因此 PostgreSQL 自动创建了唯一 B-树索引 bookings_pkey。
检查查找一个键时的计划:
EXPLAIN SELECT * FROM bookings WHERE book_ref = 'CDEFD8' ;
QUERY PLAN
---------------------------------------------
Index Scan using bookings_pkey on bookings
( cost = 0 . 43 .. 8 . 45 rows = 1 width = 21 )
Index Cond : ( book_ref = 'CDEFD8' :: bpchar )
( 3 rows ) 所选择的访问方法是 Index Scan,计划中也给出了索引名称。对索引和堆的访问由一个计划节点表示。Index Cond 显示索引使用的条件。
对于这类查找,启动代价包括下降到相关叶页所需的工作。这个估计值很小,是因为规划器预计 B-树的上层页面已经在缓存中,主要只对向下查找过程收取 CPU 工作的代价。
总代价还要加上预期的叶页和堆页访问。
由于该索引是唯一索引,而且相等条件至多能识别一个可见行,粗略的代价直觉大致是访问一个叶页,再访问一个堆页。随机页面读取使用 random_page_cost 计价:
SELECT current_setting ( 'random_page_cost' );
current_setting
-----------------
4
( 1 row ) 它的默认值高于 seq_page_cost,反映了传统上为非顺序访问设定的更高代价。在 SSD 上,或者大多数数据都已缓存时,实际部署中通常会缩小这两个参数之间的差距。
正确的取值取决于存储和工作负载,而不是某条适用于所有情况的 SSD 规则。
Index Cond 包含能够驱动索引扫描的条件,或能够在索引层检查的其他条件。
需要访问堆行的条件会单独显示为 Filter:
EXPLAIN SELECT * FROM bookings
WHERE book_ref = 'CDEFD8' AND total_amount > 1000 ;
QUERY PLAN
---------------------------------------------
Index Scan using bookings_pkey on bookings
( cost = 0 . 43 .. 8 . 45 rows = 1 width = 21 )
Index Cond : ( book_ref = 'CDEFD8' :: bpchar )
Filter : ( total_amount > '1000' :: numeric )
( 4 rows )
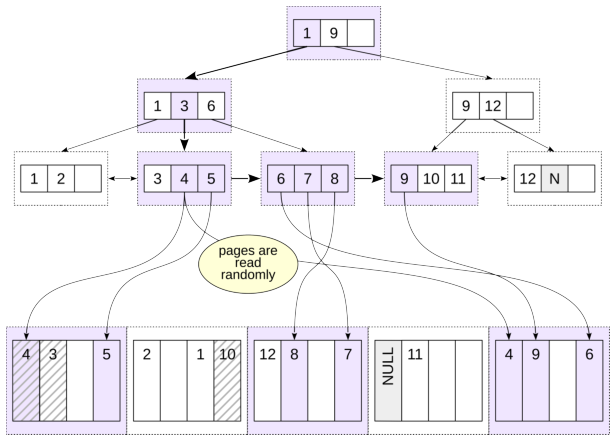
查找一个范围 B-树不仅适合相等查找,也适合有序范围:<、<=、>、>= 和 BETWEEN。
首先,找到条件的边界键。例如,对于从 4 到 9 的范围,可以选择 4 或 9;而对于“小于 9”的条件,则必须选择 9。然后,像前面的例子一样下降到叶索引页,取得表中的第一个值。从那里开始,根据条件向右或向左经过叶索引页,检查索引项,直到遇到范围外的键。
图 3.5 索引范围扫描 图中展示了对 x BETWEEN 4 AND 9 的搜索,它等价于 x >= 4 AND x <= 9。PostgreSQL 下降到第一个符合条件的键,然后访问 5、6 等值,一直到 9。到达 10 时,范围扫描停止。
有两个性质使这一过程成为可能:所有页面上的键都是有序的,叶页通过双向链表相互连接。搜索
注意,我们不得不多次访问同一个表页。我们先为值 4 读取第一个表页,然后再次为值 4 读取最后一个页面;接着为值 5 再次读取第一个页面,为值 6 再次读取最后一个页面,如此反复。
B-树提供的排序可以消除单独的排序操作:
EXPLAIN ( costs off )
SELECT * FROM bookings
WHERE book_ref > '000CTL' AND book_ref < '000FHR'
ORDER BY book_ref ;
QUERY PLAN
------------------------------------------------------------
Index Scan using bookings_pkey on bookings
Index Cond : (( book_ref > '000CTL' :: bpchar ) AND ( book_ ...
( 2 rows ) 同一个 B-树也可以反向扫描:
EXPLAIN ( analyze , costs off , timing off , summary off )
SELECT * FROM bookings
WHERE book_ref > '000CTL' AND book_ref < '000FHR'
ORDER BY book_ref DESC ;
QUERY PLAN
------------------------------------------------------------
Index Scan Backward using bookings_pkey on bookings ( ac ...
Index Cond : (( book_ref > '000CTL' :: bpchar ) AND ( book_ ...
Index Searches : 1
Buffers : shared hit = 3 read = 5
Planning :
Buffers : shared hit = 13
( 6 rows ) 在这里,扫描到达适当的右侧叶位置,然后沿叶页链反向移动。Buffers 显示页面流量,而 Index Searches 显示发起了多少次独立的 B-树搜索。
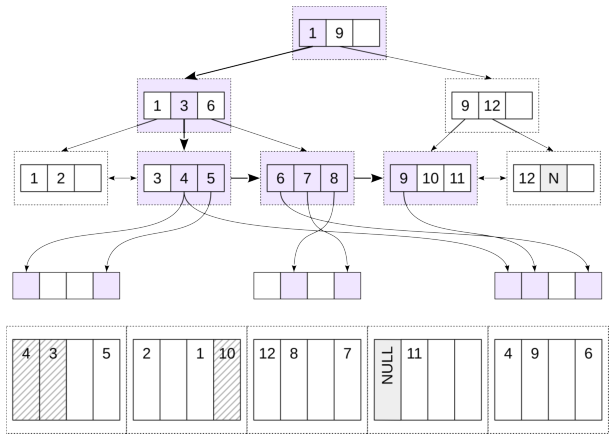
3. 位图扫描 反复访问相同的堆页可能使普通索引扫描变得昂贵。即使页面已经在缓冲区缓存中,PostgreSQL 仍然必须定位并固定页面,还要完成所需的元组工作。位图扫描 把查找候选元组位置和访问堆页分离开来。
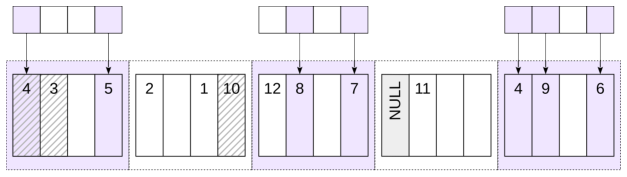
图 3.6 从索引构建位图 首先扫描索引(Bitmap Index Scan),并在进程的本地内存中构建位图。位图由多个块组成。每个块对应一个表页,块中的每一位对应该页面中的一个行版本。构建位图时,会标记满足条件且必须读取的行版本。由于位图被分成多个块,只标记少数行版本的位图占用的空间很小。
从概念上说,精确位图项标识堆页以及这些页面中的元组偏移量。
图 3.7 通过位图读取堆页 位图准备好后,Bitmap Heap Scan 会访问堆页。
一个堆页可能包含多个候选元组,但页面本身只需访问一次。当许多匹配的索引项分散在较少的堆页中时,这就是相对于普通索引扫描的主要优势。
CREATE INDEX ON bookings ( book_date );
CREATE INDEX ON bookings ( total_amount ); 上面创建的两个索引为规划器提供了可供选择的位图来源。对于返回大量行的查询,它会选择位图扫描:
EXPLAIN SELECT *
FROM bookings WHERE total_amount < 5000 ;
QUERY PLAN
-----------------------------------------------------
Bitmap Heap Scan on bookings
( cost = 6241 . 15 .. 26259 . 60 rows = 332996 width = 21 )
Recheck Cond : ( total_amount < '5000' :: numeric )
-> Bitmap Index Scan on bookings_total_amount_idx
( cost = 0 . 00 .. 6157 . 90 rows = 332996 width = 0 )
Index Cond : ( total_amount < '5000' :: numeric )
( 6 rows ) 计划中有两个相关节点:
启动代价体现了这种权衡:位图必须完整构建后才能使用。位图访问放弃了普通索引扫描的流式行为,换取组织得更好的堆访问。
组合位图 位图还可以组合多个索引条件。对于同一索引上的两个范围:
EXPLAIN ( costs off )
SELECT * FROM bookings
WHERE total_amount < 5000
OR total_amount > 500000 ;
QUERY PLAN
------------------------------------------------------------
Bitmap Heap Scan on bookings
Recheck Cond : (( total_amount < '5000' :: numeric ) OR ( t ...
-> BitmapOr
-> Bitmap Index Scan on bookings_total_amount_idx
Index Cond : ( total_amount < '5000' :: numeric )
-> Bitmap Index Scan on bookings_total_amount_idx
Index Cond : ( total_amount > '500000' :: numeric )
( 7 rows ) PostgreSQL 构建两个位图,再使用 BitmapOr 将它们组合起来。
不同的索引也可以参与组合位图扫描:
EXPLAIN ( costs off )
SELECT * FROM bookings
WHERE total_amount < 5000
OR book_date = bookings . now () - INTERVAL '1 day' ;
                         QUERY PLAN
------------------------------------------------------------
 Bitmap Heap Scan on bookings
   Recheck Cond: ((total_amount < '5000'::numeric) OR (b...
   -> BitmapOr
       -> Bitmap Index Scan on bookings_total_amount_idx
           Index Cond: (total_amount < '5000'::numeric)
       -> Bitmap Index Scan on bookings_book_date_idx
           Index Cond: (book_date = ('2026-03-01 03:00:0...
(7 rows)
有损位图页 位图存储在后端本地内存中,并受 work_mem 限制;位图扫描不会把位图溢出到临时文件。
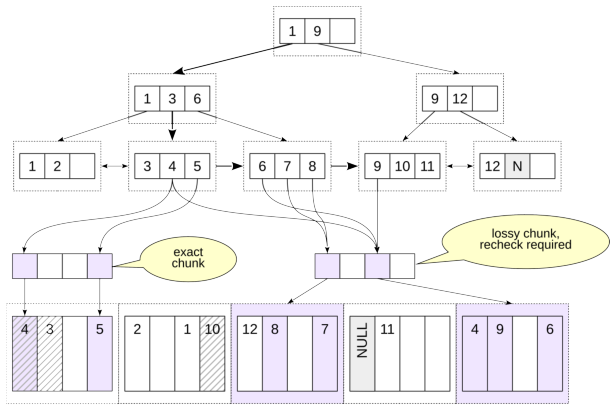
如果精确位图增长得太大,PostgreSQL 可以把其中一部分变成有损 位图项。精确项标识堆页中的单独元组偏移量;有损项只记住某个堆页可能包含匹配项。
图 3.8 精确位图项与有损位图项
当 work_mem 非常小而结果集非常大时,即使完全有损的位图也可能无法放入内存。在这个例外情况下,PostgreSQL 可以超出 work_mem 预算,分配足够的内存来表示所需的堆页。
有损位图块可以节省内存,但当 Bitmap Heap Scan 到达这样的块时,必须重新检查对应表页上每个行版本的条件。
有损块需要重新检查表页中每个行版本的条件,这会影响性能。如果两个位图被组合,而其中至少一个位图中的某个块是有损的,那么合并后的块也必须是有损的。因此,work_mem 的取值可能对位图扫描性能产生很大影响。
Bitmap Heap Scan 会显示重新检查条件(Recheck Cond)。条件并不总是重新检查,只有当位图无法放入内存而失去精度时才需要重新检查。
使用正常的内存设置:
EXPLAIN ( analyze , costs off , buffers off , timing off )
SELECT * FROM bookings WHERE total_amount < 5000 ;
QUERY PLAN
------------------------------------------------------------
Bitmap Heap Scan on bookings ( actual rows = 332628 . 00 loo ...
Recheck Cond : ( total_amount < '5000' :: numeric )
Heap Blocks : exact = 15839
-> Bitmap Index Scan on bookings_total_amount_idx ( ac ...
Index Cond : ( total_amount < '5000' :: numeric )
Index Searches : 1
Planning Time : 0 . 029 ms
Execution Time : 39 . 772 ms
( 8 rows ) Heap Blocks: exact=15839 告诉我们,所有堆页项都保持精确。
现在减少可用内存,再运行同一查询:
SET work_mem = '512kB' ;
EXPLAIN ( analyze , costs off , buffers off , timing off )
SELECT * FROM bookings WHERE total_amount < 5000 ;
QUERY PLAN
------------------------------------------------------------
Bitmap Heap Scan on bookings ( actual rows = 332628 . 00 loo ...
Recheck Cond : ( total_amount < '5000' :: numeric )
Rows Removed by Index Recheck : 1121673
Heap Blocks : exact = 7581 lossy = 8258
-> Bitmap Index Scan on bookings_total_amount_idx ( ac ...
Index Cond : ( total_amount < '5000' :: numeric )
Index Searches : 1
Planning Time : 0 . 053 ms
Execution Time : 84 . 084 ms
( 9 rows ) 现在有些堆页由有损位图项表示。Rows Removed by Index Recheck 显示 PostgreSQL 必须重新检查条件时,有多少候选行未通过该条件。
恢复设置:
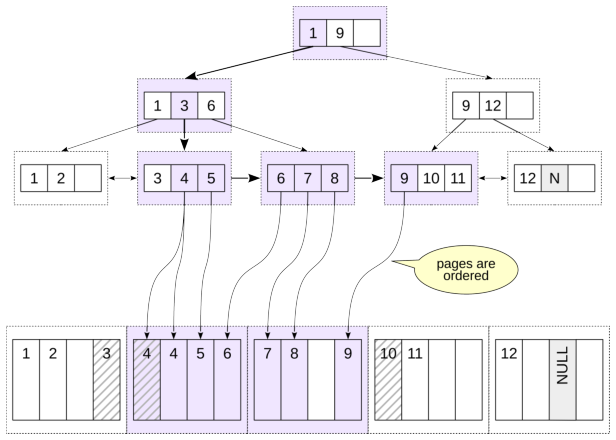
聚簇 当堆行与索引顺序在物理上相关时,普通索引扫描会变得有吸引力得多。
此时,相邻的索引项往往会指向同一个堆页或相邻堆页,因此扫描执行的随机堆访问会大幅减少。
当物理相关性非常高时,位图按页面分组的优势可能基本消失,规划器也许会偏好普通索引扫描。
图 3.9 按索引顺序聚簇堆行 CLUSTER 命令可以根据索引对表进行物理重写。最初,bookings 中的行并未按物理顺序排列,下面这条不带 ORDER BY 的查询可以说明这一点:
SELECT * FROM bookings LIMIT 10 ;
book_ref | book_date | total_amount
----------+-------------------------------+--------------
2 EW1SQ | 2025 - 09 - 01 03 : 00 : 12 . 557744 + 03 | 8125 . 00
3 ZY3O5 | 2025 - 09 - 03 03 : 25 : 35 . 278453 + 03 | 7500 . 00
756 UAS | 2025 - 09 - 10 19 : 24 : 02 . 978559 + 03 | 6325 . 00
GC7I6S | 2025 - 09 - 03 03 : 26 : 37 . 085293 + 03 | 18000 . 00
RBUUIQ | 2025 - 09 - 01 03 : 00 : 33 . 126206 + 03 | 13000 . 00
GB7E53 | 2025 - 09 - 10 18 : 58 : 23 . 948989 + 03 | 11000 . 00
6 TAS39 | 2025 - 09 - 01 03 : 00 : 06 . 265219 + 03 | 5000 . 00
UEX925 | 2025 - 09 - 03 03 : 27 : 39 . 815145 + 03 | 19550 . 00
GGY5EU | 2025 - 09 - 01 03 : 00 : 07 . 565193 + 03 | 5750 . 00
MS148V | 2025 - 09 - 03 03 : 29 : 12 . 70515 + 03 | 6750 . 00
( 10 rows ) 按照 total_amount 上的索引重新排列行。
我们在事务中执行代码,这样聚簇就不会影响后续命令:
BEGIN ;
CLUSTER bookings USING bookings_total_amount_idx ;
CLUSTER 现在,普通顺序读取恰好会按新的物理顺序遇到行:
SELECT * FROM bookings LIMIT 10 ;
book_ref | book_date | total_amount
----------+-------------------------------+--------------
7 ZHP9E | 2025 - 09 - 10 19 : 44 : 37 . 68484 + 03 | 1750 . 00
PZO1NI | 2025 - 11 - 12 03 : 45 : 47 . 817622 + 03 | 1750 . 00
6 BC1L3 | 2025 - 09 - 03 05 : 32 : 45 . 971723 + 03 | 1750 . 00
YQQ1XT | 2025 - 09 - 24 03 : 35 : 58 . 864739 + 03 | 1750 . 00
EQXEG8 | 2025 - 11 - 05 03 : 52 : 11 . 774956 + 03 | 1750 . 00
BS0GMN | 2025 - 09 - 17 03 : 36 : 35 . 340508 + 03 | 1750 . 00
9 HLHGP | 2026 - 02 - 18 04 : 09 : 04 . 979717 + 03 | 1750 . 00
SFR4P7 | 2025 - 10 - 15 03 : 37 : 58 . 510102 + 03 | 1750 . 00
XDD0AF | 2025 - 11 - 26 04 : 06 : 02 . 505752 + 03 | 1750 . 00
BKVSNB | 2025 - 10 - 02 07 : 44 : 39 . 551269 + 03 | 1750 . 00
( 10 rows )
ANALYZE bookings ;
EXPLAIN ( costs off )
SELECT * FROM bookings WHERE total_amount < 5000 ;
QUERY PLAN
--------------------------------------------------------
Index Scan using bookings_total_amount_idx on bookings
Index Cond : ( total_amount < '5000' :: numeric )
( 2 rows )
ROLLBACK ; 上面的 ANALYZE 会刷新统计信息,使规划器了解新的物理相关性。在聚簇之前,这个谓词使用位图扫描;相关性很强时,普通索引扫描的代价更低。最后的 ROLLBACK 将表恢复到后续示例所需的状态。
有两点实践因素很重要:
4. 覆盖索引
仅索引扫描 如果查询只需要索引中已有的值,那么对于该查询来说,这个索引就可以是覆盖索引 。
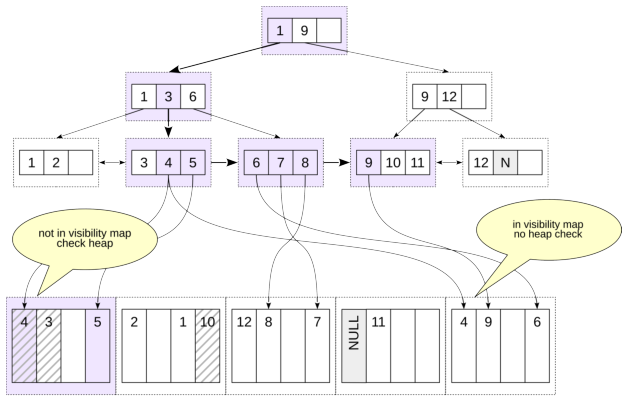
原则上,PostgreSQL 此时可以不访问堆就回答查询。MVCC 的可见性使事情变得复杂。B-树叶项会告诉 PostgreSQL 它引用的是哪个表元组,但索引项没有携带足够的可见性信息,无法证明该元组对当前快照可见。
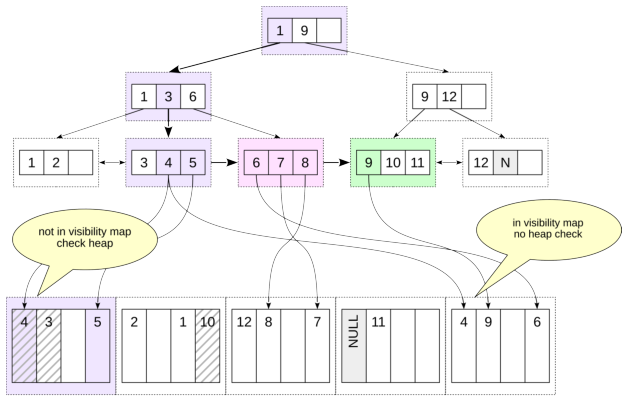
可见性映射 (visibility map)为已知全可见 (all-visible)的页面解决了这个问题。如果映射表明表页中的每个元组对所有事务都可见,那么仅索引扫描可以跳过从叶索引项跟随引用访问该堆页。
图 3.10 仅索引扫描与可见性映射 因此,清理活动对仅索引扫描很重要:必要时,更新和删除会清除全可见信息;清理在验证页面后可以再次设置全可见位。
规划器不知道未来确切会发生多少次堆获取。它在为仅索引扫描计算代价时,会使用关系统计信息,其中包括全可见页面所占比例的估计值。如果预计堆访问次数过多,规划器可能会认为另一种访问方法的代价更低。
对于每个匹配的索引项,执行器都会检查可见性映射。如果堆页是全可见的,就不需要访问堆;否则必须获取堆元组以检查可见性。即使需要访问部分堆页,这个计划节点仍然称为 Index Only Scan。
EXPLAIN ( analyze , buffers off , costs off , timing off )
SELECT total_amount
FROM bookings
WHERE total_amount > 200000 ;
                         QUERY PLAN
------------------------------------------------------------
 Index Only Scan using bookings_total_amount_idx on book...
   Index Cond: (total_amount > '200000'::numeric)
   Heap Fetches: 0
   Index Searches: 1
 Planning Time: 0.122 ms
 Execution Time: 0.148 ms
(6 rows)
Heap Fetches 显示为了进行可见性检查而需要获取多少个堆元组。这里可见性映射已经足够,因此不需要访问堆。
现在更新一行:
UPDATE bookings
SET total_amount = total_amount
WHERE book_ref = '00EV9A' ;
UPDATE 1 这次更新会清除受影响堆页的全可见状态。当匹配的索引项指向该页面时,执行器必须访问堆:
EXPLAIN ( analyze , buffers off , costs off , timing off )
SELECT total_amount
FROM bookings
WHERE total_amount > 200000 ;
QUERY PLAN
------------------------------------------------------------
Index Only Scan using bookings_total_amount_idx on book ...
Index Cond : ( total_amount > '200000' :: numeric )
Heap Fetches : 3
Index Searches : 1
Planning Time : 0 . 033 ms
Execution Time : 0 . 136 ms
( 6 rows )
执行器并没有扫描修改页面中的每个元组。相反,需要进行可见性检查的索引项触发了堆获取,因为该页面已经不能再被信任为全可见。
INCLUDE 索引 覆盖索引可以大幅降低查询代价,但把每个所需列都作为索引键 加入并不总是合适。例如:
PostgreSQL 允许通过 INCLUDE 子句让索引携带非键列 。
包含的值不参与搜索树的键语义。它们作为载荷存储在叶项中,因此仅索引扫描可以在不访问表的情况下返回这些值。
在 PostgreSQL 18 中,B-树、GiST 和 SP-GiST 索引都支持 INCLUDE。
INCLUDE 索引 和覆盖索引 不是同一个概念。一个索引可以在不使用 INCLUDE 的情况下覆盖特定查询;反过来,带有包含列的索引也可能无法覆盖另一个查询。
主键索引 tickets_pkey 包含 ticket_no,但不包含 book_ref,因此它对于这个查询不是覆盖索引:
EXPLAIN ( analyze , costs off , summary off )
SELECT ticket_no , book_ref
FROM tickets
WHERE ticket_no > '0005435990286' ;
QUERY PLAN
------------------------------------------------------------
Index Scan using tickets_pkey on tickets ( actual time = 0 ...
Index Cond : ( ticket_no > '0005435990286' :: text )
Index Searches : 1
Buffers : shared hit = 1496831 read = 23275 written = 17
Planning :
Buffers : shared hit = 46 read = 6
( 6 rows ) Buffers 行报告页面访问情况。这里,数量非常大的缓冲区命中反映了这样一个代价:对于索引中不存在的值,访问表仍然需要大量工作。创建一个以 book_ref 作为载荷的唯一索引:
CREATE UNIQUE INDEX ON tickets ( ticket_no )
INCLUDE ( book_ref );
CREATE INDEX
EXPLAIN ( analyze , costs off , summary off )
SELECT ticket_no , book_ref
FROM tickets
WHERE ticket_no > '0005435990286' ;
QUERY PLAN
------------------------------------------------------------
Index Only Scan using tickets_ticket_no_book_ref_idx on ...
Index Cond : ( ticket_no > '0005435990286' :: text )
Heap Fetches : 0
Index Searches : 1
Buffers : shared hit = 1 read = 8033
Planning :
Buffers : shared hit = 18 read = 1 dirtied = 1
( 7 rows ) 现在规划器选择了 Index Only Scan,并使用新建的索引。由于相关堆页都是Heap Fetches 为零,访问的页面数量也大幅减少。
由于通过 INCLUDE 加入的列不会被索引访问方法使用,INCLUDE 索引可以包含 B-树不支持的数据类型,例如几何类型或 xml。
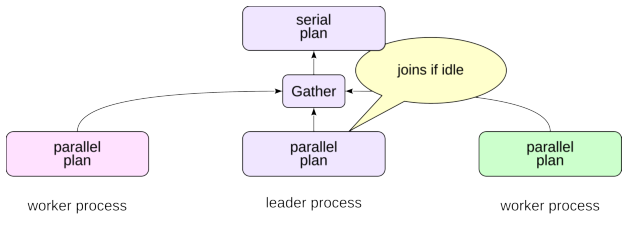
5. 并行访问 PostgreSQL 可以并行执行查询计划的部分内容。领导者 (leader)进程启动并行工作进程,后者执行计划中支持并行的部分。它们的输出由 Gather 或 Gather Merge 节点收集。
图 3.11 并行计划中的领导者与工作进程 领导者也可以参与执行并行计划,尤其是在它没有一直忙于从工作进程消费元组时。
启动工作进程、协调它们以及传输元组都有代价。因此,并行执行并不适用于每个查询。此外,只有部分计划节点和操作支持并行;计划的其余部分仍由领导者串行运行。
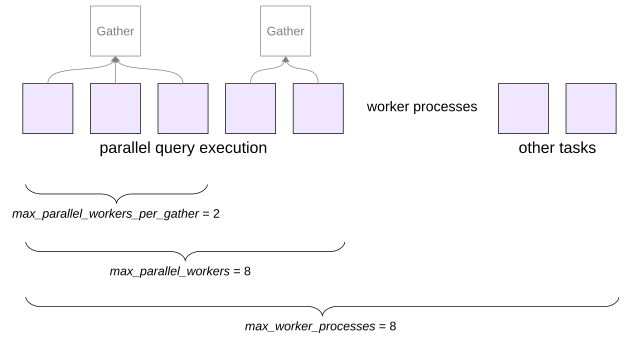
工作进程池限制 有几个配置参数会限制并行执行。
图 3.12 并行工作进程的限制 PostgreSQL 工作进程的用途并不局限于查询并行化。逻辑复制和扩展也可以使用后台工作进程。应用程序代码也可以使用工作进程;参见 DEV2 课程的“后台进程”一课。
max_worker_processes 限制可以处于活动状态的后台工作进程总数。其默认值为 8。
max_parallel_workers 限制服务器范围内可用于并行查询执行的工作进程数量。其默认值同样为 8。
max_parallel_workers_per_gather 限制一个领导者进程可以同时运行的工作进程数。其默认值为 2。
适当的取值取决于 CPU 能力、I/O 带宽、内存、工作负载以及并发会话数。
提高限制并不会让每个查询都更快;它只会改变规划器和执行器可以使用的并行工作量。
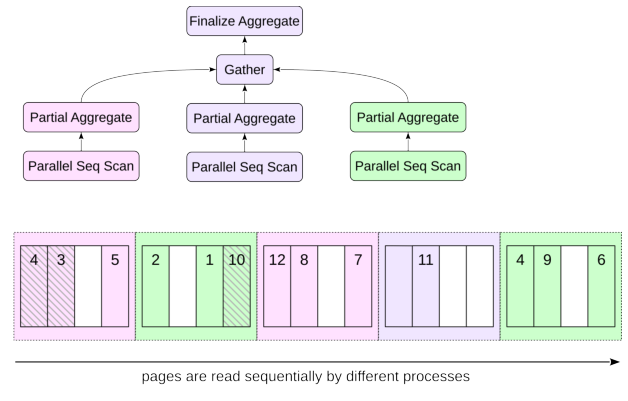
并行顺序扫描 Parallel Seq Scan 允许多个进程协作扫描一张表。
图 3.13 并行顺序扫描 这个名称并不矛盾。堆块仍然按顺序访问,就像普通的 Seq Scan 一样。区别在于,参与并行的进程会并发读取这些块。它们共享同一个并行扫描状态,以便彼此保持同步。
收益并不只是存储可以由多个进程读取。每个工作进程还会对收到的页面执行谓词计算和其他逐行 CPU 工作。当节省下来的执行时间超过启动工作进程、同步和元组传输的开销时,并行才会带来收益。聚合就是一个很好的例子,因为工作进程可以扫描并
在小表上,count(*) 以串行方式执行的代价更低:
EXPLAIN SELECT count ( * ) FROM seats ;
QUERY PLAN
------------------------------------------------------------
Aggregate ( cost = 31 . 76 .. 31 . 77 rows = 1 width = 8 )
-> Seq Scan on seats ( cost = 0 . 00 .. 27 . 41 rows = 1741 wid ...
( 2 rows ) Aggregate 必须读取全部输入后才能返回最终计数,因此它的启动代价接近总代价。
对大得多的 bookings 表运行同类查询:
EXPLAIN SELECT count ( * ) FROM bookings ;
QUERY PLAN
------------------------------------------------------------
Finalize Aggregate ( cost = 29807 . 83 .. 29807 . 84 rows = 1 wid ...
-> Gather ( cost = 29807 . 61 .. 29807 . 82 rows = 2 width = 8 )
Workers Planned : 2
-> Partial Aggregate ( cost = 28807 . 61 .. 28807 . 62 ro ...
-> Parallel Seq Scan on bookings ( cost = 0 . 00 ....
( 5 rows ) Gather 以下的所有内容都属于计划的并行部分。它由规划好的工作进程执行,领导者也可能执行这部分。Gather 以及其上方的节点在领导者中运行。
每个工作进程计算部分计数;领导者收集这些部分结果,然后由 Finalize Aggregate 产生最终值。
并非每个查询都能使用并行执行。例如,许多修改数据或锁定行的操作都不符合条件,而函数和其他操作的并行安全规则也可能
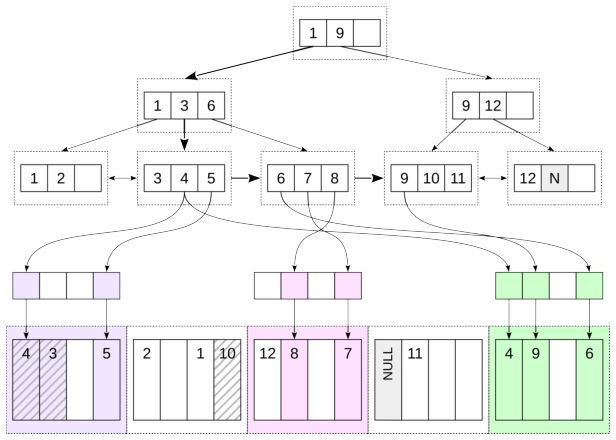
并行索引扫描和并行仅索引扫描 B-树索引访问也可以参与并行计划。
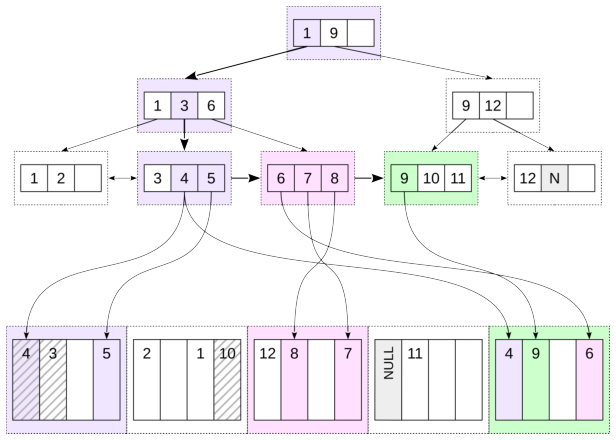
并行 B-树扫描分两个阶段工作。首先,领导者进程从树根下降到叶页。然后,工作进程并行读取叶索引页,沿着页面链移动。读取索引页的进程也会读取所需的表页。
图 3.14 并行索引扫描 多个进程可能需要读取同一个表页。图中展示了这种情况:最后一个表页包含由不同进程读取的多个索引页所引用的行。当然,缓冲区缓存中只会有该页面的一个副本。并行仅索引扫描的工作方式类似,只是
图 3.15 并行仅索引扫描 例如,统计上个月创建的预订:
EXPLAIN ( costs off )
SELECT count ( * )
FROM bookings
WHERE book_date > '2026-02-01 03:00:00+03' ;
QUERY PLAN
------------------------------------------------------------
Finalize Aggregate
-> Gather
Workers Planned : 2
-> Partial Aggregate
-> Parallel Index Only Scan using bookings_bo ...
Index Cond : ( book_date > '2026-02-01 03:0...
(6 rows) 其结构与前面的并行顺序扫描计划相似,但行是通过 Parallel Index Only Scan 获取的。
并行位图堆扫描 堆的位图访问也可以并行执行。
图 3.16 并行位图堆扫描 位图本身是串行构建的:领导者执行 Bitmap Index Scan,并构建共享的位图状态。
随后,工作进程可以通过 Parallel Bitmap Heap Scan 协作执行堆阶段。
统计最近三个月内创建且金额低于 5,000 的预订:
EXPLAIN ( costs off )
SELECT count ( * )
FROM bookings
WHERE total_amount < 5000
AND book_date > '2025-12-01 03:00:00+03' ;
                         QUERY PLAN
------------------------------------------------------------
 Finalize Aggregate
   -> Gather
       Workers Planned: 2
       -> Partial Aggregate
           -> Parallel Bitmap Heap Scan on bookings
               Recheck Cond: (total_amount < '5000'::num...
               Filter: (book_date > '2025-12-01 03:00:00...
               -> Bitmap Index Scan on bookings_total_am...
                   Index Cond: (total_amount < '5000'::n...
(9 rows)
领导者在 Bitmap Index Scan 中构建位图。位图选出的堆块由 Parallel Bitmap Heap Scan 并行处理。
移除示例中创建的索引:
DROP INDEX bookings_book_date_idx;
DROP INDEX bookings_total_amount_idx;
DROP INDEX tickets_ticket_no_book_ref_idx;
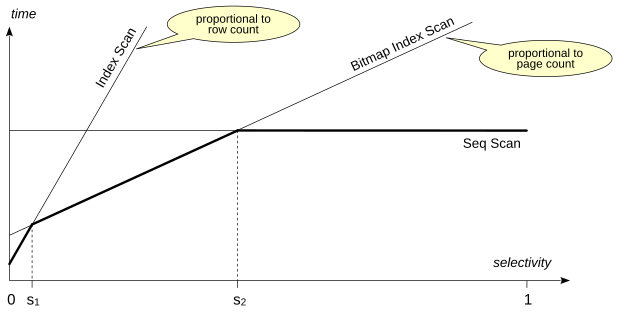
6. 比较访问方法 不存在一个普适的选择率阈值,能在该阈值处明确说明某种访问方法优于另一种;但总体模式很容易看出来。
当谓词筛选作用很强 时——只需要一行或表的一小部分——普通索引扫描最有吸引力。此时,导航索引并获取少量堆页的代价远小于扫描整个关系。
在中等选择率 下,位图扫描通常具有竞争力。它要支付构建位图的启动代价,但会
图 3.17 扫描代价与选择率 在低选择率 下,也就是大多数行都能通过谓词时,顺序扫描通常最好。除了读取大部分堆之外再读取索引只会增加工作。在旋转磁盘上,这种效果更明显,因为随机读取远慢于读取物理位置连续的页面。
交叉点高度依赖于表、索引、物理相关性、行宽、缓存状态、存储、规划器代价参数以及具体查询。规划器会综合这些估计,而不是采用固定的“低于 X% 就使用索引”规则。
还有一个因素是排序。B-树索引扫描按索引顺序交付行,因此可以避免单独的排序。这可能使它很有吸引力,即使它原始的行访问代价并不是最低的。
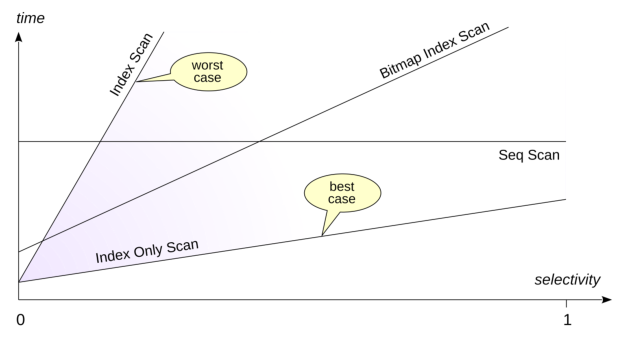
图 3.18 仅索引扫描的最佳与最坏情况 仅索引扫描的性能很大程度上取决于可见性映射,以及有多少堆页是全可见的。
因此,规划器在计算仅索引访问的代价时,会纳入全可见页面比例的估计值。
参考资源 4 排序与分组了解 PostgreSQL 18 中的内存排序、外部排序和增量排序、哈希聚合、有序数据分组以及窗口帧。
1. 排序 B-树索引可以按索引顺序产生行。当这个顺序与查询的 ORDER BY 相匹配时,PostgreSQL 有时可以避免显式排序:
EXPLAIN ( costs off )
SELECT * FROM flights
ORDER BY flight_id ;
QUERY PLAN
------------------------------------------
Index Scan using flights_pkey on flights
( 1 row ) 如果访问路径无法提供所需的排序,PostgreSQL 就需要两个独立的步骤:获取行,再对行排序。
EXPLAIN ( costs off )
SELECT * FROM flights
ORDER BY status ;
QUERY PLAN
--------------------------
Sort
Sort Key : status
-> Seq Scan on flights
( 3 rows )
内存排序 最简单的情况是,要排序的数据能够放进 work_mem 为排序操作提供的内存中。此时 PostgreSQL 可以在内存中完成排序。EXPLAIN ANALYZE 会显示排序方法和使用的内存量:
EXPLAIN ( analyze , timing off , summary off , buffers off )
SELECT *
FROM seats
ORDER BY seat_no ;
QUERY PLAN
------------------------------------------------------------
Sort ( cost = 121 . 13 .. 125 . 48 rows = 1741 width = 15 ) ( actual ...
Sort Key : seat_no
Sort Method : quicksort Memory : 103 kB
-> Seq Scan on seats ( cost = 0 . 00 .. 27 . 41 rows = 1741 wid ...
( 4 rows ) 普通的 Sort 节点必须读取并排序完输入后才能返回第一行。因此,它的启动代价包括读取完整输入的代价。对于比较排序,典型的工作量按 O ( M log M ) O(M \log M) O ( M log M )
如果查询只需要排序结果中的前 N 行,例如因为使用了 LIMIT,PostgreSQL 可以使用有界的前 N 排序,而不必完整排序每一行:
EXPLAIN ( analyze , timing off , summary off , buffers off )
SELECT *
FROM seats
ORDER BY seat_no
LIMIT 100 ;
                         QUERY PLAN
------------------------------------------------------------
 Limit  (cost=93.95..94.20 rows=100 width=15) (actual ro...
   -> Sort  (cost=93.95..98.30 rows=1741 width=15) (actu...
       Sort Key: seat_no
       Sort Method: top-N heapsort  Memory: 30kB
       -> Seq Scan on seats  (cost=0.00..27.41 rows=1741...
(5 rows)
估计的查询代价更低,排序使用的内存也更少。前 N 堆排序的工作量按 O ( M log N ) O(M \log N) O ( M log N )
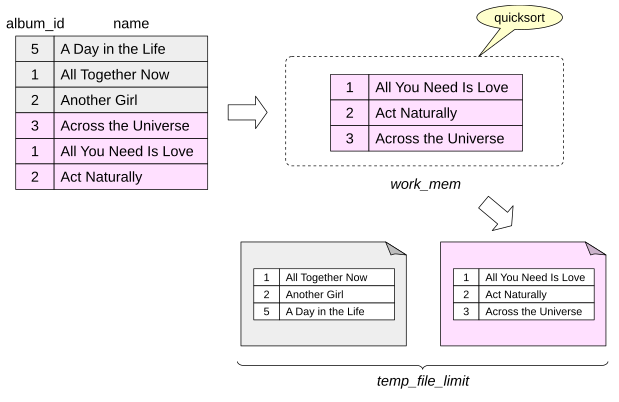
外部排序 如果数据集过大,无法在可用内存中完成排序,PostgreSQL 就会使用外部排序。
排序器会在内存所能处理的范围内读取尽可能多的输入,将这部分数据排序,然后把排好序的有序段 (run)写入临时文件。
图 4.1 外部排序:写入有序段
这个过程会重复进行,直到所有输入都被转换为各自有序的有序段。
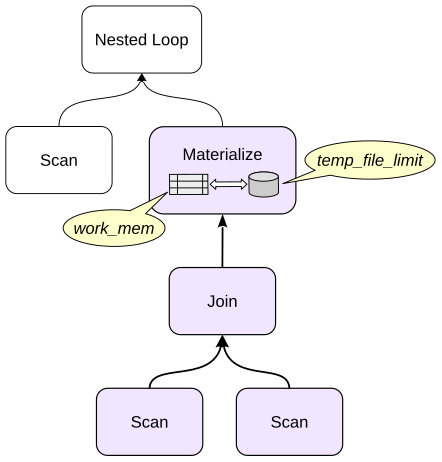
temp_file_limit 限制 PostgreSQL 进程所属临时文件在任一时刻使用的总空间。显式临时表不计入这个限制。
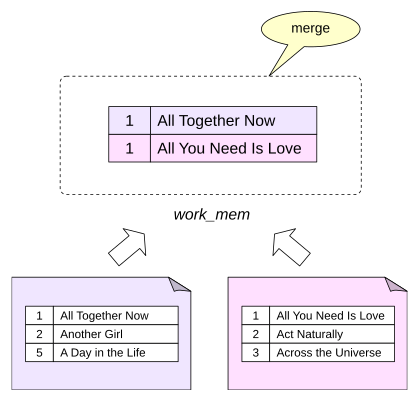
然后合并这些有序段。从概念上看,归并过程会跟踪每个输入有序段的下一个候选值,选择其中最小或最大的一个,将它返回,然后推进对应的有序段。实际实现会以带缓冲的块读取数据,而不是逐行读取,这样可以保持 I/O 效率。
图 4.2 外部排序:合并有序段 如果内存不足以在一趟中合并所有有序段,PostgreSQL 会执行多趟归并:先把多个有序段分组并合并成更大的有序段,再继续合并,直到能够产生最终的有序流。大型排序会在 EXPLAIN ANALYZE 中显示临时存储的使用情况:
EXPLAIN ( analyze , timing off , summary off )
SELECT *
FROM bookings
ORDER BY total_amount ;
QUERY PLAN
------------------------------------------------------------
Sort ( cost = 406880 . 90 .. 413097 . 68 rows = 2486710 width = 21 )...
Sort Key : total_amount
Sort Method : external merge Disk : 78176 kB
Buffers : shared read = 15856 , temp read = 19539
written = 19578
-> Seq Scan on bookings ( cost = 0 . 00 .. 40723 . 10 rows = 24 ...
Buffers : shared read = 15856
Planning :
Buffers : shared hit = 34 read = 2 dirtied = 1
( 9 rows ) Sort Method: external merge 告诉我们排序溢出到了磁盘。Disk 值报告排序使用的临时磁盘空间,而临时缓冲区计数器显示临时 I/O。
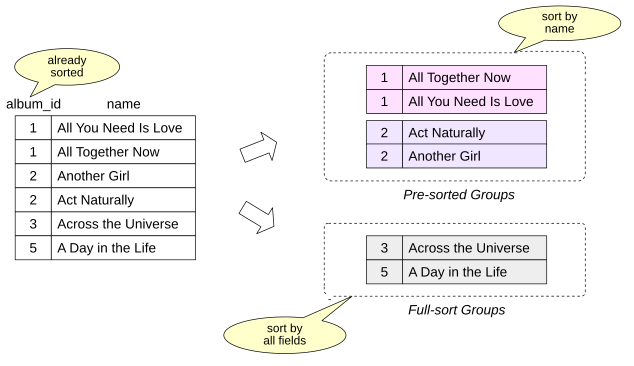
增量排序 假设查询要求按 K 1 , … , K m , … , K n K_1,\ldots,K_m,\ldots,K_n K 1 , … , K m , … , K n K 1 , … , K m K_1,\ldots,K_m K 1 , … , K m K m + 1 , … , K n K_{m+1},\ldots,K_n K m + 1 , … , K n 增量排序 。
增量排序可以减少内存需求和溢出到磁盘的可能性,因为每次排序只处理输入中较小的一部分。它还具有延迟优势:第一个组完成排序后,PostgreSQL 就可以开始返回行,不必等待整个输入排序完成。
图 4.3 增量排序 代价是识别和处理大量组会带来额外开销。
PostgreSQL 在内部使用两种策略。共享相同预排序前缀的较大组可以分别排序。较小的组可以先累积起来,再一起进行完整排序,以避免每个组都产生过高的处理开销。
可以使用 enable_incremental_sort 禁用增量排序。
在 bookings.total_amount 上创建一个索引:
CREATE INDEX ON bookings ( total_amount ); 现在增大 work_mem,并按 total_amount 和 book_date 排序:
SET work_mem = '8 MB' ;
EXPLAIN ( analyze , costs off , timing off , buffers off )
SELECT *
FROM bookings
ORDER BY total_amount , book_date ;
                         QUERY PLAN
------------------------------------------------------------
 Incremental Sort (actual rows=2486710.00 loops=1)
   Sort Key: total_amount, book_date
   Presorted Key: total_amount
   Full-sort Groups: 3132  Sort Method: quicksort
   Average Memory: 27kB  Peak Memory: 27kB
   Pre-sorted Groups: 2449  Sort Method: quicksort
   Average Memory: 6442kB  Peak Memory: 6464kB
   -> Index Scan using bookings_total_amount_idx on book...
       Index Searches: 1
 Planning Time: 0.128 ms
 Execution Time: 934.215 ms
(11 rows)
索引扫描已经提供了按 total_amount 排序的行,这一点由 Presorted Key 表示。Incremental Sort 只需要建立按 book_date 排序的剩余顺序。
Pre-sorted Groups 描述使用已有 total_amount 顺序处理、再按 book_date 进一步排序的较大组。Full-sort Groups 描述合并后作为完整组排序的较小组。
在这个例子中,两类组都完全放入内存,并使用快速排序。
现在减少 work_mem:
再次运行查询:
EXPLAIN ( analyze , costs off , timing off , buffers off )
SELECT *
FROM bookings
ORDER BY total_amount , book_date ;
                         QUERY PLAN
------------------------------------------------------------
 Incremental Sort (actual rows=2486710.00 loops=1)
   Sort Key: total_amount, book_date
   Presorted Key: total_amount
   Full-sort Groups: 3132  Sort Method: quicksort
   Average Memory: 27kB  Peak Memory: 27kB
   Pre-sorted Groups: 2449  Sort Method: external merge
   Average Disk: 2662kB  Peak Disk: 2672kB
   -> Index Scan using bookings_total_amount_idx on book...
       Index Searches: 1
 Planning Time: 0.044 ms
 Execution Time: 912.199 ms
(11 rows) 内存减少后,较大的预排序组现在使用外部归并处理,EXPLAIN 也明确报告了它们使用的临时磁盘空间。
恢复设置并移除演示索引:
RESET work_mem;
DROP INDEX bookings_total_amount_idx;
构建 B-树 原则上,PostgreSQL 可以从一棵空树开始,在扫描表时逐个插入索引项,以此构建 B-树索引。对于批量索引构建,这种方式效率很低。
相反,PostgreSQL 会先生成索引项,按索引键对它们排序,再依次填充叶级,随后逐层构建上层,直到只剩下根节点。这里使用的排序机制与上面讨论的排序密切相关,但创建索引使用的是 maintenance_work_mem,而不是普通的 work_mem。维护操作相对不频繁,
B-树索引构建也可以并行运行。工作进程数量的选择方式与并行查询相同,会根据表的大小决定,但受 max_parallel_maintenance_workers 限制。
对于并行索引构建,maintenance_work_mem 适用于整个构建过程,而不是分别适用于每个工作进程。
2. 分组
分组出现在哪里 SQL 可以使用 GROUP BY 把行划分为多个组。聚合函数通常与这些组一起使用,为每个组计算一个结果。窗口函数通过 PARTITION BY 也有相关概念,但与普通分组不同,窗口函数不会把分区中的行压缩成一行结果。
当必须删除重复项时,也会隐式出现分组,例如使用:DISTINCT;不带 ALL 的 UNION;不带 ALL 的 INTERSECT;不带 ALL 的 EXCEPT。PostgreSQL 可以使用不同的物理策略执行分组和重复消除。
其中两个重要策略是哈希,以及按分组键顺序处理数据。规划器会根据估计代价、内存、下层计划节点已经提供的排序以及查询的其他属性,在可用方案中进行选择。
哈希聚合 哈希表使用哈希函数把值映射到有限数量的桶中。查找时:
计算哈希值。
使用哈希值的一部分选择一个桶。
检查桶中的条目,并使用相等比较来区分哈希值或桶分配发生冲突的值。
在负载因子合理且分布良好的情况下,查找预计只需要近似常数时间。分布不佳或哈希表过载会增加处理冲突的工作量。
图 4.4 哈希聚合 基于哈希的聚合使用的计划节点是 HashAggregate:
EXPLAIN
SELECT airplane_code , count ( * )
FROM seats
GROUP BY airplane_code ;
QUERY PLAN
------------------------------------------------------------
HashAggregate ( cost = 36 . 12 .. 36 . 20 rows = 8 width = 12 )
Group Key : airplane_code
-> Seq Scan on seats ( cost = 0 . 00 .. 27 . 41 rows = 1741 wid ...
( 3 rows ) 启动代价很高,因为 HashAggregate 必须读取输入并构建聚合状态,然后才能产生最终的分组。
EXPLAIN ANALYZE 会显示内存使用情况:
EXPLAIN ( analyze , timing off , costs off , buffers off )
SELECT airplane_code , count ( * )
FROM seats
GROUP BY airplane_code ;
QUERY PLAN
------------------------------------------------------
HashAggregate ( actual rows = 8 . 00 loops = 1 )
Group Key : airplane_code
Batches : 1 Memory Usage : 32 kB
-> Seq Scan on seats ( actual rows = 1741 . 00 loops = 1 )
Planning Time : 0 . 021 ms
Execution Time : 0 . 424 ms
( 6 rows )
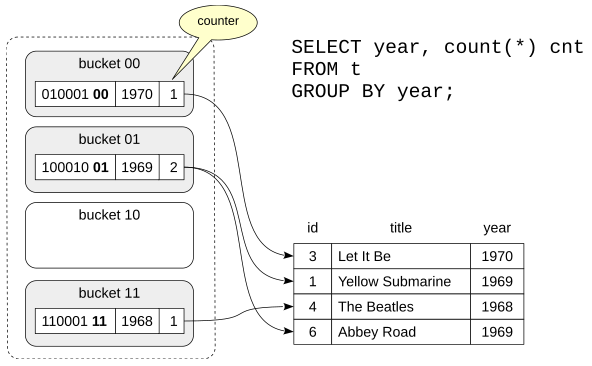
对有序数据分组 重复消除和分组也可以利用按分组键顺序到达的行。
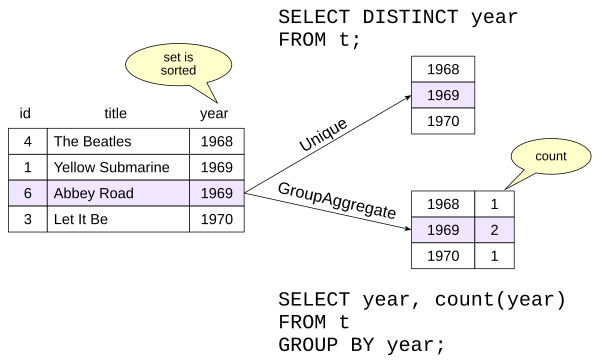
图 4.5 对有序数据分组 Unique 会删除相邻的重复项。由于相等的键彼此相邻,它只需把当前值与前一个值比较。
GroupAggregate 节点返回聚合数据。在图中的例子里,该节点建立 year 字段的非重复值列表,并计算数据集中每个值出现的次数。
当输入已经具有所需的顺序时,Unique 或 GroupAggregate 可能很有吸引力,因为它们只需要相对少量的工作内存,并且可以增量处理数据流。当输入必须先完整排序时,哈希聚合往往代价更低,不过规划器会根据实际估计值做决定,而不是遵循固定规则。
这些节点会保留分组键的顺序,因此有时可以在后续 ORDER BY 中避免再次排序。
下面是一个输入顺序直接来自索引的 GroupAggregate:
EXPLAIN ( costs off )
SELECT ticket_no , count ( ticket_no )
FROM segments
GROUP BY ticket_no ;
QUERY PLAN
------------------------------------------------------
GroupAggregate
Group Key : ticket_no
-> Index Only Scan using segments_pkey on segments
( 3 rows ) DISTINCT 查询可以使用 Unique:
EXPLAIN ( costs off )
SELECT DISTINCT ticket_no
FROM segments
ORDER BY ticket_no ;
QUERY PLAN
------------------------------------------------------
Unique
-> Index Only Scan using segments_pkey on segments
( 2 rows ) 索引已经按 ORDER BY 所需的顺序产生 ticket_no,而 Unique 会保留这个顺序,因此不需要额外的 Sort 节点。
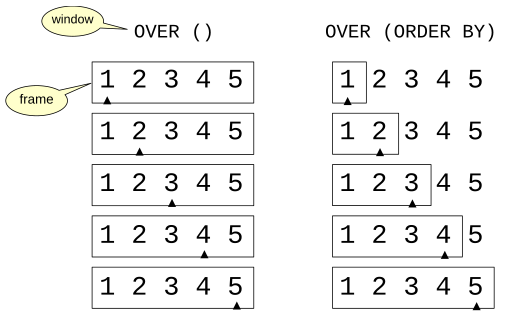
窗口函数 与普通聚合函数不同,窗口函数为每个输出行计算一个值,而不是把一个组缩减为一行。在函数名之后,OVER 子句指定一个窗口 :一条规则,用来确定对于每个结果行,窗口帧 (frame)。
图 4.6 有序与无序时的窗口帧 使用 OVER () 时,没有 PARTITION BY,也没有 ORDER BY。因此这里只有一个包含所有行的分区,默认帧就是整个分区。
如果窗口定义包含用于排列行的 ORDER BY 子句,默认窗口帧会覆盖从第一行到当前行的行。
考虑一个预订金额的累计和:
EXPLAIN
SELECT * , sum ( total_amount ) OVER ( ORDER BY book_date )
FROM bookings ;
QUERY PLAN
------------------------------------------------------------
WindowAgg ( cost = 406880 . 92 .. 450398 . 33 rows = 2486710 widt ...
Window : w1 AS ( ORDER BY book_date )
-> Sort ( cost = 406880 . 90 .. 413097 . 68 rows = 2486710 widt ...
Sort Key : book_date
-> Seq Scan on bookings ( cost = 0 . 00 .. 40723 . 10 row ...
( 5 rows )
窗口函数由 WindowAgg 计算。在这里,它的子节点 Sort 建立窗口所需的顺序。排序可以使用任何合适的排序策略。较小的输入可以留在内存中:
EXPLAIN ( analyze , timing off , summary off , buffers off )
SELECT * , count ( * ) OVER ( ORDER BY seat_no )
FROM seats ;
QUERY PLAN
------------------------------------------------------------
WindowAgg ( cost = 121 . 18 .. 151 . 59 rows = 1741 width = 23 ) ( ac ...
Window : w1 AS ( ORDER BY seat_no )
Storage : Memory Maximum Storage : 17 kB
-> Sort ( cost = 121 . 13 .. 125 . 48 rows = 1741 width = 15 ) ( ac ...
Sort Key : seat_no
Sort Method : quicksort Memory : 103 kB
-> Seq Scan on seats ( cost = 0 . 00 .. 27 . 41 rows = 1741 ...
( 7 rows ) 较大的输入可能需要外部排序:
EXPLAIN ( analyze , timing off , summary off , buffers off )
SELECT * , sum ( total_amount ) OVER ( ORDER BY book_date )
FROM bookings ;
QUERY PLAN
------------------------------------------------------------
WindowAgg ( cost = 406880 . 92 .. 450398 . 33 rows = 2486710 widt ...
Window : w1 AS ( ORDER BY book_date )
Storage : Memory Maximum Storage : 17 kB
-> Sort ( cost = 406880 . 90 .. 413097 . 68 rows = 2486710 widt ...
Sort Key : book_date
Sort Method : external merge Disk : 75760 kB
-> Seq Scan on bookings ( cost = 0 . 00 .. 40723 . 10 row ...
( 7 rows ) 对于使用内部行存储的节点,例如 WindowAgg、CTE Scan 或 Recursive Union,Storage 行显示使用的最大存储量及其类型:当数据能放入内存时为 Memory,使用临时文件时为 Disk。
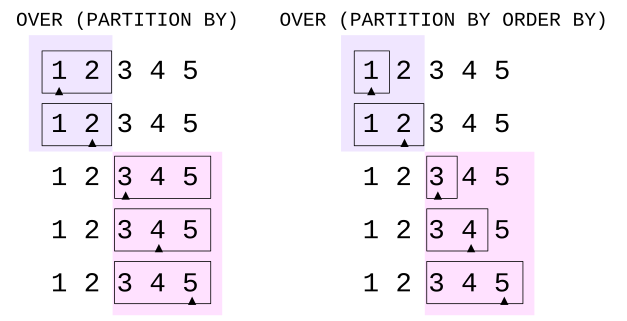
图 4.7 分区中的窗口帧 PARTITION BY 把输入划分为相互独立的行组。对于每个组,窗口帧的边界都会在该组内部变化。如果没有另行指定,窗口帧覆盖整个组。
如果窗口定义还包含 ORDER BY,行会按相应顺序处理。此时,窗口帧覆盖从第一行到当前行的行。
与普通的 GROUP BY 不同,PARTITION BY 总是使用排序:计划会保证 WindowAgg 节点接收到的行,先按 PARTITION BY 键排序,再按 ORDER BY 键排序。即使没有 ORDER BY 子句,也不会使用哈希。
5 连接方法比较嵌套循环、哈希和归并连接,了解 Memoize 缓存、哈希批次、并行连接计划以及连接顺序选择。
1. 什么是连接方法 使用前几章讨论的访问方法获取行,只是工作的一部分。我们还需要组合行集。
连接方法是组合两个行集的一种算法。PostgreSQL 不仅使用这些算法实现 SQL JOIN 操作,也用它们实现其他 SQL 结构,例如 EXISTS。这里有两个不同的层次:SQL 连接 是一种逻辑操作,用来定义哪些行属于结果;连接方法 则是高效产生该结果的一种可能的物理算法。
我们经常说 PostgreSQL 连接表。这是一种方便的简写,但执行器实际连接的是行集。行集可以通过访问方法直接来自表,也可以是另一个连接、聚合、子查询或其他计划子树的结果。
连接是二元的:每个连接节点组合两个输入。对于普通内连接,多个关系的连接顺序通常不会改变逻辑结果,但可能显著改变性能。一个物理连接的两个输入顺序也可能影响性能。
PostgreSQL 有三种主要连接方法:嵌套循环、哈希连接和归并连接。
2. 嵌套循环连接 基本的嵌套循环算法很简单:对于一个输入中的每一行,扫描另一个输入,并返回匹配的行。从概念上看,它就是两个嵌套循环,因此得名。
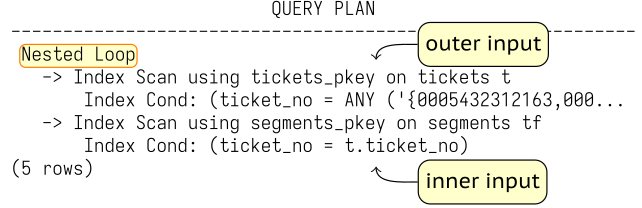
第一个输入通常称为外部 输入(outer input),第二个输入称为内部 输入(inner input)。当 PostgreSQL 可以使用当前外部行中的值,在内部输入中执行廉价查找时,嵌套循环尤其有吸引力。索引就是典型例子。如果内部一侧必须针对每个外部行从头到尾扫描,那么可能会多次检查同一批无关的行。
对于非常小的输入,即使重复扫描也可能很便宜。下面是一个小结果集的典型嵌套循环计划。我们查找属于两张机票的航段:
EXPLAIN ( costs off ) SELECT *
FROM tickets t
JOIN segments tf ON tf . ticket_no = t . ticket_no
WHERE t . ticket_no IN ( '0005432312163' , '0005432312164' );
QUERY PLAN
------------------------------------------------------------
Nested Loop
-> Index Scan using tickets_pkey on tickets t
Index Cond : ( ticket_no = ANY ( '{0005432312163,000...
-> Index Scan using segments_pkey on segments tf
Index Cond: (ticket_no = t.ticket_no)
(5 rows) 说明
外部输入:tickets t 上的 Index Scan。内部输入:segments tf 上的 Index Scan。
图 5.1 嵌套循环连接 这是一个参数化 嵌套循环。外部 Index Scan 产生一行机票数据。该行中的 t.ticket_no 值会成为对 segments 执行内部 Index Scan 时的一个参数。在每次迭代中,内部查找实际上会使用类似 ticket_no = 常量的条件执行。
这个过程会持续到外部输入耗尽。
现在考虑另一个嵌套循环。我们列出航程足以覆盖两个所需距离的飞机:
EXPLAIN ( costs off ) SELECT *
FROM ( VALUES ( 1000 ), ( 10000 ) ) d ( range )
JOIN airplanes a ON a . range >= d . range ;
QUERY PLAN
-------------------------------------------------
Nested Loop
Join Filter : ( ml . range >= "*VALUES*" . column1 )
-> Seq Scan on airplanes_data ml
-> Materialize
-> Values Scan on "*VALUES*"
( 5 rows ) 这个连接不是参数化的 。内部输入没有使用从当前外部行推导出的访问条件。相反,内部行集会被反复读取,并由 Join Filter 检查行对。Materialize 保留很小的 VALUES 结果,以便重复扫描,因此 PostgreSQL 不必在每次迭代时都从头构造它。从概念上说,这是先做笛卡尔积,再进行过滤。
嵌套循环不要求存在相等条件。它基本上可以实现 PostgreSQL 能够计算的任何连接谓词。
Memoize 如果参数化的内部查找会以相同的参数值执行很多次,重复完成相同工作就很浪费。PostgreSQL 可以把结果缓存在放置于内部计划之上的 Memoize 节点中。
如果规划器的估计错误地表明记忆化(memoization)有益,可以使用 enable_memoize = off 将其禁用。
考虑 routes 和 airports 之间的连接:
EXPLAIN ( analyze , costs off , timing off , buffers off )
SELECT * FROM routes r
JOIN airports a ON a . airport_code = r . departure_airport
WHERE r . departure_airport in ( 'BOM' , 'SVO' );
QUERY PLAN
------------------------------------------------------------
Nested Loop ( actual rows = 108 . 00 loops = 1 )
-> Bitmap Heap Scan on routes r ( actual rows = 108 . 00 l ...
Recheck Cond : ( departure_airport = ANY
( '{BOM,SVO}' :: bpchar []))
Heap Blocks : exact = 33
-> Bitmap Index Scan on routes_departure_airport_ ...
Index Cond : ( departure_airport = ANY
( '{BOM,SVO}' :: bpchar []))
Index Searches : 2
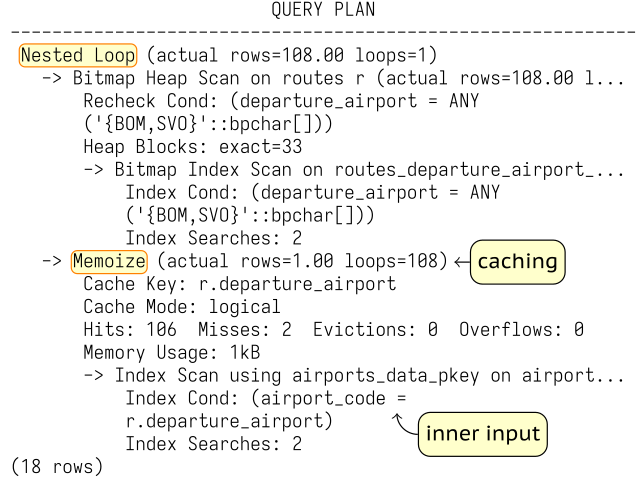
-> Memoize ( actual rows = 1 . 00 loops = 108 )
Cache Key : r . departure_airport
Cache Mode : logical
Hits : 106 Misses : 2 Evictions : 0 Overflows : 0
Memory Usage : 1 kB
-> Index Scan using airports_data_pkey on airport ...
Index Cond : ( airport_code =
r . departure_airport )
Index Searches : 2
( 18 rows ) 说明
缓存:Memoize。内部输入:airports_data 上的 Index Scan。
图 5.2 Memoize 这个例子经过有意选择,使得只有两个非重复的参数值到达内部一侧:BOM 和 SVO。
每个值的第一次查找都会发生缓存未命中:Misses: 2。
其余 106 次查找都由缓存提供:Hits: 106。
没有条目需要被驱逐(Evictions: 0),没有缓存结果溢出其空间(Overflows: 0),缓存只使用了 1 kB。
在内部,缓存以内部扫描的参数值为键。如果外部一侧重复使用相同的键,Memoize
执行代价 一个好的第一近似是 N × cost ( inner probe ) N \times \operatorname{cost}(\text{inner probe}) N × cost ( inner probe ) O ( N × M ) O(N \times M) O ( N × M )
不过,对于参数化嵌套循环,一次内部探测的代价可能远小于扫描 M 行的代价。例如,唯一 B-树查找经过一次很短的树下降后,至多可以找到一个匹配行。重复探测也可能受益于缓存或 Memoize。
当外部输入很小,并且内部输入的行可以廉价访问时,嵌套循环连接很有效。特别是,这种方法与索引访问结合使用,是 OLTP 查询的典型方式,适合快速返回少量行。
并行计划中的嵌套循环 嵌套循环可以参与并行计划。
多个工作进程会并行扫描外部行集。每个工作进程接收一些外部行,并独立执行相应的内部扫描。
查找与低价航段关联的机票:
EXPLAIN ( costs off )
SELECT t . ticket_no , s . price
FROM tickets t
JOIN segments s ON s . ticket_no = t . ticket_no
WHERE s . price < 1000 ;
                        QUERY PLAN
----------------------------------------------------------
 Gather
   Workers Planned: 2
   -> Nested Loop
       -> Parallel Seq Scan on segments s
           Filter: (price < '1000'::numeric)
       -> Index Only Scan using tickets_pkey on tickets t
           Index Cond: (ticket_no = s.ticket_no)
(7 rows)
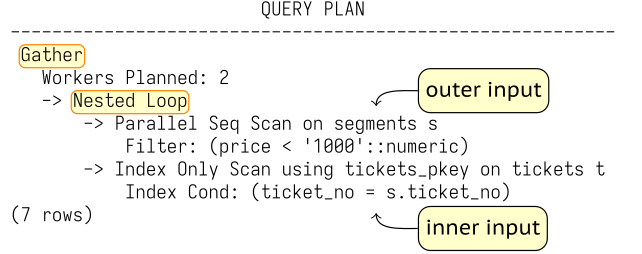
说明
外部输入:segments s 上的 Parallel Seq Scan。内部输入:tickets t 上的 Index Only Scan。
图 5.3 并行计划中的嵌套循环 每个参与的进程都会扫描 segments 的一部分。对于每个符合条件的航段,它都会在 tickets 中执行一次自己的仅索引查找。内部一侧不会因为外部扫描是并行的就自动共享;每个进程都会为分配给它的外部行执行内部计划。
3. 哈希连接
单批次哈希连接 在构建阶段 (build phase),PostgreSQL 读取内部行,并根据连接键计算哈希值。
内存中的哈希表保存连接在后续阶段所需的数据:哈希值,以及连接本身或其上方节点所需的内部行投影数据。
哈希操作的内存预算基于 work_mem × hash_mem_multiplier。
对于串行哈希连接,最佳情况是完整哈希表能够放进这个预算。在这种情况下,EXPLAIN ANALYZE 会报告 Batches: 1。
在探测阶段 (probe phase),PostgreSQL 按顺序读取外部输入。对于每个外部行,它计算相应的哈希值,定位候选桶,然后检查实际的连接条件。
仅检查哈希码是不够的。首先,查询中的并非所有连接条件都能用于哈希连接:由于哈希函数不保持值的顺序,哈希连接只支持等值连接。其次,冲突是可能发生的,不同的值可能得到相同的哈希码。发生冲突的概率很小,但不能排除。
下面的例子需要两个输入的大部分内容,因此哈希连接是自然的选择:
EXPLAIN ( costs off )
SELECT *
FROM airplanes a
JOIN seats s ON a . airplane_code = s . airplane_code ;
QUERY PLAN
---------------------------------------------------
Hash Join
Hash Cond : ( s . airplane_code = ml . airplane_code )
-> Seq Scan on seats s
-> Hash
-> Seq Scan on airplanes_data ml
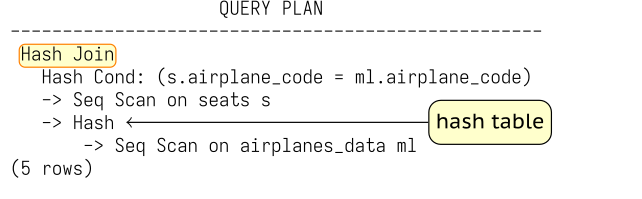
( 5 rows ) 说明
哈希表:airplanes_data 上的 Seq Scan 之上的 Hash 节点。
图 5.4 单批次哈希连接 Hash Join 首先请求其 Hash 子节点读取内部输入并构建哈希表。然后它读取外部输入并探测该表,在找到匹配项时返回它们。
运行查询:
EXPLAIN ( analyze , costs off , timing off , buffers off )
SELECT *
FROM airplanes a
JOIN seats s ON a . airplane_code = s . airplane_code ;
                         QUERY PLAN
------------------------------------------------------------
 Hash Join (actual rows=1741.00 loops=1)
   Hash Cond: (s.airplane_code = ml.airplane_code)
   -> Seq Scan on seats s (actual rows=1741.00 loops=1)
   -> Hash (actual rows=10.00 loops=1)
       Buckets: 1024  Batches: 1  Memory Usage: 10kB
       -> Seq Scan on airplanes_data ml (actual rows=10....
 Planning Time: 0.047 ms
 Execution Time: 1.255 ms
(8 rows)
哈希表可以放进内存。它使用 1024 个桶,约占 10 kB。规划器选择小得多的 airplanes_data 输入作为构建侧。
规划器选择小得多的 airplanes_data 输入作为构建侧。
多批次哈希连接 如果规划器估计哈希表无法放进大小为 work_mem × hash_mem_multiplier 的内存中,就会把内部输入划分成多个批次 ,分别处理每个批次。和桶的数量一样,批次的数量总是 2 的幂;批次编号由哈希值中的若干位决定。可能彼此匹配的行总是属于同一个批次。理想情况下,每个批次包含大致相同数量的行,但如果行中的值重复,就可能出现偏斜。
规划查询时,会预先计算所需的最小批次数,以便每个批次的哈希表都能放入内存。即使规划器的估计后来被证明过于保守,这个数量也不会
首先,PostgreSQL 读取内部输入并构建哈希表。属于第一个批次的行保留在内存中。属于其他批次的行则写入不同的临时文件。
然后 PostgreSQL 读取外部输入。属于第一个批次的行会立即与内存中的第一个哈希表批次匹配。属于其他批次的行会写入不同的临时文件。因此,对于 N 个批次,最多会使用 2 ( N − 1 ) 2(N-1) 2 ( N − 1 )
会话中临时文件使用的磁盘空间受 temp_file_limit 的值限制;临时表不包含在这个限制中。
之后,哈希表占用的内存会被释放。此时,连接已经得到第一个批次的部分结果。
接着 PostgreSQL 逐个处理保存在磁盘上的批次。它从临时文件把某个批次的内部行加载进哈希表,从另一个临时文件读取匹配的外部行,然后将它们连接起来。已经处理过的临时文件会被删除。这个过程会重复,直到所有批次都完成连接。
连接 bookings 和 tickets 这两张大表:
EXPLAIN ( analyze , costs off , timing off , summary off )
SELECT *
FROM bookings b
JOIN tickets t ON b . book_ref = t . book_ref ;
                         QUERY PLAN
------------------------------------------------------------
 Hash Join (actual rows=5598473.00 loops=1)
   Hash Cond: (t.book_ref = b.book_ref)
   Buffers: shared hit=15839 read=57833 written=2, temp
   read=60337 written=60337
   -> Seq Scan on tickets t (actual rows=5598473.00 loop...
       Buffers: shared read=57816 written=2
   -> Hash (actual rows=2486710.00 loops=1)
       Buckets: 131072  Batches: 32  Memory Usage: 5155kB
       Buffers: shared hit=15839 read=17, temp
       written=12364
       -> Seq Scan on bookings b (actual rows=2486710.00...
           Buffers: shared hit=15839 read=17
 Planning:
   Buffers: shared hit=34 read=14
(14 rows)
哈希连接使用 32 个批次。Hash 节点会溢出构建侧数据,而在处理这些批次时,Hash Join 节点也会读写临时数据。
现在只返回一列:
EXPLAIN ( analyze , costs off , timing off , summary off )
SELECT b . book_ref
FROM bookings b
JOIN tickets t ON b . book_ref = t . book_ref ;
QUERY PLAN
------------------------------------------------------------
Hash Join ( actual rows = 5598473 . 00 loops = 1 )
Hash Cond : ( t . book_ref = b . book_ref )
Buffers : shared hit = 15950 read = 57722 , temp read = 25850
written = 25850
-> Seq Scan on tickets t ( actual rows = 5598473 . 00 loop ...
Buffers : shared hit = 94 read = 57722
-> Hash ( actual rows = 2486710 . 00 loops = 1 )
Buckets : 262144 Batches : 32 Memory Usage : 5002 kB
Buffers : shared hit = 15856 , temp written = 7927
-> Seq Scan on bookings b ( actual rows = 2486710 . 00 ...
Buffers : shared hit = 15856
Planning :
Buffers : shared hit = 18
( 13 rows )
内存消耗降低了,因为现在哈希表只包含一个字段,而不是构成 bookings 表一行的三个字段。
因此,下面两点很重要:
只有实际需要的字段才应放进哈希表;
哈希表应在较小的输入上构建。
第一点是查询作者的责任,第二点是规划器的责任。
执行代价 如果哈希分布良好且哈希表位于内存中,构建和探测的基本工作量预计大致与两个输入大小之和 N + M N+M N + M
不过,哈希表必须构建完成后连接才能开始,因此对于少量行,嵌套循环更高效。
哈希连接与整表扫描结合,典型用于处理大量行的 OLAP 查询;这类查询更重视总体吞吐量,而不是响应时间。
并行哈希连接 与其他连接方法不同,哈希连接不仅可以参与并行计划,还拥有高效的并行感知算法。它会将连接的两个阶段都并行化:从内部输入构建哈希表,以及使用enable_parallel_hash 控制,默认启用。
在这种情况下,内存预算是 work_mem × hash_mem_multiplier × 进程数。所有进程都可以协助扫描内部输入并构建一张共享哈希表。构建阶段完成后,它们协作扫描外部输入并探测这张共享表。
增加每个进程可用于构建哈希表的内存量,并运行聚合查询:
SET work_mem = '32MB' ;
EXPLAIN ( analyze , costs off , timing off , buffers off )
SELECT count ( * )
FROM bookings b
JOIN tickets t ON b . book_ref = t . book_ref ;
QUERY PLAN
------------------------------------------------------------
Finalize Aggregate ( actual rows = 1 . 00 loops = 1 )
-> Gather ( actual rows = 3 . 00 loops = 1 )
Workers Planned : 2
Workers Launched : 2
-> Partial Aggregate ( actual rows = 1 . 00 loops = 3 )
-> Parallel Hash Join ( actual rows = 1866157 . 67 ...
Hash Cond : ( t . book_ref = b . book_ref )
-> Parallel Seq Scan on tickets t ( actual ...
-> Parallel Hash ( actual rows = 828903 . 33 l ...
Buckets : 4194304 Batches : 1 Memory
Usage : 130080 kB
-> Parallel Seq Scan on bookings b ( a ...
Planning Time : 0 . 161 ms
Execution Time : 625 . 430 ms
( 14 rows ) 注意,分配的内存超过了单个进程的预算:在这个例子中,work_mem × hash_mem_multiplier = 64 MB。Batches: 1 表明连接保持为单批次 。
如果并行进程合计可用的内存仍不足以容纳整个哈希表,PostgreSQL 会使用多批次 并行算法。
首先,进程并行读取内部输入,将其划分为批次,并把批次写入临时文件。与串行算法不同,包括第一个批次在内的所有批次都会写入磁盘:每个进程只读取内部输入的一部分,因此没有任何一个进程单独拥有完整批次。
之后,外部输入也会并行读取、划分为批次并写入临时文件。外部输入读取完成后,对于 N 个批次会有 2N 个临时文件:每个批次各有一个内部文件和一个外部文件。
然后,每个进程选择一个尚未处理的批次,将该批次的内部行加载进哈希表,读取对应的外部行,并执行连接。在多批次算法中,每个进程都有一张大小为 work_mem × hash_mem_multiplier 的哈希表,但这些表位于共享内存中,这意味着每个并行工作进程都可以访问每张表。
一个进程完成一个批次后,会选择另一个批次。如果没有未处理的批次,空闲进程可以协助处理其他进程尚未完成的批次,因为哈希表位于共享内存中。
使用多张较小的哈希表可以让协调更简单。与让所有进程共同使用一张大型共享哈希表相比,这种方式也能减少同步开销。
降低内存设置:
运行同一查询:
EXPLAIN ( analyze , costs off , timing off , buffers off )
SELECT count ( * )
FROM bookings b
JOIN tickets t ON b . book_ref = t . book_ref ;
QUERY PLAN
------------------------------------------------------------
Finalize Aggregate ( actual rows = 1 . 00 loops = 1 )
-> Gather ( actual rows = 3 . 00 loops = 1 )
Workers Planned : 2
Workers Launched : 2
-> Partial Aggregate ( actual rows = 1 . 00 loops = 3 )
-> Parallel Hash Join ( actual rows = 1866157 . 67 ...
Hash Cond : ( t . book_ref = b . book_ref )
-> Parallel Seq Scan on tickets t ( actual ...
-> Parallel Hash ( actual rows = 828903 . 33 l ...
Buckets : 1048576 Batches : 8 Memory
Usage : 20416 kB
-> Parallel Seq Scan on bookings b ( a ...
Planning Time : 0 . 112 ms
Execution Time : 647 . 388 ms
( 14 rows ) 连接现在使用八个批次。
4. 归并连接 第三种主要连接方法是归并连接。归并连接利用有序输入。如果两个行集都按兼容的连接键排序,PostgreSQL 就可以按键顺序推进它们,并组合匹配的组。Gather Merge 节点的工作方式类似:它把已经排序的流合并成一个有序流。
排序可能很昂贵——比较排序通常为 O ( N log N ) O(N \log N) O ( N log N )
B-树索引可能已经提供了所需顺序,或者较早的计划节点可能保留了这个顺序。
一个简化的思维模型是:当前键较小的输入不断前进,直到其键值追上另一侧。当键相等时,就产生匹配行。重复的连接键会使这个模型复杂一些。如果一侧或两侧输入都包含多个相同键的行,PostgreSQL 必须为该键产生所有匹配组合。
考虑一个连接,其中两个输入已经具有所需的顺序:
EXPLAIN ( costs off ) SELECT *
FROM tickets t
JOIN segments tf ON tf . ticket_no = t . ticket_no
ORDER BY t . ticket_no ;
QUERY PLAN
----------------------------------------------------
Merge Join
Merge Cond : ( t . ticket_no = tf . ticket_no )
-> Index Scan using tickets_pkey on tickets t
-> Index Scan using segments_pkey on segments tf
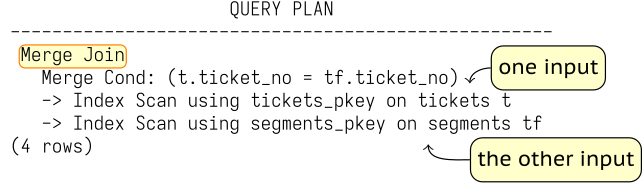
( 4 rows ) 说明
一个输入:tickets t 上的 Index Scan。另一个输入:segments tf 上的 Index Scan。
图 5.5 归并连接 归并连接的一个重要性质是,它按排序顺序返回连接结果。特别是,得到的行集可以在无需再次排序的情况下用于另一个归并连接;也可以像这个例子一样,直接返回给客户端。
下面的例子中,一个 Merge Join 从另一个 Merge Join 接收已经排序的行集:
EXPLAIN ( costs off )
SELECT t . ticket_no , bp . flight_id , bp . seat_no
FROM tickets t
JOIN segments tf ON t . ticket_no = tf . ticket_no
JOIN boarding_passes bp ON bp . ticket_no = tf . ticket_no
AND bp . flight_id = tf . flight_id
ORDER BY t . ticket_no ;
                         QUERY PLAN
------------------------------------------------------------
 Merge Join
   Merge Cond: (tf.ticket_no = t.ticket_no)
   -> Merge Join
       Merge Cond: ((tf.ticket_no = bp.ticket_no) AND (t...
       -> Index Only Scan using segments_pkey on segment...
       -> Index Scan using boarding_passes_pkey on board...
   -> Index Only Scan using tickets_pkey on tickets t
(7 rows) 这里,segments 与 boarding_passes 连接,然后 tickets 再与这个已经按机票号排序的行集连接。
执行代价 如果两个输入都已经按归并键排序,基本的归并过程与输入大小成线性关系:O ( N + M ) O(N+M) O ( N + M )
不过,如果需要排序,代价会与 N log N 成正比;对于大量数据,这种方法很可能输给哈希连接。
并行计划中的归并连接 归并连接可以参与并行计划,但 Merge Join 节点本身并不是一种与 Parallel Hash Join 同意义上的并行感知连接算法。
一种常见模式是:并行扫描一个输入,同时每个工作进程独立读取另一个完整输入,直到找到自己需要的匹配行。
对于大型连接,这种重复工作可能使并行哈希连接更有吸引力,因为并行哈希连接的设计就是为了共享构建工作和探测工作。
创建一个索引,让 PostgreSQL 能够廉价地按 book_ref 顺序获取 tickets:
CREATE INDEX ON tickets ( book_ref ); 现在考虑:
EXPLAIN ( costs off ) SELECT count ( * )
FROM bookings b
JOIN (
SELECT book_ref FROM tickets GROUP BY book_ref
) t ON b . book_ref = t . book_ref ;
QUERY PLAN
------------------------------------------------------------
Finalize Aggregate
-> Gather
Workers Planned : 2
-> Partial Aggregate
-> Merge Join
Merge Cond : ( b . book_ref = tickets . book_ref )
-> Parallel Index Only Scan using booking ...
-> Group
Group Key : tickets . book_ref
-> Index Only Scan using tickets_book ...
( 10 rows ) bookings_pkey 的扫描是并行的。不过,tickets 上的分组子查询会由每个执行归并连接的参与进程独立读取。
移除演示索引:
DROP INDEX tickets_book_ref_idx;
DROP INDEX
6 统计信息阅读规划器统计信息、高频值、直方图、函数依赖、非重复值数量、多元统计信息和表达式统计信息。
1. 基本统计信息 PostgreSQL 在两个层次收集基本规划器统计信息:关系整体层次,以及单独的列层次。
表级统计信息 关系级统计信息包括关系大小的估计值:pg_class 的 reltuples 和 relpages 列。这些值非常重要,以至于 PostgreSQL 不仅会在 VACUUM 和 ANALYZE 期间更新它们,也会在 CREATE INDEX 和 CREATE TABLE AS 等一些 DDL 操作之后更新它们。
如果当前物理文件大小不同于产生该估计时所依据的 relpages 值,规划器还可以按比例调整已保存的行数估计。这样,即使下一次完整统计信息刷新尚未发生,估计也能对表的增长作出反应。
对于每一列的统计信息,ANALYZE 会检查随机抽取的行,而不是每次都读取整张表。所需样本大小不会随着表增大,而是由 default_statistics_target 设置(默认值为 100),再乘以 300。
SELECT current_setting ( 'default_statistics_target' ):: int
* 300 AS rows_in_sample ;
rows_in_sample
----------------
30000
( 1 row ) 对于大表,根据样本得到的估计不会精确。规划器通常只需要足够准确的估计来区分竞争计划。数量级上的错误可能造成灾难性后果;小的抽样误差往往并不会。
考虑一个没有谓词的查询:
EXPLAIN SELECT * FROM flights ;
QUERY PLAN
-------------------------------------------
Seq Scan on flights
( cost = 0 . 00 .. 744 . 71 rows = 37671 width = 51 )
( 2 rows ) 行数估计来自 pg_class:
SELECT reltuples , relpages FROM pg_class
WHERE relname = 'flights' ;
reltuples | relpages
-----------+----------
37671 | 368
( 1 row ) 在这个例子中,它碰巧与精确计数相符:
SELECT count ( * ) FROM flights ;
count
-------
37671
( 1 row )
其余基本统计信息由 ANALYZE 按列收集。它们的内部表示存储在 pg_statistic 中;pg_stats 视图则以更友好、同时符合权限安全的形式展示最有用的字段。
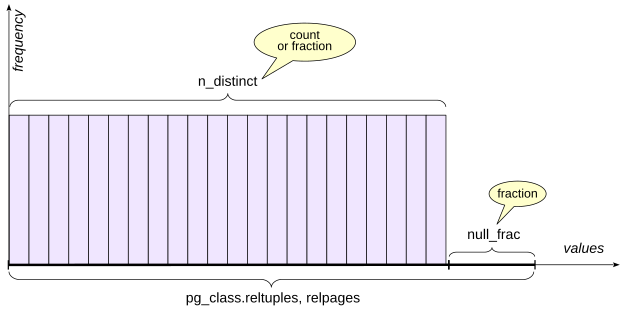
图 6.1 非重复值数量与空值比例
空值比例 pg_stats.null_frac 存储该列为空的行所占比例,取值范围为 0 到 1。
有些航班尚未出发,因此 actual_departure 仍为空:
EXPLAIN SELECT *
FROM flights WHERE actual_departure IS NULL ;
QUERY PLAN
-------------------------------------------
Seq Scan on flights
( cost = 0 . 00 .. 744 . 71 rows = 10755 width = 51 )
Filter : ( actual_departure IS NULL )
( 3 rows ) 规划器通过将关系行数估计值乘以 null_frac 得到这个估计:
SELECT round ( 37671 * null_frac ) FROM pg_stats
WHERE tablename = 'flights'
AND attname = 'actual_departure' ;
round
-------
10755
( 1 row ) 精确值与之接近,但并不完全相同:
SELECT count ( * ) FROM flights
WHERE actual_departure IS NULL ;
count
-------
10806
( 1 row )
非重复值数量 pg_stats.n_distinct 存储列中非空非重复值数量的估计值。正值表示估计的绝对数量。负值表示非重复值数量与行数的比例。例如,−1 表示所有值都是唯一的,这在主键中很常见。负数表示法会随着表增长自然扩展,因此很有用。
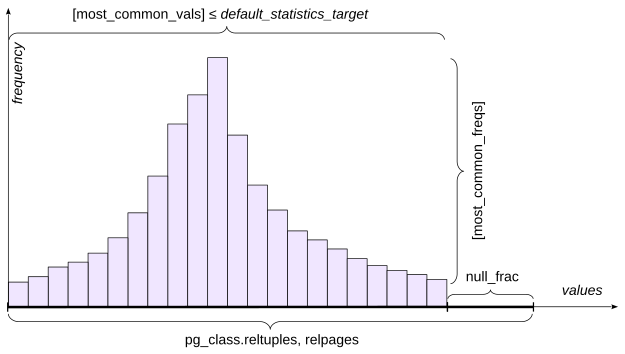
高频值 如果每个值出现的频率都相同,那么非重复值数量就能让我们了解很多有关相等谓词的信息。但真实数据很少这样配合。为此,PostgreSQL 还会存储另外两项信息:
pg_stats.most_common_vals:高频值(most common values,MCV)数组,也称为 MCV 列表。
pg_stats.most_common_freqs:这些值的频率数组。图 6.2 高频值及其频率 对于出现在 MCV 列表中的值,可以直接使用其保存的频率作为选择率估计。条目的最大数量由统计目标控制。default_statistics_target 提供默认值,而 ALTER TABLE ... ALTER COLUMN ... SET STATISTICS 可以针对单独的列覆盖该值。增大目标值也会增加 ANALYZE 使用的样本大小。
为了避免增大 pg_statistic 的大小,也避免让规划器承担无用的工作,大于 1 kB 的值会从统计信息和分析中排除。这么大的值很可能是唯一值,本来就几乎不可能出现在 most_common_vals 中。
为了进行实验,降低到达机场列的统计目标:
ALTER TABLE routes
ALTER COLUMN arrival_airport SET STATISTICS 10 ;
ANALYZE routes ;
孟买(BOM)足够常见,因此出现在 MCV 列表中:
EXPLAIN SELECT *
FROM routes WHERE arrival_airport = 'BOM' ;
QUERY PLAN
---------------------------------------------
Seq Scan on routes
( cost = 0 . 00 .. 59 . 38 rows = 55 width = 103 )
Filter : ( arrival_airport = 'BOM' :: bpchar )
( 3 rows ) 精确计数也是 55:
SELECT count ( * ) FROM routes WHERE arrival_airport = 'BOM' ;
count
-------
55
( 1 row ) 检查高频值及其频率:
SELECT unnest ( most_common_vals :: text :: text []) AS mcv ,
unnest ( most_common_freqs :: text :: float []) AS mcf
FROM pg_stats
WHERE tablename = 'routes'
AND attname = 'arrival_airport'
ORDER BY 2 DESC ;
mcv | mcf
-----+-------------
BOM | 0 . 027093597
FRA | 0 . 026108375
SVO | 0 . 026108375
DEL | 0 . 021182265
ATL | 0 . 020689655
BLR | 0 . 020689655
CAN | 0 . 020689655
TFU | 0 . 020197045
CDG | 0 . 019211823
HND | 0 . 019211823
( 10 rows )
基数估计等于 routes 中的行数乘以保存的频率:
SELECT round (
2030 * most_common_freqs [
array_position (( most_common_vals :: text :: text []), 'BOM' )
]
)
FROM pg_stats
WHERE tablename = 'routes'
AND attname = 'arrival_airport' ;
round
-------
55
( 1 row ) MCV 数据也会参与不等式估计:PostgreSQL 可以把满足范围条件的 MCV 条目的频率相加。
如果某个值不在 MCV 列表中,规划器会在假定剩余总体服从均匀分布的情况下估计它。
圣地亚哥(SCL)没有出现在我们包含十个值的 MCV 列表中:
EXPLAIN SELECT *
FROM routes
WHERE arrival_airport = 'SCL' ;
QUERY PLAN
---------------------------------------------
Seq Scan on routes
( cost = 0 . 00 .. 59 . 38 rows = 25 width = 103 )
Filter : ( arrival_airport = 'SCL' :: bpchar )
( 3 rows ) 精确结果是 18:
SELECT count ( * ) FROM routes
WHERE arrival_airport = 'SCL' ;
count
-------
18
( 1 row ) 要得到这个估计,规划器首先把高频值的频率相加:
SELECT sum ( f )
FROM pg_stats s , unnest ( s . most_common_freqs ) f
WHERE s . tablename = 'routes'
AND s . attname = 'arrival_airport' ;
sum
------------
0 . 22118227
( 1 row ) 该列有 73 个非重复值:
SELECT n_distinct
FROM pg_stats
WHERE tablename = 'routes' AND attname = 'arrival_airport' ;
n_distinct
------------
73
( 1 row ) 其中 10 个已经在 MCV 列表中被明确表示。由于没有空值,剩余概率质量会近似均匀地分布在其余 63 个值上:
SELECT round ( 2030 * ( 1 - 0 . 22118227 ) / ( 73 - 10 ) );
round
-------
25
( 1 row )
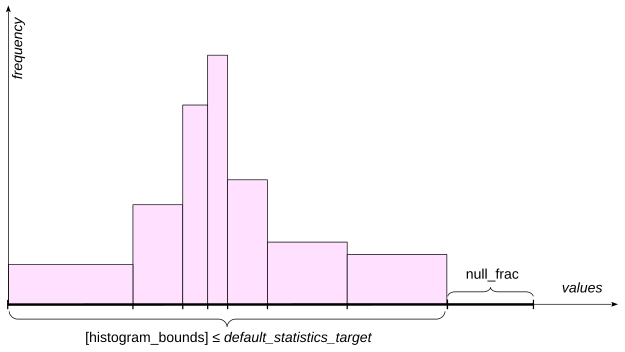
直方图 当非重复值太多,无法用 MCV 列表有效描述时,PostgreSQL 还会建立直方图。
直方图由包含值的多个桶组成。直方图桶的数量由同一个 default_statistics_target 参数控制。
桶边界的选择使得每个桶中大致包含相同数量的值;在图中,这体现为面积相等的矩形。采用这种构造后,PostgreSQL 只需在 pg_stats.histogram_bounds 中保存边界值数组。每个桶的频率等于 1 除以桶总数。
图 6.3 剩余值的直方图 对于类似 field < value 的不等式,规划器会估计直方图中位于边界值左侧的部分。它可以在包含边界的桶内插值,而不是只计算完整桶的数量。
MCV 值和空值会从直方图总体中排除:
SELECT histogram_bounds FROM pg_stats
WHERE tablename = 'routes'
AND attname = 'arrival_airport' ;
histogram_bounds
-----------------------------------------------
{ AER , CKG , DFW , HEL , KZN , LHR , MXP , PKX , SVX , YEG , YYZ }
( 1 row ) 这就是为什么范围选择率会同时结合 MCV 列表和直方图的信息。
考虑:
EXPLAIN SELECT *
FROM routes WHERE arrival_airport <= 'DFW' ;
QUERY PLAN
----------------------------------------------
Seq Scan on routes
( cost = 0 . 00 .. 59 . 38 rows = 579 width = 103 )
Filter : ( arrival_airport <= 'DFW' :: bpchar )
( 3 rows ) 精确计数为:
SELECT count ( * ) FROM routes WHERE arrival_airport <= 'DFW' ;
count
-------
609
( 1 row ) 请求区间内的 MCV 值贡献了以下频率:
SELECT sum ( s . most_common_freqs [
array_position ( ( s . most_common_vals :: text :: text []), v )
] )
FROM pg_stats s ,
unnest ( s . most_common_vals :: text :: text []) v
WHERE s . tablename = 'routes'
AND s . attname = 'arrival_airport'
AND v <= 'DFW' ;
    sum
------------
 0.12955666
(1 row) 在这个例子中,DFW 正好是第二个桶的右边界,因此十个直方图桶中有两个落在该区间内。没有空值。因此,估计值为:
SELECT round (
2030 * ( 0 . 12955666 + ( 1 - 0 . 22118227 ) * ( 2 . 0 / 10 . 0 ) )
);
round
-------
579
( 1 row ) 对于位于桶内的边界,PostgreSQL 会根据数据类型和操作符使用合适的插值来细化估计。
对于不在 MCV 列表中的值,直方图在等值条件下的作用小得多。此时 PostgreSQL 会退回到基于剩余非重复值数量的估计。
其他统计信息字段 还有几个统计信息字段会影响规划过程。
pg_stats.correlation 衡量列值的逻辑顺序与行的物理顺序之间的统计相关性。接近 1 或 −1 的值表示行的物理排列具有很强的有序性;接近零的值表示相关性很小。在计算索引扫描的代价时,这一点很重要,因为强相关性会降低预期的随机堆访问。
pg_class.relallvisible 存储可见性映射中标记为全可见 的表页数量。全可见页面中的所有元组都已知对当前和未来所有事务可见。如果这个数量不够大,规划器可能会选择位图扫描,而不是仅索引扫描。
pg_stats.avg_width 存储列中值的平均大小,单位为字节,用于估计操作所需的内存。
自定义计划与通用计划 使用简单查询协议时(见 第二章“规划与执行”
扩展协议允许准备语句,而这些语句可以带有参数。语法解析树保存在后端进程的本地内存中。这样,就可以等参数值已知后再进行规划。
自定义计划 会使用一次执行的实际参数值生成。当数据存在偏斜时,这很有用,因为不同的参数值可能使不同的访问方法达到最佳效果。例如,对于稀有值,索引可能非常优秀;而对于非常常见的值,索引可能反而不如顺序扫描。
通用计划 生成时不使用实际参数值。它可以在多次执行之间复用,从而节省规划时间。对于均匀分布的数据,通用计划尤其有效,因为条件的选择率不取决于具体参数值。
准备查询并创建索引:
PREPARE f ( text ) AS
SELECT * FROM flights WHERE status = $ 1 ;
CREATE INDEX ON flights ( status ); 取消的航班足够少,因此使用索引扫描:
EXPLAIN EXECUTE f ( 'Cancelled' );
QUERY PLAN
------------------------------------------------
Index Scan using flights_status_idx on flights
( cost = 0 . 29 .. 59 . 43 rows = 210 width = 51 )
Index Cond : ( status = 'Cancelled' :: text )
( 3 rows ) 已抵达的航班很常见,因此自定义计划选择顺序扫描:
EXPLAIN EXECUTE f ( 'Arrived' );
QUERY PLAN
-------------------------------------------
Seq Scan on flights
( cost = 0 . 00 .. 838 . 89 rows = 26900 width = 51 )
Filter : ( status = 'Arrived' :: text )
( 3 rows ) 再执行三次语句,使自定义执行总数达到五次:
EXECUTE f('Arrived');
EXECUTE f('Arrived');
EXECUTE f('Arrived');
可以在 pg_prepared_statements 中看到计数器:
SELECT name , generic_plans , custom_plans
FROM pg_prepared_statements ;
 name | generic_plans | custom_plans
------+---------------+--------------
 f    |             0 |            5
(1 row)
下一次执行时,这个例子会切换到通用计划。通用计划显示参数符号,而不是具体值:
EXPLAIN EXECUTE f ( 'Arrived' );
QUERY PLAN
------------------------------------------------------------
Index Scan using flights_status_idx on flights ( cost = 0 ...
Index Cond : ( status = $ 1 )
( 2 rows ) SELECT name , generic_plans , custom_plans
FROM pg_prepared_statements ;
name | generic_plans | custom_plans
------+---------------+--------------
f | 1 | 5
( 1 row ) 对于有偏斜的数据,这种切换可能并不理想。为处理这种情况,plan_cache_mode 可以覆盖自动启发式规则:
SHOW plan_cache_mode ;
plan_cache_mode
-----------------
auto
( 1 row )
SET plan_cache_mode = 'force_custom_plan' ;
EXPLAIN EXECUTE f ( 'Arrived' );
QUERY PLAN
------------------------------------------------------------
Seq Scan on flights ( cost = 0 . 00 .. 838 . 89 rows = 26900 widt ...
Filter : ( status = 'Arrived' :: text )
( 2 rows )
RESET plan_cache_mode ;
2. 扩展统计信息 自动收集的基本统计信息可能不足以产生准确的基数和选择率估计。
PostgreSQL 允许管理员手动确定需要哪些额外的扩展统计信息。你可以收集同时跨越多列的统计信息,即多元统计信息(multivariate statistics),也可以收集任意表达式的统计信息。
注意,基本统计信息会针对表及其列收集,但不会针对索引收集,表达式索引除外。因此,仅仅在多列上创建索引并不会创建多元统计信息。
使用 CREATE STATISTICS 命令创建扩展统计信息。其定义存储在 pg_statistic_ext 中;收集的数据存储在 pg_statistic_ext_data 中。
PostgreSQL 提供多种多元统计信息。
函数依赖 函数依赖(functional dependency)描述一个列中的值在多大程度上决定另一个列中的值。
表 6.1 函数依赖
例如,如果邮编唯一决定城市,那么针对 city 和 postal_code 的谓词就是相关的,如图所示。
考虑 routes 上的两个谓词:
SELECT count ( * ) FROM routes
WHERE route_no = 'PG0085' AND arrival_airport = 'FCO' ;
count
-------
7
( 1 row ) 没有扩展统计信息时,估计值会严重偏低:
EXPLAIN SELECT * FROM routes
WHERE route_no = 'PG0085' AND arrival_airport = 'FCO' ;
QUERY PLAN
---------------------------------------------------------
Bitmap Heap Scan on routes
( cost = 4 . 20 .. 22 . 77 rows = 1 width = 103 )
Recheck Cond : ( route_no = 'PG0085' :: text )
Filter : ( arrival_airport = 'FCO' :: bpchar )
-> Bitmap Index Scan on routes_route_no_validity_excl
( cost = 0 . 00 .. 4 . 20 rows = 7 width = 0 )
Index Cond : ( route_no = 'PG0085' :: text )
( 7 rows ) 原因在于,规划器假设谓词相互独立,并把逻辑 AND 组合的条件的选择率相乘,从而计算出结果选择率。计划清楚地展示了这一点:Bitmap Index Scan 节点中 route_no 条件的估计是正确的,但在 Bitmap Heap Scan 节点按 arrival_airport 过滤后,估计值就被低估了。不过我们知道,航线号唯一决定到达机场,因此在机场指定正确的前提下,第二个条件实际上是多余的。
创建依赖统计信息:
CREATE STATISTICS routes_dep ( dependencies )
ON route_no , arrival_airport FROM routes ;
ANALYZE routes ; 检查依赖:
SELECT dependencies FROM pg_stats_ext
WHERE statistics_name = 'routes_dep' ;
dependencies
----------------------
{ "1 => 4" : 1 . 000000 }
( 1 row ) 冒号后的数字是该属性映射测得的依赖程度。现在估计得到了改善:
EXPLAIN SELECT * FROM routes
WHERE route_no = 'PG0085' AND arrival_airport = 'FCO' ;
QUERY PLAN
---------------------------------------------------------
Bitmap Heap Scan on routes
( cost = 4 . 20 .. 22 . 78 rows = 7 width = 103 )
Recheck Cond : ( route_no = 'PG0085' :: text )
Filter : ( arrival_airport = 'FCO' :: bpchar )
-> Bitmap Index Scan on routes_route_no_validity_excl
( cost = 0 . 00 .. 4 . 20 rows = 7 width = 0 )
Index Cond : ( route_no = 'PG0085' :: text )
( 7 rows ) psql 元命令 \d routes 也会列出表上定义的统计信息对象。Statistics objects 部分显示它们的名称、列以及非默认统计目标:
 ...
Statistics objects:
    "bookings.routes_dep" (dependencies) ON route_no,
    arrival_airport FROM routes
最常见组合 列之间可能存在相关性,但没有任何一列在函数上决定另一列。图中展示了可能的城市—河流组合。city 和 river 上的谓词显然相关,但与前一个例子不同,这里没有任何一列决定另一列:城市和河流之间是多对多关系。
表 6.2 最常见组合 下面是演示数据库中的类似例子:
EXPLAIN ( analyze , timing off , summary off , buffers off )
SELECT * FROM routes
WHERE departure_airport = 'BOM' AND airplane_code = '7M7' ;
QUERY PLAN
------------------------------------------------------------
Bitmap Heap Scan on routes
( cost = 4 . 69 .. 40 . 71 rows = 9 width = 103 )
( actual rows = 17 . 00 loops = 1 )
Recheck Cond : ( departure_airport = 'BOM' :: bpchar )
Filter : ( airplane_code = '7M7' :: bpchar )
Rows Removed by Filter : 38
Heap Blocks : exact = 27
-> Bitmap Index Scan on routes_departure_airport_lowe ...
( cost = 0 . 00 .. 4 . 69 rows = 55 width = 0 )
( actual rows = 55 . 00 loops = 1 )
Index Cond : ( departure_airport = 'BOM' :: bpchar )
Index Searches : 1
( 12 rows )
规划器低估了行数。对这对列建立 MCV 统计信息后,估计值现在正确了:
CREATE STATISTICS ( mcv )
ON departure_airport , airplane_code FROM routes ;
ANALYZE routes ;
EXPLAIN SELECT * FROM routes
WHERE departure_airport = 'BOM' AND airplane_code = '7M7' ;
QUERY PLAN
------------------------------------------------------------
Bitmap Heap Scan on routes
( cost = 4 . 69 .. 40 . 72 rows = 17 width = 103 )
Recheck Cond : ( departure_airport = 'BOM' :: bpchar )
Filter : ( airplane_code = '7M7' :: bpchar )
-> Bitmap Index Scan on routes_departure_airport_lowe ...
( cost = 0 . 00 .. 4 . 69 rows = 55 width = 0 )
Index Cond : ( departure_airport = 'BOM' :: bpchar )
( 7 rows ) 可以使用 pg_mcv_list_items 函数检查多元 MCV 数据:
SELECT values , frequency
FROM pg_statistic_ext
JOIN pg_statistic_ext_data ON oid = stxoid ,
pg_mcv_list_items ( stxdmcv ) m
WHERE stxname = 'routes_departure_airport_airplane_code_stat'
LIMIT 3 ;
values | frequency
-----------+----------------------
{ FRA , 77 W } | 0 . 009852216748768473
{ BOM , 7 M7 } | 0 . 008374384236453201
{ PVG , 77 W } | 0 . 008374384236453201
( 3 rows )
非重复组合 规划器可能出错的另一种情况是分组。多元 ndistinct 统计信息可以改善
在图中的例子里,所有字段可能形成的组合数量,显然不能简单地将各列的非重复值数量分别相乘来确定。
表 6.3 非重复组合 统计非重复的直达机场对:
SELECT count ( * ) FROM (
SELECT DISTINCT departure_airport , arrival_airport
FROM routes
);
count
-------
932
( 1 row ) 没有多元非重复值统计信息时,规划器严重低估了分组数量:
EXPLAIN SELECT DISTINCT departure_airport , arrival_airport
FROM routes ;
QUERY PLAN
-------------------------------------------------
HashAggregate
( cost = 64 . 45 .. 66 . 48 rows = 203 width = 8 )
Group Key : departure_airport , arrival_airport
-> Seq Scan on routes
( cost = 0 . 00 .. 54 . 30 rows = 2030 width = 8 )
( 5 rows )
创建扩展统计信息对象。如果没有指定类型,PostgreSQL 会包含适用的所有受支持多元类型:
CREATE STATISTICS
ON departure_airport , arrival_airport FROM routes ;
ANALYZE routes ;
EXPLAIN SELECT DISTINCT departure_airport , arrival_airport
FROM routes ;
QUERY PLAN
-------------------------------------------------
HashAggregate
( cost = 64 . 45 .. 73 . 77 rows = 932 width = 8 )
Group Key : departure_airport , arrival_airport
-> Seq Scan on routes
( cost = 0 . 00 .. 54 . 30 rows = 2030 width = 8 )
( 5 rows ) 估计得到了改善。检查保存的估计值:
SELECT n_distinct
FROM pg_stats_ext
WHERE statistics_name =
'routes_departure_airport_arrival_airport_stat' ;
n_distinct
---------------
{ "3, 4" : 932 }
( 1 row ) \dX 会列出扩展统计信息对象。对象本身的值存储在 pg_statistic_ext_data 视图中。
表达式统计信息 扩展统计信息还可以为表达式收集普通的单变量统计信息,就像表中有一个保存该表达式结果的列一样。
表 6.4 表达式统计信息 表达式也可以与列或其他表达式一起参与多元统计信息。
如果没有表达式统计信息,操作数是表达式的谓词可能会迫使规划器使用通用默认选择率,因为它没有表达式自身的分布数据。例如:
EXPLAIN ( analyze , timing off , summary off , buffers off )
SELECT * FROM flights
WHERE extract ( month FROM scheduled_departure
AT TIME ZONE 'Europe/Moscow' ) = 1 ;
QUERY PLAN
------------------------------------------------------------
Seq Scan on flights
( cost = 0 . 00 .. 1027 . 24 rows = 188 width = 51 )
( actual rows = 5529 . 00 loops = 1 )
Filter : ( EXTRACT ( month FROM ( scheduled_departure AT T ...
Rows Removed by Filter : 32142
( 5 rows ) 这个估计值太小了。提供统计信息的一种方式是表达式索引,但即使索引不用于访问,它也会产生存储和维护代价。如果目标只是改善估计,就创建表达式统计信息:
CREATE STATISTICS
ON extract ( month FROM scheduled_departure
AT TIME ZONE 'Europe/Moscow' )
FROM flights ;
ANALYZE flights ;
EXPLAIN
SELECT * FROM flights
WHERE extract ( month FROM scheduled_departure
AT TIME ZONE 'Europe/Moscow' ) = 1 ;
QUERY PLAN
------------------------------------------------------------
Seq Scan on flights
( cost = 0 . 00 .. 1027 . 24 rows = 5561 width = 51 )
Filter : ( EXTRACT ( month FROM ( scheduled_departure AT T ...
( 3 rows ) 现在估计值已经接近实际值。
表达式统计信息可以在 pg_stats_ext_exprs 视图中查看:
SELECT statistics_name , left ( expr , 40 ) AS expr ,
n_distinct , most_common_vals
FROM pg_stats_ext_exprs \ gx
- [ RECORD 1 ] ----+-----------------------------------------
statistics_name | flights_expr_stat
expr | EXTRACT ( month FROM ( scheduled_departure
n_distinct | 7
most_common_vals | { 10 , 1 , 12 , 11 , 3 , 4 , 2 } 清理本章创建的对象:
DROP INDEX flights_status_idx ;
DROP INDEX
SELECT 'DROP STATISTICS ' || statistics_name
FROM pg_stats_ext \ gexec
DROP STATISTICS
DROP STATISTICS
DROP STATISTICS
DROP STATISTICS
参考资源 7 性能剖析使用 PostgreSQL 日志、pg_stat_statements、auto_explain 和性能剖析器找出高代价查询,并将测量结果与整体工作负载代价联系起来。
1. 什么是性能剖析 前几章讨论了查询如何工作、执行计划由哪些构件组成,以及哪些因素会影响规划器在不同计划之间的选择。这是最困难也最重要的部分。理解这些机制之后,逻辑和常识通常就足以发挥很大作用:你可以判断查询是否在高效执行,以及什么措施可能改善它。
但怎样才能找到真正值得优化的查询?
任何优化任务——不只是数据库优化——都从性能剖析(profiling)开始,即使我们不总是使用这个词。我们把有问题的任务拆分成更小的部分,并测量每个部分占总工作量的多少。知道每个部分执行了多少次也很有用。
某个组件在总代价中所占的份额越大,优化它的潜在收益就越大。在实践中,优化工作本身的代价也很重要:理论上很大的收益,可能需要付出高昂代价,或者伴随较大风险才能获得。
有时某个组件单独看运行得很快,但执行次数太多。例如,ORM 生成的查询就常有这种情况。此时,更有用的问题可能是:
对数据库整体活动进行性能剖析,对于管理员也很有价值:管理员可能并不是在调查某一个投诉,而是在寻找系统资源消耗最大的部分。监控系统应当能展示这样的性能概况。
Andrey Zubkov 的 pg_profile 扩展就是完成这项工作的工具之一。它建立在 PostgreSQL 统计信息视图之上,并定期保存活动快照。比较不同快照,既可以发现性能问题,也可以发现问题出现时所处的条件。监控架构、工具和指标选择的完整讨论超出了本书范围。
Postgres Professional 还出版了 Alexey Lesovsky 的俄语书籍《Monitoring PostgreSQL》,对这一主题进行了深入讨论。不过,在调查一个具体问题时,性能剖析的范围应当限定为重现该问题所需的操作。
为了解决具体问题,性能剖析应当这样建立:测量结果只覆盖重现该问题所需的那些操作。
2. 测量什么 应该使用什么单位来表示一个组件的代价?对于终端用户来说,最有意义的度量是响应时间 :从执行某个动作到得到结果,经过了多少秒。
在这个意义上,查看 I/O 的数量可能更方便,也就是读取和写入的页面数量 。这个度量更加稳定:在数据和配置参数相同的情况下,它不依赖硬件特性或服务器当前负载。
研究符合现实的数据量也很重要。Postgres.ai 的 Database Lab Engine 等工具能够快速创建轻量级数据库克隆(thin clone),在不复制全部存储的情况下重现生产规模的行为时,这会很有帮助。
I/O 通常能较好地反映执行查询所需的工作量,因为大量时间都花在读取和处理数据页面上。不过,这个度量对终端用户来说意义不大。
3. 应用性能剖析 性能问题经常出在数据库中:一个糟糕的执行计划就可能让运行时间相差几个数量级。但情况并不总是如此。缓慢的客户端连接、序列化、应用服务器工作、客户端渲染、排队、远程服务调用以及网络传输,都可能占据用户响应时间的主要部分。因此,完整的性能剖析应当覆盖客户端、应用服务器、网络和数据库。
除非系统的每个组件都提供有用的遥测信息,否则很难获得这样的端到端性能剖析。至少要测量总响应时间,并将它与数据库工作所占用的时间进行比较。在认定数据库是瓶颈之前,还要检查明显的网络延迟以及 PostgreSQL 之外所花费的时间。
从现在开始,假定问题已经定位在数据库中。
4. PL/pgSQL 性能剖析 一个用户动作通常会执行多条 SQL 语句。要找到值得优化的语句,我们需要包含语句级细节的剖析结果。
服务器端应用还可能包含过程代码,而不只是 SQL。
对于 PL/pgSQL 代码,Jan Wieck 的 PL Profiler 可以剖析脚本和实时会话。它会生成 HTML 报告,还可以用火焰图表示调用关系。
Pavel Stěhule 的 plpgsql_check 是另一个有用的扩展。它可以对 PL/pgSQL 代码执行额外检查,发现一些性能问题,并提供性能剖析功能。
5. 查询性能剖析 PostgreSQL 提供两条获取已执行 SQL 剖析结果的主要内置途径:服务器日志记录,以及累积的语句统计信息,后者最常通过 pg_stat_statements 获得。
服务器日志 配置参数可以启用语句及其执行时长的日志记录。log_min_duration_statement 是常见的起点。
怎样才能在日志中准确识别属于某个用户动作的查询?在一个会话中修改 log_min_duration_statement 只会影响同一个会话;性能专家没有标准方式从另一个会话为任意后端修改该参数。可以过滤共同的日志消息流,只选择所需的消息。为此,可以在 log_line_prefix 中加入额外的标识信息,例如进程 ID、会话 ID、用户、数据库或应用名称。连接池会让情况更加复杂。在函数内部执行的嵌套 SQL 又是另一个问题。auto_explain 模块可以记录计划;如果设置了 auto_explain.log_nested_statements,还可以记录嵌套语句的计划。
繁忙服务器的日志可能变得非常庞大。pgBadger 等外部工具可以汇总和分析 PostgreSQL 日志数据。
在有助于把用户可见的工作与数据库活动关联起来时,应用代码也可以发出自己的关联标识符和诊断消息。
语句统计信息 第二种方法是使用 pg_stat_statements 扩展收集语句执行统计信息。这里的“统计信息”与第六章“统计信息” 数据分布 ,帮助预测未来的执行。pg_stat_statements 记录的是实际发生的工作 的聚合信息。收集的查询执行统计信息包括以页面数量表示的 I/O 信息。
由于不同查询的数量可能非常多,存储空间由 pg_stat_statements.max 限制。当表填满时,执行频率较低的语句条目的信息会被丢弃。
除了常量不同之外,如果查询具有相同的语法解析树,就会被视为同一个查询。需要记住,这些查询可能有不同的执行计划,执行时间也可能不同。
当 compute_query_id 设置为 auto 或 on 时,PostgreSQL 核心会计算查询标识符。这样,不同扩展获取的信息就可以使用统一标识符进行关联。
启用 pg_stat_statements 扩展,我们将使用它来建立性能剖析:
CREATE EXTENSION pg_stat_statements ;
CREATE EXTENSION
ALTER SYSTEM SET shared_preload_libraries =
'pg_stat_statements' ;
ALTER SYSTEM 然后必须重启服务器。
postgres$ pg_ctl restart -l /home/postgres/logfile
postgres$ /usr/local/pgsql/bin/psql demo
在下面的示例中,我们还要收集嵌套语句:
SET pg_stat_statements . track = 'all' ;
SET 创建一个只包含待检查字段的紧凑视图:
CREATE VIEW statements_v AS
SELECT
queryid ,
toplevel ,
substring ( regexp_replace ( query , ' +' , ' ' , 'g' ) FOR 55 )
AS query ,
calls ,
round ( total_exec_time ) / 1000 AS time_sec ,
shared_blks_hit + shared_blks_read +
shared_blks_written AS shared_blks
FROM pg_stat_statements
ORDER BY total_exec_time DESC ;
CREATE VIEW 现在考虑一份报告:按飞机型号和票价舱等显示乘客数量。先定义一个函数,统计某一飞机和票价舱等对应的乘客数量:
CREATE FUNCTION qty (
airplane_code text , fare_conditions text
) RETURNS bigint
AS $$
SELECT count ( * )
FROM timetable tt
JOIN boarding_passes bp ON bp . flight_id = tt . flight_id
JOIN seats s ON s . airplane_code = tt . airplane_code
AND s . seat_no = bp . seat_no
WHERE tt . airplane_code = qty . airplane_code
AND s . fare_conditions = qty . fare_conditions ;
$$ STABLE LANGUAGE sql ;
CREATE FUNCTION
然后以此为基础创建一个表函数:
CREATE FUNCTION report ()
RETURNS TABLE (
model text ,
economy bigint , comfort bigint , business bigint
)
AS $$
DECLARE
r record ;
BEGIN
FOR r IN
SELECT a . airplane_code , a . model
FROM airplanes a
ORDER BY a . model
LOOP
report . model : = r . model ;
report . economy : = qty ( r . airplane_code , 'Economy' );
report . comfort : = qty ( r . airplane_code , 'Comfort' );
report . business : = qty ( r . airplane_code , 'Business' );
RETURN NEXT ;
END LOOP ;
END ;
$$ STABLE LANGUAGE plpgsql ; 重置语句统计信息并执行报告:
SELECT pg_stat_statements_reset ();
SELECT * FROM report ();
model | economy | comfort | business
-------------------------+---------+---------+----------
Aerobus A320neo | 120803 | 0 | 24494
Aerobus A330 - 900 neo | 337923 | 42242 | 43775
Aerobus A350 - 1000 | 736214 | 0 | 115244
Aerobus A350F | 0 | 0 | 0
Boeing 737 MAX 7 | 556344 | 0 | 61743
Boeing 767 - 300 F | 0 | 0 | 0
Boeing 777 - 300 ER | 2238243 | 329509 | 205873
Boeing 787 - 9 Dreamliner | 613540 | 68505 | 156712
Bombardier CRJ700 | 91626 | 21181 | 10604
Embraer E170 | 191837 | 0 | 16006
( 10 rows )
现在检查性能剖析结果:
SELECT * FROM statements_v \ gx
- [ RECORD 1 ] ----------------------------------
queryid | - 3009688052632882778
toplevel | t
query | SELECT * FROM report ()
calls | 1
time_sec | 28 . 311
shared_blks | 9417875
- [ RECORD 2 ] ----------------------------------
queryid | - 3792749405278051211
toplevel | f
query | SELECT count ( * ) +
| FROM timetable tt +
| JOIN boarding_passe
calls | 30
time_sec | 28 . 292
shared_blks | 9416655
- [ RECORD 3 ] ----------------------------------
queryid | 704897965492952962
toplevel | f
query | SELECT a . airplane_code , a . model +
| FROM airplanes a +
| ORDE
calls | 1
time_sec | 0
shared_blks | 4
- [ RECORD 4 ] ----------------------------------
queryid | - 3948231919979109674
toplevel | t
query | SELECT pg_stat_statements_reset ()
calls | 1
time_sec | 0
shared_blks | 0 有三个条目值得关注:
顶层的 report() 调用;
qty 中的查询,执行了 30 次;
驱动 PL/pgSQL 循环的查询。
几乎所有执行时间和缓冲区工作都来自 qty 查询。这个重复工作是显而易见的目标:报告应当围绕一条面向集合的查询重新组织。
6. 单个查询的性能剖析 性能剖析确定值得优化的语句后,我们还需要查询内部的性能剖析结果。EXPLAIN ANALYZE 可以提供这样的结果。这个结果由计划节点组成。但计划是一棵树,而不是一个扁平列表;解读时间时,这一点很重要。
对于每个节点,actual time、rows 和 loops 会告诉我们执行过程中发生了什么。
EXPLAIN 的 buffers 选项显示 I/O 数量;如果启用了 track_io_timing,它还会显示 I/O 操作花费的时间。
对于计划诊断,基数估计至少和运行时间同样重要。比较估计的 rows 与 actual rows 时,要把 loops 考虑进去。计划树底部的较大误差可能向上传播,并扭曲连接方法、访问路径、聚合和内存决策。
应该从估计首次严重出错的最深节点开始,而不是责怪每个继承该误差的父节点。
良好的基数估计并不能保证计划良好——代价参数和代价模型仍然可能有误——但较大的基数错误是最先需要调查的问题之一。
有时查询运行时间太长,无法实际使用 EXPLAIN ANALYZE。这时只能满足于普通的 EXPLAIN,
现在把乘客报告重写成一条 SQL 查询并检查它:
EXPLAIN ( analyze , costs off , timing off )
WITH rf AS MATERIALIZED (
SELECT f . flight_id , r . airplane_code
FROM flights f
JOIN routes r ON r . route_no = f . route_no
AND r . validity @> f . scheduled_departure
), t AS (
SELECT rf . airplane_code ,
count ( * ) FILTER
( WHERE s . fare_conditions = 'Economy' ) AS economy ,
count ( * ) FILTER
( WHERE s . fare_conditions = 'Comfort' ) AS comfort ,
count ( * ) FILTER
( WHERE s . fare_conditions = 'Business' ) AS business
FROM rf
JOIN boarding_passes bp ON bp . flight_id = rf . flight_id
JOIN seats s ON s . airplane_code = rf . airplane_code
AND s . seat_no = bp . seat_no
GROUP BY rf . airplane_code
)
SELECT a . model ,
coalesce ( t . economy , 0 ) AS economy ,
coalesce ( t . comfort , 0 ) AS comfort ,
coalesce ( t . business , 0 ) AS business
FROM airplanes a
LEFT JOIN t ON a . airplane_code = t . airplane_code
ORDER BY a . model ; 正如下一页清楚显示的,大型计划并不总是适合以文本形式处理。为了更清楚地查看计划,可以使用第三方工具;其中一个是 explain.tensor.ru。
注意,消除重复读取后,查询执行时间减少了多少,读取的页面数量也少了多少:
                         QUERY PLAN
------------------------------------------------------------
 Sort (actual rows=10.00 loops=1)
   Sort Key: ((ml.model ->> current_setting('bookings.la...
   Sort Method: quicksort  Memory: 25kB
   Buffers: shared hit=13059 read=37154
   CTE rf
     -> Hash Join (actual rows=37671.00 loops=1)
         Hash Cond: (f.route_no = r.route_no)
         Join Filter: (r.validity @> f.scheduled_departure)
         Rows Removed by Join Filter: 115016
         Buffers: shared hit=397 read=5
         -> Seq Scan on flights f (actual rows=37671.00 ...
             Buffers: shared hit=368
         -> Hash (actual rows=2030.00 loops=1)
             Buckets: 2048  Batches: 1  Memory Usage: 145kB
             Buffers: shared hit=29 read=5
             -> Seq Scan on routes r (actual rows=2030.0...
                 Buffers: shared hit=29 read=5
 ...
                   Buffers: shared hit=13059 read=37153
                   -> Hash Join (actual rows=5982418.00 ...
                       Hash Cond: ((rf.airplane_code = s...
                       Buffers: shared hit=13059 read=37153
                       -> Hash Join (actual rows=5982418...
                           Hash Cond: (bp.flight_id = rf...
                           Buffers: shared hit=13057 rea...
                           -> Seq Scan on boarding_passe...
                               Buffers: shared hit=12660...
                           -> Hash (actual rows=37671.00...
                               Buckets: 65536 (originall...
                               Buffers: shared hit=397 r...
                               -> CTE Scan on rf (actual...
                                   Storage: Memory  Maxi...
                                   Buffers: shared hit=3...
                       -> Hash (actual rows=1741.00 loop...
                           Buckets: 2048  Batches: 1  Me...
                           Buffers: shared hit=2 read=8
                           -> Seq Scan on seats s (actua...
                               Buffers: shared hit=2 read=8
 Planning:
   Buffers: shared hit=5 read=1
 Planning Time: 0.287 ms
 Execution Time: 1388.015 ms
(54 rows)
为了获得参照,统计相关主表的堆页数量:
SELECT sum ( relpages )
FROM pg_class
WHERE relname IN ( 'flights' , 'routes' , 'boarding_passes' ,
'seats' , 'airplanes' );
sum
-------
50212
( 1 row ) 对于需要全部行的查询,这个数字可以作为粗略的上限估计:如果处理的页面明显更多,可能说明同一批数据被扫描了多次。
在这个例子中,计划已经接近最优。它仍然可以改进,但幅度远不会像之前那样大。
参考资源 8 物化与函数了解物化、CTE、函数易变性、返回集合的函数、COST 和 ROWS 估计、规划器支持以及函数内联。
1. 物化 物化 (materialization)是指保存一个中间行集,以便再次使用,通常不止一次。保存的结果可以存在于不同范围内:一条查询内部、一个会话中,或者作为数据库对象存在。
大多数执行器节点以流水线方式工作。父节点向子节点请求下一行,请求沿着计划树向下传播。不过,有些节点需要读取全部输入、将其保存,然后反复读取保存的结果。PostgreSQL 使用 Materialize 节点完成这项工作。
物化的行集只要能够放进该操作可用的内存预算,就会保存在后端本地内存中。如果行集增长到超过预算,PostgreSQL 就会使用临时存储。temp_file_limit 限制单个 PostgreSQL 进程使用的临时文件空间;这一限制也适用于单个客户端会话内活动的各个并行工作进程。
在下图中,上层 Nested Loop 无法高效地参数化访问其内部输入。这个内部输入本身由另一个操作产生。
图 8.1 物化中间结果 如果每个外部行都重新计算一次,代价会很高,因此 PostgreSQL 可以先物化一次,然后重新扫描保存的行。
例如,查找机场对,其中一个机场使用莫斯科时间,另一个机场位于北极圈以北:
EXPLAIN ( costs off )
SELECT a1 . city , a2 . city
FROM airports a1 , airports a2
WHERE a1 . timezone = 'Europe/Moscow'
AND abs ( a2 . coordinates [ 1 ]) > 66 . 652 ;
QUERY PLAN
------------------------------------------------------------
Nested Loop
-> Seq Scan on airports_data ml_1
Filter : ( abs ( coordinates [ 1 ]) > '66.652' :: double p ...
-> Materialize
-> Seq Scan on airports_data ml
Filter : ( timezone = 'Europe/Moscow' :: text )
( 6 rows )
在这个例子中,内部谓词没有可用的索引。与针对每个外部行再次扫描和过滤内部结果相比,重复使用很小的内部结果代价更低。
CTE 物化 公用表表达式(common table expression,CTE)也称为 WITH 子查询,是组织查询并提高可读性的好方法。与普通子查询不同,使用 CTE 不会导致深层嵌套。
只要可能,规划器就会把 CTE 合并到父查询中,而不是将其物化。这样规划器就可以选择最佳的连接顺序。
默认情况下,CTE 会在以下情况下物化:
始终可以使用 AS MATERIALIZED 强制物化。
图 8.2 物化与内联的 CTE 计划 考虑一个只使用一次的 CTE:
EXPLAIN ( costs off )
WITH q AS (
SELECT r . route_no , a . airplane_code
FROM routes r
JOIN airplanes a ON a . airplane_code = r . airplane_code
)
SELECT *
FROM q
JOIN seats s ON s . airplane_code = q . airplane_code
WHERE s . seat_no = '1A' ;
QUERY PLAN
-------------------------------------------------------
Hash Join
Hash Cond : ( ml . airplane_code = s . airplane_code )
-> Hash Join
Hash Cond : ( r . airplane_code = ml . airplane_code )
-> Seq Scan on routes r
-> Hash
-> Seq Scan on airplanes_data ml
-> Hash
-> Seq Scan on seats s
Filter : ( seat_no = '1A' :: text )
( 10 rows )
这里没有 CTE Scan:CTE 已经直接合并进主查询。
强制物化:
EXPLAIN ( costs off )
WITH q AS MATERIALIZED (
SELECT r . route_no , a . airplane_code
FROM routes r
JOIN airplanes a ON a . airplane_code = r . airplane_code
)
SELECT *
FROM q
JOIN seats s ON s . airplane_code = q . airplane_code
WHERE s . seat_no = '1A' ;
QUERY PLAN
---------------------------------------------------------
Hash Join
Hash Cond : ( q . airplane_code = s . airplane_code )
CTE q
-> Hash Join
Hash Cond : ( r . airplane_code = ml . airplane_code )
-> Seq Scan on routes r
-> Hash
-> Seq Scan on airplanes_data ml
-> CTE Scan on q
-> Hash
-> Seq Scan on seats s
Filter : ( seat_no = '1A' :: text )
( 12 rows ) 现在,CTE 作为独立单元进行规划,父查询通过 CTE Scan 读取它。当计算代价高的结果会被重复使用时,物化通常是不错的选择。但如果父查询只需要大型 CTE 中极小的一部分,物化可能造成灾难性后果。
例如:
EXPLAIN ( analyze , costs off , buffers )
WITH b AS (
SELECT * FROM bookings
)
SELECT *
FROM b AS b1
JOIN b AS b2 ON b1 . book_ref = b2 . book_ref
WHERE b2 . book_ref = '000112' ;
QUERY PLAN
------------------------------------------------------------
Nested Loop ( actual time = 228 . 999 .. 229 . 000 rows = 0 . 00 loo ...
Buffers : shared read = 15856 , temp written = 9746
CTE b
-> Seq Scan on bookings ( actual time = 0 . 064 .. 71 . 089 ...
Buffers : shared read = 15856
-> CTE Scan on b b1 ( actual time = 228 . 999 .. 228 . 999 row ...
Filter : ( book_ref = '000112' :: bpchar )
Rows Removed by Filter : 2486710
Storage : Disk Maximum Storage : 77968 kB
Buffers : shared read = 15856 , temp written = 9746
-> CTE Scan on b b2 ( never executed )
Filter : ( book_ref = '000112' :: bpchar )
Storage : Disk Maximum Storage : 77968 kB
Planning :
Buffers : shared hit = 23 read = 1
Planning Time : 0 . 106 ms
Execution Time : 232 . 733 ms
( 17 rows ) 即使父查询只请求一个键,整张 bookings 表也会被物化。现在允许两个引用分别进行优化:
EXPLAIN ( analyze , costs off , buffers )
WITH b AS NOT MATERIALIZED (
SELECT * FROM bookings
)
SELECT *
FROM b AS b1
JOIN b AS b2 ON b1 . book_ref = b2 . book_ref
WHERE b2 . book_ref = '000112' ;
                         QUERY PLAN
------------------------------------------------------------
 Nested Loop (actual time=0.020..0.020 rows=0.00 loops=1)
   Buffers: shared read=3
   -> Index Scan using bookings_pkey on bookings (actual...
       Index Cond: (book_ref = '000112'::bpchar)
       Index Searches: 1
       Buffers: shared read=3
   -> Index Scan using bookings_pkey on bookings booking...
       Index Cond: (book_ref = '000112'::bpchar)
       Index Searches: 0
 Planning:
   Buffers: shared hit=5
 Planning Time: 0.075 ms
 Execution Time: 0.028 ms
(13 rows)
现在规划器可以把键限制下推到两次扫描中,并使用主键索引。将这个版本的 Buffers 值与前一个版本进行比较。
不过,如果 CTE 修改数据,它无论如何都会物化:修改必须恰好发生一次。
临时表 如果数据必须被多条查询复用,就不能在一个 CTE 中为所有查询计算它,但可以把数据放进临时表,供这些查询使用。临时表有几个有用的性质:
它们的缓冲区是后端本地缓冲区,而不是共享缓冲区的一部分。 临时表并非没有代价。PostgreSQL 仍然会创建系统目录条目和关系文件。
以极高频率创建和删除临时表的工作负载,可能给系统目录和文件系统带来压力。某些应用生态过去曾携带 PostgreSQL 补丁或采用专门设计来降低这项开销;这是应用特定的工程问题,不是一般性避免临时表的理由。
temp_buffers 限制一个会话可用于临时关系的本地缓冲区内存量。只有在会话首次访问临时表之前,才能修改它的值。
创建一张包含北半球机场的临时表:
CREATE TEMP TABLE airports_nh -- Northern Hemisphere
ON COMMIT PRESERVE ROWS -- default
AS SELECT *
FROM airports
WHERE coordinates [ 1 ] > 0 ;
SELECT 4328 该表会创建在临时的 pg_temp 模式中。
在使用新填充的临时表执行查询之前,对它进行分析通常是有意义的。后端进程的本地内存对 autovacuum 进程不可见,因此必须手动清理和分析临时表。
比较运行分析前后的基数估计:
EXPLAIN SELECT *
FROM airports_nh ;
QUERY PLAN
------------------------------------------
Seq Scan on airports_nh
( cost = 0 . 00 .. 91 . 52 rows = 2752 width = 160 )
( 2 rows )
ANALYZE airports_nh ;
EXPLAIN SELECT *
FROM airports_nh ;
QUERY PLAN
------------------------------------------
Seq Scan on airports_nh
( cost = 0 . 00 .. 107 . 28 rows = 4328 width = 63 )
( 2 rows )
物化视图 物化视图是一个命名的查询结果,作为数据库关系存储。可以像查询普通只读表一样查询它。
可以在物化视图上创建索引,但不能添加完整性约束:约束必须在基表上检查。PostgreSQL 也会为物化视图收集规划器统计信息。
与普通视图不同,基表发生变化时,物化视图中的行不会改变。刷新操作是显式执行的。
完整刷新可能代价很高。当前 PostgreSQL 核心不会随着基表变化逐行增量维护物化视图。Yugo Nagata 的 pg_ivm 扩展为受支持的情况实现了增量视图维护。
在 airports 上创建物化视图:
CREATE MATERIALIZED VIEW airports_mv AS
SELECT * FROM airports ;
SELECT 5501 创建索引:
CREATE UNIQUE INDEX ON airports_mv ( airport_code );
EXPLAIN ( costs off ) SELECT *
FROM airports_mv
ORDER BY airport_code
LIMIT 3 ;
QUERY PLAN
------------------------------------------------------------
Limit
-> Index Scan using airports_mv_airport_code_idx on a ...
( 2 rows ) 现在修改一个基表值。2025 年 8 月,马纳斯国际机场把 IATA 代码从 FRU 改为 BSZ;演示数据库允许我们把它作为一个方便的例子。
UPDATE airports_data
SET airport_code = 'BSZ'
WHERE airport_code = 'FRU' ;
UPDATE 1
SELECT count ( * )
FROM airports_mv
WHERE airport_code = 'BSZ' ;
count
-------
0
( 1 row ) 保存的物化视图行不会改变。同步是显式操作;刷新物化视图:
REFRESH MATERIALIZED VIEW CONCURRENTLY airports_mv;
SELECT count ( * ) FROM airports_mv
WHERE airport_code = 'BSZ' ;
count
-------
1
( 1 row ) 2. 函数
易变性类别 每个函数都有一个易变性类别(volatility category)。这个类别是就函数行为向优化器 作出的一项承诺 。
VOLATILE 是默认值。易变函数在参数相同的连续调用中可能返回不同结果,也可能具有副作用。PostgreSQL 不能假定两次调用可以互相替换。
STABLE 承诺,对于相同参数,函数在一条语句的整个执行期间返回相同结果,并且不修改数据库。这样的函数可以在查询执行期间执行一次,然后复用计算出的值。
IMMUTABLE 更强:它承诺相同参数的结果永远相同。因此,可以在规划期间折叠常量调用。
这些标签只是允许优化器采用某些处理方式,并不规定精确的执行调度。STABLE 并不意味着每个稳定函数都一定严格执行一次;它意味着只要计划允许,优化器就可以把重复的相同参数求值视为等价。
错误的标签可能产生错误结果。如果函数依赖时间、配置、表内容或其他会变化的状态,却把它标记为 IMMUTABLE,就可能把过时的值冻结在可复用的计划中。
创建一个 random() 的封装函数:
CREATE FUNCTION rnd () RETURNS float
LANGUAGE sql VOLATILE
RETURN random (); 使用正确的 VOLATILE 标签时,谓词会针对每行求值:
EXPLAIN ( costs off )
SELECT * FROM generate_series ( 1 , 10 ) WHERE rnd () > 0 . 5 ;
QUERY PLAN
------------------------------------------------
Function Scan on generate_series
Filter : ( random () > '0.5' :: double precision )
( 2 rows ) 一次运行可能返回十行中的任意子集:
SELECT * FROM generate_series ( 1 , 10 ) WHERE rnd () > 0 . 5 ;
generate_series
-----------------
1
3
4
9
10
( 5 rows ) 现在对 PostgreSQL 撒个谎:
ALTER FUNCTION rnd () STABLE ;
EXPLAIN ( costs off )
SELECT * FROM generate_series ( 1 , 10 ) WHERE rnd () > 0 . 5 ;
QUERY PLAN
------------------------------------------------------
Result
One - Time Filter : ( rnd () > '0.5' :: double precision )
-> Function Scan on generate_series
( 3 rows ) 在这个计划中,稳定表达式变成了一个 One-Time Filter,因此结果要么是全部十行,要么是一行也没有:
SELECT * FROM generate_series ( 1 , 10 ) WHERE rnd () > 0 . 5 ;
generate_series
-----------------
( 0 rows ) 把封装函数标记为 IMMUTABLE 会给规划器更多自由:
ALTER FUNCTION rnd () IMMUTABLE ;
EXPLAIN ( costs off )
SELECT * FROM generate_series ( 1 , 10 ) WHERE rnd () > 0 . 5 ;
QUERY PLAN
--------------------------
Result
One - Time Filter : false
( 2 rows )
EXPLAIN ( costs off )
SELECT * FROM generate_series ( 1 , 10 ) WHERE rnd () > 0 . 5 ;
QUERY PLAN
---------------------------------
Function Scan on generate_series
( 2 rows ) 两次独立的规划尝试可能冻结不同的随机结果。令人意外的计划并不是 PostgreSQL 的错误:是我们给了优化器一份虚假的契约。
函数内联 PostgreSQL 可以把符合条件的 SQL 语言函数的函数体内联到外围查询中,对标量函数和返回集合的函数(set-returning function)都可以这样做。两种情况都有许多限制:函数必须使用 SQL 编写,只能使用一条 SELECT 语句,并且还要满足其他条件。标量函数不能访问数据库表,也不能调用易变性类别更宽松的函数;返回集合的函数必须是 STABLE 或 IMMUTABLE。
内联很重要,因为从规划器的角度看,它会移除函数边界。这样,外围查询中的谓词有时就可以下推到函数体中,连接也可以跨越原来的边界重新排序。
简单标量 SQL 函数的函数体可以在规划前直接替换进主 SQL 语句。在这种情况下,不存在函数调用开销。
对于标量 SQL 函数,限制包括易变性的一致性。声明为 STABLE 的函数不能安全地内联调用 random() 这类易变操作的函数体。将 rnd() 标记为 STABLE:
ALTER FUNCTION rnd () STABLE ;
EXPLAIN ( costs off )
SELECT * FROM generate_series ( 1 , 10 ) WHERE rnd () > 0 . 5 ;
QUERY PLAN
------------------------------------------------------
Result
One - Time Filter : ( rnd () > '0.5' :: double precision )
-> Function Scan on generate_series
( 3 rows ) 封装函数仍然可见。
恢复真实的易变性:
ALTER FUNCTION rnd () VOLATILE ;
EXPLAIN ( costs off )
SELECT * FROM generate_series ( 1 , 10 ) WHERE rnd () > 0 . 5 ;
QUERY PLAN
------------------------------------------------
Function Scan on generate_series
Filter : ( random () > '0.5' :: double precision )
( 2 rows ) 现在过滤条件直接引用 random(),绕过了 rnd() 封装函数。
调用返回集合的函数 当返回集合的函数作为表表达式出现在 FROM 中时,PostgreSQL 使用 Function Scan 表示它。在这种情况下,函数返回的所有行都会先物化,然后才传给父计划节点。这是当前实现的限制。
当返回集合的表达式出现在目标列表中时,PostgreSQL 使用 ProjectSet,可以按需产生行。SQL 函数、以 C 编写的大多数内置函数,以及返回迭代器的 PL/Python 函数都以这种方式工作。如果语言实现支持相同接口,其他编程语言中的函数也可以采用这种方式。
在 LIMIT 下,两者的差异可能非常大。在 FROM 中调用 generate_series:
EXPLAIN ( analyze , costs off , buffers off )
SELECT * FROM generate_series ( 1 , 10 _000_000 )
LIMIT 10 ;
                         QUERY PLAN
------------------------------------------------------------
 Limit (actual time=290.495..290.497 rows=10.00 loops=1)
   -> Function Scan on generate_series (actual time=290....
 Planning Time: 0.025 ms
 Execution Time: 296.988 ms
(4 rows)
现在把返回集合的函数放入目标列表:
EXPLAIN ( analyze , costs off , buffers off )
SELECT generate_series ( 1 , 10 _000_000 )
LIMIT 10 ;
QUERY PLAN
------------------------------------------------------------
Limit ( actual time = 0 . 002 .. 0 . 003 rows = 10 . 00 loops = 1 )
-> ProjectSet ( actual time = 0 . 001 .. 0 . 002 rows = 10 . 00 lo ...
-> Result ( actual time = 0 . 000 .. 0 . 000 rows = 1 . 00 loo ...
Planning Time : 0 . 020 ms
Execution Time : 0 . 010 ms
( 5 rows ) 在第一个计划中,Function Scan 在应用 Limit 之前从函数获取全部行。在第二个计划中,ProjectSet 只产生十行——正好是 Limit 请求的数量。
图 8.3 Function Scan 与 ProjectSet
查询执行时间下降了几个数量级。Result 节点表示被省略的 FROM 子句,并向父节点恰好传递一行。
这并不意味着所有函数语言都能流式产生行。例如,PL/pgSQL 返回集合的函数当前会在将完整结果返回给调用方的执行器接口之前,先将结果全部物化。
CREATE FUNCTION plpgsql_rows () RETURNS SETOF integer
AS $$
BEGIN
RETURN QUERY
SELECT * FROM generate_series ( 1 , 10 _000_000 );
END
$$ LANGUAGE plpgsql ;
CREATE FUNCTION
EXPLAIN ( analyze , costs off , buffers off )
SELECT plpgsql_rows () LIMIT 10 ;
QUERY PLAN
------------------------------------------------------------
Limit ( actual time = 652 . 500 .. 652 . 502 rows = 10 . 00 loops = 1 )
-> ProjectSet ( actual time = 652 . 499 .. 652 . 500 rows = 10 . 0 ...
-> Result ( actual time = 0 . 000 .. 0 . 000 rows = 1 . 00 loo ...
Planning Time : 0 . 020 ms
Execution Time : 660 . 376 ms
( 5 rows ) 计划仍然包含 ProjectSet,但函数实现已经在第一行产生之前完成了昂贵工作。执行时间清楚地显示了这一点。
COST 和 ROWS 函数无法内联时,规划器通常只能把它基本当成黑盒。CREATE FUNCTION 允许我们提供两个重要的估计值。
COST 是以 cpu_operator_cost 为单位的估计执行代价。对于返回集合的函数,它表示每个返回行的代价。对于 C 语言函数和内部函数,默认值是 1;对于其他语言的函数,默认值是 100。
ROWS 是返回集合的函数预计返回的行数。默认值是 1000。
图 8.4 函数 COST 和 ROWS 估计 创建一个返回一周各日名称的 PL/pgSQL 函数:
CREATE FUNCTION days_of_week () RETURNS SETOF text
AS $$
BEGIN
FOR i IN 7 .. 13 LOOP
RETURN NEXT to_char ( to_date ( i :: text , 'J' ), 'TMDy' );
END LOOP ;
END ;
$$ LANGUAGE plpgsql ;
CREATE FUNCTION
SELECT * FROM days_of_week ();
days_of_week
--------------
Mon
Tue
Wed
Thu
Fri
Sat
Sun
( 7 rows ) 查询计划:
EXPLAIN SELECT * FROM days_of_week ();
QUERY PLAN
-----------------------------------------
Function Scan on days_of_week
( cost = 0 . 25 .. 10 . 25 rows = 1000 width = 32 )
( 2 rows ) 服务器把这个函数结果的基数估计为 1000 行,尽管实际值为 7。
启动部分反映函数代价估计:
SELECT 100 * current_setting ( 'cpu_operator_cost' ):: float ;
? column ?
----------
0 . 25
( 1 row ) 提高函数代价:
ALTER FUNCTION days_of_week COST 10000 ;
EXPLAIN SELECT * FROM days_of_week ();
QUERY PLAN
------------------------------------------
Function Scan on days_of_week
( cost = 25 . 00 .. 35 . 00 rows = 1000 width = 32 )
( 2 rows )
设置函数预计返回的行数:
ALTER FUNCTION days_of_week ROWS 10 ;
EXPLAIN SELECT * FROM days_of_week ();
QUERY PLAN
----------------------------------------
Function Scan on days_of_week
( cost = 25 . 00 .. 25 . 10 rows = 10 width = 32 )
( 2 rows ) 得到的估计代价为:
SELECT 10000 * current_setting ( 'cpu_operator_cost' ):: float
+ 10 * current_setting ( 'cpu_tuple_cost' ):: float ;
? column ?
----------
25 . 1
( 1 row ) 在 pg_proc 中或通过元命令检查这些值:
SELECT procost , prorows
FROM pg_proc WHERE proname = 'days_of_week' ;
procost | prorows
---------+---------
10000 | 10
( 1 row ) \ sf days_of_week
CREATE OR REPLACE FUNCTION bookings . days_of_week ()
RETURNS SETOF text
LANGUAGE plpgsql
COST 10000 ROWS 10
AS $ function $
BEGIN
FOR i IN 7 .. 13 LOOP
RETURN NEXT to_char ( to_date ( i :: text , 'J' ), 'TMDy' );
END LOOP ;
END ;
$ function $
规划器支持函数 COST 和 ROWS 子句允许我们把函数代价和行数指定为常量。不过,固定值并不总是足够好。
在 PostgreSQL 中,目标函数可以拥有一个规划器支持函数 (planner support function),根据目标函数的参数值向规划器提供相关信息。
图 8.5 感知参数的规划器支持 规划器支持函数可以提供以下信息(以及其他信息):
函数代价估计;
返回行数估计;
与函数调用等价的表达式。
对于 boolean 函数,它还可以提供:
规划器支持函数使用 PostgreSQL 的内部规划器 API,目前必须用 C 编写。
并行安全标签 并非每个查询都能并行运行。规划器无法安全推断用户定义函数的所有可能影响。因此,并行执行依赖显式的函数标签。
函数可以是:
PARALLEL UNSAFE:它的存在会阻止查询使用并行计划;
PARALLEL RESTRICTED:它可以参与使用并行的查询,但只能在并行组领导者中执行;
PARALLEL SAFE:它可以在并行工作进程中执行。
用户定义函数的默认值是 PARALLEL UNSAFE。用户定义的聚合函数也会指定并行安全标签。
所有基本标准函数都是并行安全的。
SELECT proparallel , count ( * )
FROM pg_proc
GROUP BY proparallel ;
proparallel | count
-------------+-------
r | 202
s | 3374
u | 109
( 3 rows )
具体数量取决于已安装的扩展和 PostgreSQL 小版本。
psql 也会显示这个标签:
\x \df+ random numeric \x
Expanded display is on.
List of functions
-[ RECORD 1 ]-------+-------------------------
Schema | pg_catalog
Name | random
Result data type | numeric
Argument data types | min numeric, max numeric
Type | func
Volatility | volatile
Parallel | restricted
Owner | postgres
Security | invoker
Leakproof? | no
Access privileges |
Language | internal
Internal name | numeric_random
Description | random numeric in range
Expanded display is off. 现在创建一个函数,计算一张机票对应的航段价格总和:
CREATE FUNCTION ticket_price ( ticket_no char ( 13 ))
RETURNS numeric
LANGUAGE plpgsql STABLE PARALLEL SAFE
AS $$
BEGIN
RETURN ( SELECT sum ( price )
FROM segments s
WHERE s . ticket_no = ticket_price . ticket_no
);
END ;
$$ ;
CREATE FUNCTION
在一个子查询中使用它,并将该总和与另一个子查询得到的预订总金额进行比较:
EXPLAIN ( costs off ) SELECT
( SELECT sum ( ticket_price ( ticket_no )) FROM tickets ) =
( SELECT sum ( total_amount ) FROM bookings );
QUERY PLAN
--------------------------------------------------
Result
InitPlan 1
-> Finalize Aggregate
-> Gather
Workers Planned : 2
-> Partial Aggregate
-> Parallel Seq Scan on tickets
InitPlan 2
-> Finalize Aggregate
-> Gather
Workers Planned : 2
-> Partial Aggregate
-> Parallel Seq Scan on bookings
( 13 rows ) 函数标记为安全后,两个子查询都可以使用并行计划。
将它标记为不安全:
ALTER FUNCTION ticket_price PARALLEL UNSAFE ;
EXPLAIN ( costs off ) SELECT
( SELECT sum ( ticket_price ( ticket_no )) FROM tickets ) =
( SELECT sum ( total_amount ) FROM bookings );
QUERY PLAN
---------------------------------
Result
InitPlan 1
-> Aggregate
-> Seq Scan on tickets
InitPlan 2
-> Aggregate
-> Seq Scan on bookings
( 7 rows )
一个不安全函数就会禁用该语句的并行查询。
现在把它标记为受限:
ALTER FUNCTION ticket_price PARALLEL RESTRICTED ;
EXPLAIN ( costs off ) SELECT
( SELECT sum ( ticket_price ( ticket_no )) FROM tickets ) =
( SELECT sum ( total_amount ) FROM bookings );
QUERY PLAN
--------------------------------------------------
Result
InitPlan 1
-> Aggregate
-> Seq Scan on tickets
InitPlan 2
-> Finalize Aggregate
-> Gather
Workers Planned : 2
-> Partial Aggregate
-> Parallel Seq Scan on bookings
( 10 rows ) 调用受限函数的子查询必须在领导者中运行,而独立的 bookings 子查询仍然可以使用并行工作进程。
安全标签不只是性能提示。错误标记函数可能导致报错或返回错误结果。如果不确定,应使用更严格的标签。
参考资源 9 调优方法完成查询调优:度量工作负载,改进数据访问和估计,减少不必要的工作,并考察替代的查询形式。
1. 应该调优什么? 性能是整个信息系统的属性,而不仅是一条 SQL 语句的属性。
图 9.1 系统性能的层次 本书不打算详细介绍下面两个重要的底层:硬件和操作系统。PostgreSQL 最终要通过操作系统和文件系统访问存储,而延迟、带宽、持久性特征、缓存层次、虚拟化层和存储拓扑都会影响数据库行为。如果底层资源不足或配置不当,SQL 调优无法无限期地弥补这些问题。
在 PostgreSQL 服务器层面,目标是合理分配资源,保持维护工作健康运行,并让规划器获得符合机器和数据实际情况的模型。在应用层面,连接管理、请求形态、模式设计和往返次数,可能与某一条执行计划同样重要。
最后,还可以对单条查询进行性能剖析和调优。开发人员通常从当前正在编写的查询开始;管理员通常从消耗系统资源份额最大的查询开始。
第七章“性能剖析”
2. 服务器调优
CPU 和 I/O 资源 并行查询使 PostgreSQL 能够为计划中符合条件的部分使用多个 CPU 核心。主要的工作进程上限为:
这些是上限,不是承诺。计划可能请求在执行时不可用的工作进程,更多工作进程也不一定更好。每个并行工作进程都是一个真正的 PostgreSQL 进程,会消耗 CPU、内存和 I/O 带宽。应用开发中使用后台进程的内容见 DEV2 课程的“后台进程”一课。
两个 I/O 设置至关重要:可以并发运行的操作数量(普通工作使用 effective_io_concurrency,维护工作使用 maintenance_io_concurrency),以及一次操作能够读取的连续页数(io_combine_limit)。
通过 io_method 可以使用多种异步 I/O 实现,还有若干更细的设置。调优这些设置时,要考虑服务器 I/O 子系统的能力和工作负载概况。
内存 work_mem 决定单个操作可用的内存量。对应章节中已经讨论过它。它还会影响计划选择:取值较小时,规划器可能更倾向于排序而非哈希,因为排序算法对内存不足不那么敏感。对于使用哈希的操作,可以用 hash_mem_multiplier 提高内存上限。
maintenance_work_mem 会影响索引创建速度和维护进程的工作。
shared_buffers 参数决定缓冲区缓存的大小。
在任何 OLTP 数据库中,无论规模多大,通常都有一组相当紧凑的活跃数据。如果 shared_buffers 设置得太小,这些数据就无法放入缓冲区缓存,页面会不断被驱逐,从而给 I/O 带来压力(虽然操作系统页缓存可以在一定程度上缓解这一点)。但把缓冲区缓存做得太大也不是好主意,因为维护它的开销也会相应增加。
因此,最佳缓冲区缓存大小取决于许多因素:不存在一个适用于所有系统、可以用来选择 shared_buffers 值的通用公式。DBA2 课程会介绍这个参数的调优,但有一点可以确定:默认值小得远远不够。
effective_cache_size 告诉 PostgreSQL 可以缓存的数据总量,包括缓冲区缓存和操作系统缓存中的数据。这个值越大,索引访问对规划器就越有吸引力。该参数不会分配内存。
物理放置 即使 SQL 模式保持不变,物理组织也会影响性能。
表空间 可以把选定的关系或索引放到不同的存储设备上。例如,可以把频繁使用的数据存储在 SSD 上,把归档数据存储在速度较慢的 HDD 上。如果确实有用,表空间专用的规划器参数(如 random_page_cost 和 effective_io_concurrency)可以描述不同的设备。
分区 使处理超大规模数据成为可能。主要的性能收益来自用扫描单个分区替代扫描整张表。分区也可以放在不同的表空间中。
分片 是另一种选择:可以把分区分布到不同服务器上,并能够运行分布式查询。标准 PostgreSQL 只包含设置分片所需的基本机制:分区和 postgres_fdw 扩展。借助
规划器统计信息 规划器依赖统计信息进行估计,正如 第六章“统计信息”
统计信息也需要足够准确。绝对准确无法实现(也没有必要),但误差不应大到产生错误的计划。统计信息过时或不准确的迹象之一,是叶计划节点中的预期行数与实际行数严重不匹配。
为了提高准确性,可能需要更改统计目标,可以是全局更改,也可以针对单个表列。有时表达式索引会很有用,因为它拥有自己的统计信息。在某些情况下,还可以使用扩展统计信息。
规划器代价模型 规划器代价参数描述机器和工作负载的相对关系。它们不是用来预测以毫秒计的运行时间的。
seq_page_cost 为 1,通常应保持不变。random_page_cost 的默认值相对较高(4),体现了典型 HDD 的特征。对于 SSD,以及数据很可能
CPU 代价参数定义了处理已读取数据时所用的代价权重。它们通常保持不变,因为很难预测修改它们的影响。不过,正如我们在 第八章“物化与函数” cpu_operator_cost 单位指定用户自定义函数的代价。
当具有代表性的查询显示出系统性的建模误差,特别是在基数估计已经良好的情况下,可以更改代价参数。例如:
EXPLAIN ( analyze , timing off , buffers off )
SELECT * FROM bookings
WHERE book_ref < 'E00000' ;
QUERY PLAN
----------------------------------------------
Seq Scan on bookings
( cost = 0 . 00 .. 46939 . 88 rows = 994271 width = 21 )
( actual rows = 967421 . 00 loops = 1 )
Filter : ( book_ref < 'E00000' :: bpchar )
Rows Removed by Filter : 1519289
Planning Time : 0 . 093 ms
Execution Time : 101 . 680 ms
( 7 rows ) 行数估计很准确。规划器拥有足够的统计信息,并选择了顺序扫描。
为了诊断,临时降低顺序扫描的优先级。enable_* 参数被有意设计为粗粒度控制:它们并不保证在所有情况下都能排除包含某种节点类型的全部计划,而是强烈抑制对这种方式的选择。
SET enable_seqscan = off ; -- until the end of the session 它们最适合用于实验:“PostgreSQL 认为下一个最佳计划是什么?它实际表现如何?”
现在,同一查询使用位图访问:
EXPLAIN ( analyze , timing off , buffers off )
SELECT * FROM bookings
WHERE book_ref < 'E00000' ;
QUERY PLAN
--------------------------------------------------
Bitmap Heap Scan on bookings
( cost = 18618 . 03 .. 46902 . 42 rows = 994271 width = 21 )
( actual rows = 967421 . 00 loops = 1 )
Recheck Cond : ( book_ref < 'E00000' :: bpchar )
Heap Blocks : exact = 15839
-> Bitmap Index Scan on bookings_pkey
( cost = 0 . 00 .. 18369 . 46 rows = 994271 width = 0 )
( actual rows = 967422 . 00 loops = 1 )
Index Cond : ( book_ref < 'E00000' :: bpchar )
Index Searches : 1
Planning Time : 0 . 044 ms
Execution Time : 88 . 419 ms
( 12 rows )
RESET enable_seqscan ; 结果很可能会偏向索引扫描,因为所有数据都已缓存,随机访问很快。使用快速 SSD 时也可能出现同样情况。
仅根据一条查询得出结论是不对的,但如果这种误差反复出现,就有理由调查全局设置。在这种情况下,可以尝试降低 random_page_cost,使规划器不再高估索引访问的代价;也可以提高 effective_cache_size,使索引扫描更具吸引力。
3. 应用调优
客户端与连接 打开数据库连接并非没有成本,PostgreSQL 后端进程会产生可观的内存和调度成本。大量创建短生命周期连接的应用通常会受益于连接池。不过,连接池会对应用施加某些限制。DEV2 课程会介绍这个主题。
游标适用于应用确实只需要结果的开头一部分,或者逐步消费结果的场景。cursor_tuple_fraction 告诉规划器预计会获取游标行的大致比例,这可能改变启动代价与总代价之间的权衡。
另一个常见性能问题不是一条缓慢的 SQL 语句,而是数千条各自执行很快的语句。ORM 可能产生这种模式,例如通过 N + 1 查询行为。回到 第七章“性能剖析”
在这种情况下,数据库服务器几乎没有优化手段(预备语句可以降低重复查询的开销,这算是例外)。
在这种情况下,有效做法是去掉应用中的过程式代码,把工作移到数据库服务器,由少量更大的 SQL 命令完成。这样规划器有机会使用更高效的访问和连接方法,也能避免客户端与服务器之间大量传输数据。遗憾的是,这种改动可能代价很高。
数据模型 在逻辑层面 ,数据库应当规范化 :非正式地说,存储的数据不应冗余。否则就是设计错误,因为检查数据一致性会变得困难,还可能出现各种更新异常。
在存储层面 ,有时可以为了性能而有意引入冗余,前提是系统有明确的机制保持冗余数据一致。
索引是最常见的例子:它们把表中的信息复制到另一种物理结构中,而 PostgreSQL 会自动维护这些索引。
其他形式包括生成列、由触发器维护的值以及物化视图。应用层也可以通过缓存查询结果来复制数据。这是一种常用技术,但应用经常因为与数据库配合不佳而使用它,例如通过 ORM。于是应用就要负责及时更新缓存、控制缓存数据的访问权限,以及处理相关的一致性问题。
选择正确的数据类型 也是查询优化的一部分。例如,用 daterange 或 tstzrange 等 PostgreSQL 范围类型表示区间,可以直接表达区间语义,并为重叠等操作提供 GiST 或 SP-GiST 索引。
数组和 JSON 有时可以避免连接并减少元组头开销,但它们也会改变约束、统计信息、更新粒度、索引和查询语义。使用复杂类型应当是因为它们符合数据模型,而不只是为了避免一次连接。
完整性约束 首先关乎正确性。它们还可以为规划器提供有用的保证:
主键和唯一约束会带有唯一索引,并保证所有键列值都不重复(统计信息准确)。这些保证也能让连接更高效。
在某些情况下,外键与 NOT NULL 约束结合可以消除不必要的连接,这对视图尤其重要;当连接跨越多个列时,还能改进选择率估计。
CHECK 约束与 constraint_exclusion 参数结合,可以在确定表(或分区)不可能包含所需数据时,避免扫描它们。
下面是一个在复合键上连接时得到准确基数估计的例子:
EXPLAIN SELECT * FROM segments s
JOIN boarding_passes bp ON s . flight_id = bp . flight_id
AND s . ticket_no = bp . ticket_no ;
QUERY PLAN
------------------------------------------------------------
Hash Join ( cost = 275309 . 45 .. 625075 . 75 rows = 5982418 widt ...
Hash Cond : (( s . flight_id = bp . flight_id ) AND ( s . ticke ...
-> Seq Scan on segments s
( cost = 0 . 00 .. 134750 . 62 rows = 7349462 width = 31 )
-> Hash ( cost = 109624 . 18 .. 109624 . 18 rows = 5982418 widt ...
-> Seq Scan on boarding_passes bp
( cost = 0 . 00 .. 109624 . 18 rows = 5982418 width = 80 )
( 7 rows ) 不过,如果删除外键,估计就会变得不准确。这是相关谓词问题的另一种表现:
BEGIN ;
ALTER TABLE boarding_passes
DROP CONSTRAINT boarding_passes_ticket_no_flight_id_fkey ;
EXPLAIN SELECT * FROM segments s
JOIN boarding_passes bp ON s . flight_id = bp . flight_id
AND s . ticket_no = bp . ticket_no ;
QUERY PLAN
------------------------------------------------------------
Hash Join ( cost = 275309 . 45 .. 625075 . 75 rows = 504 width = 111 )
Hash Cond : (( s . flight_id = bp . flight_id ) AND ( s . ticke ...
-> Seq Scan on segments s
( cost = 0 . 00 .. 134750 . 62 rows = 7349462 width = 31 )
-> Hash ( cost = 109624 . 18 .. 109624 . 18 rows = 5982418 widt ...
-> Seq Scan on boarding_passes bp
( cost = 0 . 00 .. 109624 . 18 rows = 5982418 width = 80 )
( 7 rows )
ROLLBACK ; 4. 查询
通往优化的路径 查询调优的直接目标是获得足够好的执行计划,但有多种途径可以做到。
一种方法是战术性的:检查糟糕的计划,找出错误选择,然后强制或引导采用替代方案。遗憾的是,罪魁祸首并不总是显而易见,调优往往会变成与规划器较劲。如果走这条路,你会希望能够完全或部分禁用规划器,自己构建执行计划。这项功能称为提示(hint),而 PostgreSQL 没有显式提供它。
另一种方法是解释性的:找出规划器为何认为糟糕的计划代价很低。修正基数
第二种方法更稳健,因为当数据和条件变化时,它保留了规划器的自由度,但这种方法并不总是容易。有时生产事故首先需要一个战术性的临时解决方案。
两种方法都有用。区别在于你是在修正规划器掌握的信息,还是在约束它的选择。
短查询 这里的“短”和“长”是非正式分类,不是 PostgreSQL 的正式概念。
短查询 常见于对延迟敏感的 OLTP 工作中:它读取少量数据,通常返回几行。它也可能访问超大表,但其谓词通常具有高选择率 :只有很小一部分输入行符合条件。
短查询通常服务于用户界面,因此尽快执行非常重要。响应时间优先。
典型的高效构件包括:扫描很小的关系;对大型关系进行索引查找;使用低代价参数化内部探测的嵌套循环。
连接通常使用嵌套循环执行。与哈希连接不同,嵌套循环不需要准备工作;当连接的行数很少时,它的效果很好。考虑一个返回某个特定小时内预订的航段列表的查询。对于这个短查询示例,我们禁用并行执行。
考虑一个返回在一小时时间区间内起飞航班的登机牌的查询(由于并行执行对这个短查询没有用处,因此禁用它):
SET max_parallel_workers_per_gather = 0 ;
EXPLAIN ( analyze , timing off )
SELECT t . *
FROM bookings b
JOIN tickets t ON t . book_ref = b . book_ref
WHERE date_trunc ( 'hour' , b . book_date ) =
'2025-11-01 12:00:00+03' ;
QUERY PLAN
------------------------------------------------------------
Hash Join ( cost = 53312 . 08 .. 181808 . 82 rows = 27993 width = 52 )
( actual rows = 1338 . 00 loops = 1 )
Hash Cond : ( t . book_ref = b . book_ref )
Buffers : shared hit = 12738 read = 60934
-> Seq Scan on tickets t
( cost = 0 . 00 .. 113800 . 73 rows = 5598473 width = 52 )
( actual rows = 5598473 . 00 loops = 1 )
Buffers : shared read = 57816
-> Hash ( cost = 53156 . 65 .. 53156 . 65 rows = 12434 width = 7 )
( actual rows = 567 . 00 loops = 1 )
Buckets : 16384 Batches : 1 Memory Usage : 150 kB
Buffers : shared hit = 12738 read = 3118
-> Seq Scan on bookings b
( cost = 0 . 00 .. 53156 . 65 rows = 12434 width = 7 )
( actual rows = 567 . 00 loops = 1 )
Filter : ( date_trunc ( 'hour' :: text , book_date ) ...
Rows Removed by Filter : 2486143
Buffers : shared hit = 12738 read = 3118
Planning :
Buffers : shared hit = 172 read = 18
Planning Time : 0 . 704 ms
Execution Time : 380 . 957 ms
( 22 rows ) 这是一个短查询:它只需要两个大表中远少于百分之一的数据。然而两个表都被完整扫描,估计基数与实际值相差很大。
从 bookings 上最内层的 Seq Scan 开始。问题在于 date_trunc:它没有规划器支持函数,因此 PostgreSQL 使用固定的 0.5% 选择率估计。
EXPLAIN ( analyze , timing off , buffers off , summary off )
SELECT * FROM bookings b
WHERE b . book_date >= '2025-11-01 12:00:00+03'
AND b . book_date < '2025-11-01 13:00:00+03' ;
QUERY PLAN
------------------------------------------------------------
Seq Scan on bookings b
( cost = 0 . 00 .. 53156 . 65 rows = 546 width = 21 )
( actual rows = 567 . 00 loops = 1 )
Filter : (( book_date >= '2025-11-01 12:00:00+03' :: time ...
Rows Removed by Filter : 2486143
( 5 rows ) 现在估计接近实际,但 PostgreSQL 仍没有可以避免扫描该表的访问路径。创建一个:
CREATE INDEX ON bookings ( book_date );
EXPLAIN ( analyze , timing off )
SELECT t . * FROM bookings b
JOIN tickets t ON t . book_ref = b . book_ref
WHERE b . book_date >= '2025-11-01 12:00:00+03'
AND b . book_date < '2025-11-01 13:00:00+03' ;
QUERY PLAN
------------------------------------------------------------
Nested Loop ( cost = 0 . 99 .. 13265 . 14 rows = 1229 width = 52 ) (...
Buffers : shared hit = 2630 read = 782
-> Index Scan using bookings_book_date_idx on booking ...
Index Cond : (( book_date >= '2025-11-01 12:00:00+0...
Index Searches: 1
Buffers: shared hit=542 read=5
-> Index Scan using tickets_book_ref_passenger_id_out...
Index Cond: (book_ref = b.book_ref)
Index Searches: 567
Buffers: shared hit=2088 read=777
Planning:
Buffers: shared hit=46 read=1
Planning Time: 0.153 ms
Execution Time: 128.876 ms
(14 rows)
这正是我们想要的:规划器选择了索引扫描,并使用嵌套循环连接数据。
一种可能的改进是完全不访问 bookings 表,只扫描索引。将连接键包含在索引中,就能使其成为覆盖索引,满足第一次查找的需要:
DROP INDEX bookings_book_date_idx ;
CREATE INDEX ON bookings ( book_date ) INCLUDE ( book_ref );
EXPLAIN ( analyze , timing off )
SELECT t . *
FROM bookings b
JOIN tickets t ON t . book_ref = b . book_ref
WHERE b . book_date >= '2025-11-01 12:00:00+03'
AND b . book_date < '2025-11-01 13:00:00+03' ;
QUERY PLAN
------------------------------------------------------------
Nested Loop ( cost = 0 . 99 .. 13246 . 54 rows = 1229 width = 52 ) (...
Buffers : shared hit = 2866 read = 6
-> Index Only Scan using bookings_book_date_book_ref_ ...
Index Cond : (( book_date >= '2025-11-01 12:00:00+0...
Heap Fetches: 0
Index Searches: 1
Buffers: shared hit=1 read=6
-> Index Scan using tickets_book_ref_passenger_id_out...
Index Cond: (book_ref = b.book_ref)
Index Searches: 567
Buffers: shared hit=2865
Planning:
Buffers: shared hit=42 read=1
Planning Time: 0.171 ms
Execution Time: 2.089 ms
(15 rows) 这又节省了约 15% 的读取。PostgreSQL 现在可以在 bookings 上使用仅索引扫描。这部分额外索引载荷是否值得其维护和存储成本,取决于这种访问模式出现的频率。对一条很少执行的查询而言,微优化如果只节省几次缓冲区访问,可能得不偿失。
长查询 长查询 是指面向吞吐量的查询,它必须处理大量数据才能得到答案。长查询聚合后可以只返回一行,同时仍然读取数百万行。
此类查询通常具有低选择率 谓词:大部分输入都能通过。因此全表扫描和哈希连接更有吸引力,总吞吐量比立即返回第一行更重要。
再次强调,这是趋势,不是规则。长计划可能包含针对某个维度、筛选作用很强的索引查找,也可能对真正很小的输入执行嵌套循环。最需要警惕的是重复工作。相关子查询、隐藏的函数调用或糟糕的嵌套循环计划,都可能导致同一大数据集被读取多次。
长查询处理大量数据,通常还会对其进行聚合——用户很少需要数百万行——因此可以从并行执行中获益。
考虑下面的查询:统计起飞和到达都延误了一分钟至四小时的航班上的乘客数量。
\ timing on
SELECT count ( * )
FROM flights f
JOIN segments tf ON tf . flight_id = f . flight_id
JOIN boarding_passes bp ON bp . flight_id = tf . flight_id
AND bp . ticket_no = tf . ticket_no
WHERE f . actual_departure - f . scheduled_departure
BETWEEN interval '1 min' AND interval '4 hours'
AND f . actual_arrival - f . scheduled_arrival
BETWEEN interval '1 min' AND interval '4 hours' ;
count
---------
5871849
(1 row)
Time: 26956.143 ms (00:26.956)
\timing off 查询返回了正确结果,但执行时间令人不满意。
先确定问题的形态。flights 表中的总行数:
SELECT count ( * )
FROM flights f ;
count
-------
37671
( 1 row ) 这些谓词保留了相当多的行:
SELECT count ( * ) FROM flights f
WHERE f . actual_departure - f . scheduled_departure
BETWEEN interval '1 min' AND interval '4 hours'
AND f . actual_arrival - f . scheduled_arrival
BETWEEN interval '1 min' AND interval '4 hours' ;
count
-------
26364
( 1 row ) 约 70% 的 flights 符合条件。其他参与连接的表都很大,也没有筛选作用较强的限制条件。
显然,这是一个长查询。但计划看起来像一次筛选作用较强的 OLTP 查找:
QUERY PLAN
------------------------------------------------------------
Aggregate (cost=1713.52..1713.53 rows=1 width=8)
-> Nested Loop
(cost=0.86..1713.12 rows=159 width=0)
-> Nested Loop
(cost=0.43..1626.77 rows=195 width=22)
-> Seq Scan on flights f
(cost=0.00..1498.13 rows=1 width=4)
Filter: (((actual_departure -scheduled_d...
-> Index Scan using segments_flight_id_idx on...
(cost=0.43..125.95 rows=269 width=18)
Index Cond: (flight_id = f.flight_id)
-> Index Only Scan using boarding_passes_pkey on ...
(cost=0.43..1.99 rows=150 width=36)
Index Cond: ((ticket_no = tf.ticket_no) AND (...
(14 rows) 核心错误一眼可见:规划器估计只有 一 个符合条件的航班,而实际超过 26,000 个。按照这个估计,嵌套循环和索引探测看起来完全合理。
作为诊断实验,降低嵌套循环的优先级:
SET enable_nestloop = off ;
SET 现在再次运行 EXPLAIN:
EXPLAIN ( analyze , timing off , costs off )
SELECT count ( * )
FROM flights f
JOIN segments tf ON tf . flight_id = f . flight_id
JOIN boarding_passes bp ON bp . flight_id = tf . flight_id
AND bp . ticket_no = tf . ticket_no
WHERE f . actual_departure - f . scheduled_departure
BETWEEN interval '1 min' AND interval '4 hours'
AND f . actual_arrival - f . scheduled_arrival
BETWEEN interval '1 min' AND interval '4 hours' ;
QUERY PLAN
------------------------------------------------------------
Aggregate (actual rows=1.00 loops=1)
Buffers: shared hit=11393 read=100031, temp read=8496...
-> Hash Join (actual rows=5871849.00 loops=1)
Hash Cond: ((bp.flight_id = tf.flight_id) AND (bp...
Buffers: shared hit=11393 read=100031, temp read=...
-> Seq Scan on boarding_passes bp (actual rows=59...
Buffers: shared hit=2632 read=47168
-> Hash (actual rows=5871849.00 loops=1)
Buckets: 262144 (originally 1024) Batches: 6...
Buffers: shared hit=8761 read=52863, temp wri...
-> Hash Join (actual rows=5871849.00 loops=1)
Hash Cond: (tf.flight_id = f.flight_id)
Buffers: shared hit=8761 read=52863
-> Seq Scan on segments tf (actual rows=7...
Buffers: shared hit=8393 read=52863
-> Hash (actual rows=26364.00 loops=1)
Buckets: 32768 (originally 1024) Bat...
Buffers: shared hit=368
-> Seq Scan on flights f (actual rows...
Filter: (((actual_departure -sch...
Rows Removed by Filter: 11307
Buffers: shared hit=368
Planning:
Buffers: shared hit=14
Planning Time: 0.117 ms
Execution Time: 2756.711 ms
(26 rows)
RESET enable_nestloop; 表访问自动切换为顺序扫描,速度也更快了。如果用 buffers 选项检查计划,会看到查询必须读取大约 110,000 个页面。我们没有查看第一个版本带 buffers 选项的执行计划,但它读取的数据量几乎是这个版本的 200 倍——你可以自己检查!
巨大的改进证实了诊断结果,但为什么选择率估计会糟糕到这种程度?两个谓词都对时间戳列应用算术表达式,而规划器第六章“统计信息”
CREATE STATISTICS
ON ( actual_departure - scheduled_departure ) FROM flights ;
CREATE STATISTICS
ON ( actual_arrival - scheduled_arrival ) FROM flights ;
ANALYZE flights ;
EXPLAIN SELECT count ( * )
FROM flights f
JOIN segments tf ON tf . flight_id = f . flight_id
JOIN boarding_passes bp ON bp . flight_id = tf . flight_id
AND bp . ticket_no = tf . ticket_no
WHERE f . actual_departure - f . scheduled_departure
BETWEEN interval '1 min' AND interval '4 hours'
AND f . actual_arrival - f . scheduled_arrival
BETWEEN interval '1 min' AND interval '4 hours' ;
QUERY PLAN
------------------------------------------------------------
Aggregate ( cost = 517827 . 35 .. 517827 . 36 rows = 1 width = 8 )
-> Hash Join
( cost = 247829 . 93 .. 510415 . 83 rows = 2964608 width = 0 )
Hash Cond : (( tf . flight_id = bp . flight_id ) AND ( tf ...
-> Hash Join
( cost = 1731 . 48 .. 155776 . 61 rows = 3642052 width = 22 )
Hash Cond : ( tf . flight_id = f . flight_id )
-> Seq Scan on segments tf
( cost = 0 . 00 .. 134750 . 62 rows = 7349462 width = 18 )
-> Hash
( cost = 1498 . 13 .. 1498 . 13 rows = 18668 width = 4 )
-> Seq Scan on flights f
( cost = 0 . 00 .. 1498 . 13 rows = 18668 width = 4 )
Filter : ((( actual_departure - schedul ...
-> Hash
( cost = 109624 . 18 .. 109624 . 18 rows = 5982418 width ...
-> Seq Scan on boarding_passes bp
( cost = 0 . 00 .. 109624 . 18 rows = 5982418 width = 36 )
( 18 rows ) 规划器现在估计有更多航班符合条件,并在没有强制的情况下选择了哈希连接方案。但统计信息并不是查询优化的终点。再问一个boarding_passes 已经包含 flight_id,而外键关系保证了结果所需的数据完整性。segments 连接在本查询中并不会再过滤任何行,因此可以将 flights 直接连接到 boarding_passes:
EXPLAIN ( analyze , timing off )
SELECT count ( * )
FROM flights f
JOIN boarding_passes bp ON bp . flight_id = f . flight_id
WHERE f . actual_departure - f . scheduled_departure
BETWEEN interval '1 min' AND interval '4 hours'
AND f . actual_arrival - f . scheduled_arrival
BETWEEN interval '1 min' AND interval '4 hours' ;
QUERY PLAN
------------------------------------------------------------
Aggregate ( cost = 134472 . 80 .. 134472 . 81 rows = 1 width = 8 ) (...
Buffers : shared hit = 3094 read = 47074
-> Hash Join ( cost = 1731 . 48 .. 127061 . 28 rows = 2964609 w ...
Hash Cond : ( bp . flight_id = f . flight_id )
Buffers : shared hit = 3094 read = 47074
-> Seq Scan on boarding_passes bp ( cost = 0 . 00 .. 10 ...
Buffers : shared hit = 2726 read = 47074
-> Hash ( cost = 1498 . 13 .. 1498 . 13 rows = 18668 width = ...
Buckets : 32768 Batches : 1 Memory Usage : 1183 kB
Buffers : shared hit = 368
-> Seq Scan on flights f ( cost = 0 . 00 .. 1498 . 13 ...
Filter : ((( actual_departure - scheduled_d ...
Rows Removed by Filter : 11307
Buffers : shared hit = 368
Planning Time : 0 . 067 ms
Execution Time : 465 . 082 ms
( 16 rows ) 两个堆关系包含的页面数如下:
SELECT sum ( relpages ) FROM pg_class
WHERE relname IN ( 'flights' , 'boarding_passes' );
sum
-------
50168
( 1 row )
使用 buffers 选项,可以看到这个版本读取的数据量大致符合所涉及关系的预期。第一个版本没有用 buffers 展示,但你可以检查,它读取的数据量几乎是这个版本的 200 倍。
一般来说,重写查询是影响性能最灵活的方式。规划器自己可以执行一些等价变换,但我们还可以,例如:
示例完成后,进行清理:
DROP INDEX bookings_book_date_book_ref_idx ;
DROP INDEX
SELECT 'DROP STATISTICS ' || statistics_name
FROM pg_stats_ext \ gexec
DROP STATISTICS
DROP STATISTICS
规划器建议与提示 PostgreSQL 18 没有能让查询文本直接规定特定连接顺序、扫描方法或连接方法的核心 SQL 提示语法。熟悉的 enable_* 设置可用作粗粒度诊断控制,显式的 JOIN 结构join_collapse_limit 在某些情况下可以约束连接顺序搜索,但这些并不是通用的提示语言。
PostgreSQL 19 包含 pg_plan_advice 模块,它可以描述并约束选定的规划器决策;还包含 pg_stash_advice,可以把这类建议关联到查询标识符,而无需修改应用的 SQL 文本。
第三方扩展长期以来一直提供提示机制;由 Kyotaro Horiguchi 最初开发的 pg_hint_plan 是一个知名例子。
当规划器反复做出已知的错误选择,而且我们了解相应风险时,提示和计划建议是有价值的工具。如果用它们掩盖尚未解释清楚的基数或代价模型问题,就不那么合适了。提示会冻结一个决策;良好的统计信息和模型能保留适应变化的能力。
参考资源 结语 关于 PostgreSQL 内部机制、查询调优和 Postgres Pro Enterprise 功能的结语与延伸阅读。
查询优化是一个需要持续监控和调优的连续过程。今天表现最佳的查询不能指望永远保持最佳状态:表中的数据量可能变化,DBMS 或操作系统可能升级,硬件也可能改变。要维持高性能,就需要持续关注。
本书旨在作为查询优化的入门读物。它介绍 PostgreSQL 规划器的基础知识:访问方法、连接方法、统计信息的使用以及查询优化的主要方法。
本书覆盖的主题为理解规划器的工作方式打下了基础。但不要止步于本书。关注每个 PostgreSQL 版本的变化,持续扩展自己的知识。
在其他资料中,我们建议从官方 PostgreSQL 文档开始。文档由 PostgreSQL 的开发者提供简洁、准确的信息,并且得到认真维护,始终保持更新。
从文档的第一页读到最后一页很困难,而且通常没有必要。逻辑上相关的信息经常分散在不同章节中。这也是我们开设培训课程的原因之一:每门课程
如果想继续学习 PostgreSQL,可以了解我们的其他课程:
DBA1:PostgreSQL 管理——基础课程 ,涵盖服务器架构、安装、基本配置和管理;
DBA2:PostgreSQL 管理——配置与监控 ,包括服务器升级、本地化和扩展管理;
DBA3:PostgreSQL 管理——备份与复制 ,包括集群架构简介;
DBS:PostgreSQL 管理——访问控制 ,包括身份验证以及与外部身份验证系统的集成;
DEV1:PostgreSQL 后端开发——基础课程 ,涵盖使用 SQL 和 PL/pgSQL 进行服务器端编程;
DEV2:PostgreSQL 后端开发——高级课程 ,涵盖在服务器上实现应用逻辑的更高级方法;
PGPRO:Postgres Pro Enterprise 功能 ,涵盖使本公司产品区别于社区 PostgreSQL DBMS 的功能。
参考资源 关于 Postgres Professional 出版方关于 Postgres Professional、其 PostgreSQL 工作、产品、服务、培训和社区活动的介绍。
Postgres Professional 成立于 2015 年,汇集了俄罗斯领先的 PostgreSQL 开发人员,他们对 PostgreSQL 的贡献得到国际社区认可。公司在俄罗斯培养高素质的数据库系统开发人员。如今,公司拥有约 400 名程序员、架构师、工程师和其他专业人员。
Postgres Professional 开发 Postgres Pro 的多个版本。Postgres Pro 是基于 PostgreSQL 的 DBMS;公司还在数据库核心和扩展层面贡献代码,并提供应用系统设计与支持服务,以及迁移到 PostgreSQL 的服务。
公司在教育领域投入大量资源,组织在莫斯科每年举办的规模最大的国际 PostgreSQL 会议 Pg-Conf.Russia,并参与世界各地的 PostgreSQL 会议。
联系方式:
俄罗斯,117630,莫斯科,Obrucheva 街 23 号,1 号楼,33N 室
+7 495 150-06-91
info@postgrespro.com
Postgres Pro DBMS Postgres Professional 的 Postgres Pro 是一款基于开源 PostgreSQL DBMS 的俄罗斯商业 DBMS,按企业级需求开发。它已列入俄罗斯软件登记册。
Postgres Pro Standard 包含 PostgreSQL 的全部功能,并增加了扩展和补丁,其中一些尚未被 PostgreSQL 社区接纳。客户无需等待下一版 PostgreSQL,就能获得有用的功能和性能改进。
Postgres Pro Enterprise 是面向严苛生产工作负载的显著增强版本,这些工作负载要求更高的可靠性和性能。
两个 Postgres Pro 版本都提供了俄罗斯 FSTEC 认证 所需的信息安全功能。
使用任一 Postgres Pro 版本都需要许可证。评估版可以免费获得,用于测试、学习 DBMS 的能力和应用开发。
教育机构可以免费获得 Postgres Pro Standard 学术许可证。
Postgres Pro Enterprise Manager Postgres Pro Enterprise Manager(PPEM)是 Postgres Pro Enterprise 的集成管理控制台。
PPEM 提供单一控制台、直观的监控和管理界面,支持通过 Web 浏览器执行常见管理操作,并集中访问数据库实例和数据库。PPEM 提高数据库运维团队的生产力,简化日常管理工作。
Postgres Pro Backup Enterprise Postgres Pro Backup Enterprise(pg_probackup)是用于管理 PostgreSQL 数据库集群备份和恢复的实用程序。
该实用程序使用集中式备份目录,目录可以存储在本地或远程位置,包括 S3 存储。
它支持页面级增量备份、备份保留策略、数据完整性检查、时间点恢复、并行备份和恢复、压缩以及 CFS 文件系统。
Shardman Shardman 是在 PostgreSQL 基础上引入 Postgres Pro 功能加以增强的分布式关系型 DBMS。
Shardman 兼容 PostgreSQL,提供严格隔离和数据一致性保证,支持水平扩展,并内置高可用性。
服务
Postgres 高可用解决方案 设计并参与开发高负载、高性能、容错的生产系统;提供咨询服务;进行 Postgres 部署和配置调优。
厂商技术支持 为 Postgres Pro 和 PostgreSQL 提供 24×7 技术支持。提供监控、服务恢复、事故分析、性能改进,以及数据库和扩展缺陷修复。
将应用系统迁移到 Postgres 评估从其他 DBMS 迁移到 Postgres 的复杂性。设计目标架构和所需的应用改动。将应用系统迁移到 Postgres,并在迁移过程中提供支持。
Postgres 培训 面向数据库管理员、开发人员和应用架构师,培训 Postgres 功能及其能力的有效使用方法。
数据库审计 对数据库系统进行专家评估。对基于 Postgres 的系统进行信息安全审计。
参考资源 关于 Dharma of Data 原版书籍关于 Dharma of Data 及其数据技术工作的介绍。
把数据做好! Dharma of Data Dharma of Data(DoD)是一家总部位于尼泊尔、专注 PostgreSQL 的公司。
对我们而言,Dharma 意味着为客户、工程师和开源做正确的事。在实践中,这意味着开放标准、优先向上游贡献、透明架构和长期可持续性。
我们使用原生社区 PostgreSQL 构建开放、可靠的数据基础,不使用专有分支,也不造成厂商锁定。我们还通过培训、大学合作和当地 PostgreSQL 社区,推动尼泊尔 PostgreSQL 专业能力的发展。
本英文版是在 Dharma of Data 的支持下编制并印刷的。
dharmaofdata.com
出版信息与致谢 PostgreSQL 18:查询优化的作者、课程作者、封面设计、版权和出版信息,莫斯科,2026 年。
Pavel Tolmachev
PostgreSQL 18:查询优化 课程作者:Pavel Luzanov、Egor Rogov、Pavel Tolmachev、Ilya Bashtanov
封面设计:Maria Lukashenko
postgrespro.com/community/books/qptbook
© Postgres Professional,2026
莫斯科,2026 年
版权与使用 英文正文、原始插图、封面、原始 PDF 和出版信息重现自 Postgres
Professional 于 2026 年出版的原书,仍受原权利人的版权和使用条款约束;
本站没有把这些材料重新授权为通用的开放内容许可。
简体中文网页版本署名为冯若航 / Vonng。欢迎在线阅读并分享本站链接;
如需大段引用、整章转载、再分发、商业使用,或复用译文与图表,请先联系
相关权利人。