# 调优方法
> 完成查询调优:度量工作负载,改进数据访问和估计,减少不必要的工作,并考察替代的查询形式。
---
LLMS 索引: [llms.txt](/llms.txt)
---
## 1. 应该调优什么? {#qpt-section-9-1}
性能是整个信息系统的属性,而不仅是一条 SQL 语句的属性。
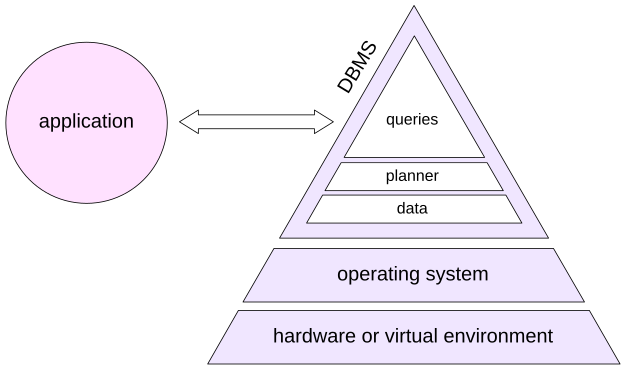
{#qpt-fig-9-1 num="9.1" caption="系统性能的层次" .book-original-figure .d-flex .flex-column .align-items-center width=418 height=247}
本书不打算详细介绍下面两个重要的底层:硬件和操作系统。PostgreSQL 最终要通过操作系统和文件系统访问存储,而延迟、带宽、持久性特征、缓存层次、虚拟化层和存储拓扑都会影响数据库行为。如果底层资源不足或配置不当,SQL 调优无法无限期地弥补这些问题。
在 PostgreSQL 服务器层面,目标是合理分配资源,保持维护工作健康运行,并让规划器获得符合机器和数据实际情况的模型。在应用层面,连接管理、请求形态、模式设计和往返次数,可能与某一条执行计划同样重要。
最后,还可以对单条查询进行性能剖析和调优。开发人员通常从当前正在编写的查询开始;管理员通常从消耗系统资源份额最大的查询开始。
[第七章“性能剖析”](/07-profiling/#qpt-chapter-7)说明了这两类查询并不总是相同。
## 2. 服务器调优 {#qpt-section-9-2}
### CPU 和 I/O 资源 {#qpt-p169-cpu-and-i-o-resources}
并行查询使 PostgreSQL 能够为计划中符合条件的部分使用多个 CPU 核心。主要的工作进程上限为:
- `max_parallel_workers_per_gather` = 2
- `max_parallel_workers` = 8
- `max_worker_processes` = 8
这些是上限,不是承诺。计划可能请求在执行时不可用的工作进程,更多工作进程也不一定更好。每个并行工作进程都是一个真正的 PostgreSQL 进程,会消耗 CPU、内存和 I/O 带宽。应用开发中使用后台进程的内容见 DEV2 课程的“后台进程”一课。
两个 I/O 设置至关重要:可以并发运行的操作数量(普通工作使用 `effective_io_concurrency`,维护工作使用 `maintenance_io_concurrency`),以及一次操作能够读取的连续页数(`io_combine_limit`)。
通过 `io_method` 可以使用多种异步 I/O 实现,还有若干更细的设置。调优这些设置时,要考虑服务器 I/O 子系统的能力和工作负载概况。
### 内存 {#qpt-p170-memory}
`work_mem` 决定单个操作可用的内存量。对应章节中已经讨论过它。它还会影响计划选择:取值较小时,规划器可能更倾向于排序而非哈希,因为排序算法对内存不足不那么敏感。对于使用哈希的操作,可以用 `hash_mem_multiplier` 提高内存上限。
`maintenance_work_mem` 会影响索引创建速度和维护进程的工作。
`shared_buffers` 参数决定缓冲区缓存的大小。
在任何 OLTP 数据库中,无论规模多大,通常都有一组相当紧凑的活跃数据。如果 `shared_buffers` 设置得太小,这些数据就无法放入缓冲区缓存,页面会不断被驱逐,从而给 I/O 带来压力(虽然操作系统页缓存可以在一定程度上缓解这一点)。但把缓冲区缓存做得太大也不是好主意,因为维护它的开销也会相应增加。
因此,最佳缓冲区缓存大小取决于许多因素:不存在一个适用于所有系统、可以用来选择 `shared_buffers` 值的通用公式。DBA2 课程会介绍这个参数的调优,但有一点可以确定:默认值小得远远不够。
`effective_cache_size` 告诉 PostgreSQL 可以缓存的数据总量,包括缓冲区缓存和操作系统缓存中的数据。这个值越大,索引访问对规划器就越有吸引力。该参数不会分配内存。
### 物理放置 {#qpt-p171-physical-placement}
即使 SQL 模式保持不变,物理组织也会影响性能。
**表空间**可以把选定的关系或索引放到不同的存储设备上。例如,可以把频繁使用的数据存储在 SSD 上,把归档数据存储在速度较慢的 HDD 上。如果确实有用,表空间专用的规划器参数(如 `random_page_cost` 和 `effective_io_concurrency`)可以描述不同的设备。
**分区**使处理超大规模数据成为可能。主要的性能收益来自用扫描单个分区替代扫描整张表。分区也可以放在不同的表空间中。
**分片**是另一种选择:可以把分区分布到不同服务器上,并能够运行分布式查询。标准 PostgreSQL 只包含设置分片所需的基本机制:分区和 `postgres_fdw` 扩展。借助第三方解决方案,可以更高效、更完整地实现分片。DBA3 课程的最后一课会概览这个主题。
### 规划器统计信息 {#qpt-p172-planner-statistics}
规划器依赖统计信息进行估计,正如 [第六章“统计信息”](/06-statistics/#qpt-chapter-6)所述。这意味着需要足够频繁地收集统计信息——可以通过调优 autovacuum 和 auto-analyze 控制这一频率。DBA2 课程会深入介绍其中的细节。
统计信息也需要足够准确。绝对准确无法实现(也没有必要),但误差不应大到产生错误的计划。统计信息过时或不准确的迹象之一,是叶计划节点中的预期行数与实际行数严重不匹配。
为了提高准确性,可能需要更改统计目标,可以是全局更改,也可以针对单个表列。有时表达式索引会很有用,因为它拥有自己的统计信息。在某些情况下,还可以使用扩展统计信息。
### 规划器代价模型 {#qpt-p172-planner-cost-model}
规划器代价参数描述机器和工作负载的相对关系。它们不是用来预测以毫秒计的运行时间的。
`seq_page_cost` 为 1,通常应保持不变。`random_page_cost` 的默认值相对较高(4),体现了典型 HDD 的特征。对于 SSD,以及数据很可能已经被缓存的情况,这个值应大幅降低,例如设为 1.1。
CPU 代价参数定义了处理已读取数据时所用的代价权重。它们通常保持不变,因为很难预测修改它们的影响。不过,正如我们在 [第八章“物化与函数”](/08-materialization-and-functions/#qpt-chapter-8)中看到的,有时可以用 `cpu_operator_cost` 单位指定用户自定义函数的代价。
当具有代表性的查询显示出系统性的建模误差,特别是在基数估计已经良好的情况下,可以更改代价参数。例如:
```sql
EXPLAIN (analyze, timing off, buffers off)
SELECT * FROM bookings
WHERE book_ref < 'E00000';
QUERY PLAN
----------------------------------------------
Seq Scan on bookings
(cost=0.00..46939.88 rows=994271 width=21)
(actual rows=967421.00 loops=1)
Filter: (book_ref < 'E00000'::bpchar)
Rows Removed by Filter: 1519289
Planning Time: 0.093 ms
Execution Time: 101.680 ms
(7 rows)
```
行数估计很准确。规划器拥有足够的统计信息,并选择了顺序扫描。
为了诊断,临时降低顺序扫描的优先级。`enable_*` 参数被有意设计为粗粒度控制:它们并不保证在所有情况下都能排除包含某种节点类型的全部计划,而是强烈抑制对这种方式的选择。
```sql
SET enable_seqscan = off; -- until the end of the session
```
它们最适合用于实验:“PostgreSQL 认为下一个最佳计划是什么?它实际表现如何?”
现在,同一查询使用位图访问:
```sql
EXPLAIN (analyze, timing off, buffers off)
SELECT * FROM bookings
WHERE book_ref < 'E00000';
QUERY PLAN
--------------------------------------------------
Bitmap Heap Scan on bookings
(cost=18618.03..46902.42 rows=994271 width=21)
(actual rows=967421.00 loops=1)
Recheck Cond: (book_ref < 'E00000'::bpchar)
Heap Blocks: exact=15839
-> Bitmap Index Scan on bookings_pkey
(cost=0.00..18369.46 rows=994271 width=0)
(actual rows=967422.00 loops=1)
Index Cond: (book_ref < 'E00000'::bpchar)
Index Searches: 1
Planning Time: 0.044 ms
Execution Time: 88.419 ms
(12 rows)
RESET enable_seqscan;
```
结果很可能会偏向索引扫描,因为所有数据都已缓存,随机访问很快。使用快速 SSD 时也可能出现同样情况。
仅根据一条查询得出结论是不对的,但如果这种误差反复出现,就有理由调查全局设置。在这种情况下,可以尝试降低 `random_page_cost`,使规划器不再高估索引访问的代价;也可以提高 `effective_cache_size`,使索引扫描更具吸引力。
## 3. 应用调优 {#qpt-section-9-3}
### 客户端与连接 {#qpt-p175-clients-and-connections}
打开数据库连接并非没有成本,PostgreSQL 后端进程会产生可观的内存和调度成本。大量创建短生命周期连接的应用通常会受益于连接池。不过,连接池会对应用施加某些限制。DEV2 课程会介绍这个主题。
游标适用于应用确实只需要结果的开头一部分,或者逐步消费结果的场景。`cursor_tuple_fraction` 告诉规划器预计会获取游标行的大致比例,这可能改变启动代价与总代价之间的权衡。
另一个常见性能问题不是一条缓慢的 SQL 语句,而是数千条各自执行很快的语句。ORM 可能产生这种模式,例如通过 N **+** 1 查询行为。回到 [第七章“性能剖析”](/07-profiling/#qpt-chapter-7),我们看到过函数在循环中调用的类似例子。
在这种情况下,数据库服务器几乎没有优化手段(预备语句可以降低重复查询的开销,这算是例外)。
在这种情况下,有效做法是去掉应用中的过程式代码,把工作移到数据库服务器,由少量更大的 SQL 命令完成。这样规划器有机会使用更高效的访问和连接方法,也能避免客户端与服务器之间大量传输数据。遗憾的是,这种改动可能代价很高。
### 数据模型 {#qpt-p176-data-model}
在**逻辑层面**,数据库应当**规范化**:非正式地说,存储的数据不应冗余。否则就是设计错误,因为检查数据一致性会变得困难,还可能出现各种更新异常。
在**存储层面**,有时可以为了性能而有意引入冗余,前提是系统有明确的机制保持冗余数据一致。
索引是最常见的例子:它们把表中的信息复制到另一种物理结构中,而 PostgreSQL 会自动维护这些索引。
其他形式包括生成列、由触发器维护的值以及物化视图。应用层也可以通过缓存查询结果来复制数据。这是一种常用技术,但应用经常因为与数据库配合不佳而使用它,例如通过 ORM。于是应用就要负责及时更新缓存、控制缓存数据的访问权限,以及处理相关的一致性问题。
选择正确的**数据类型**也是查询优化的一部分。例如,用 `daterange` 或 `tstzrange` 等 PostgreSQL 范围类型表示区间,可以直接表达区间语义,并为重叠等操作提供 GiST 或 SP-GiST 索引。
数组和 JSON 有时可以避免连接并减少元组头开销,但它们也会改变约束、统计信息、更新粒度、索引和查询语义。使用复杂类型应当是因为它们符合数据模型,而不只是为了避免一次连接。
**完整性约束**首先关乎正确性。它们还可以为规划器提供有用的保证:
- 主键和唯一约束会带有唯一索引,并保证所有键列值都不重复(统计信息准确)。这些保证也能让连接更高效。
- 在某些情况下,外键与 `NOT NULL` 约束结合可以消除不必要的连接,这对视图尤其重要;当连接跨越多个列时,还能改进选择率估计。
- `CHECK` 约束与 `constraint_exclusion` 参数结合,可以在确定表(或分区)不可能包含所需数据时,避免扫描它们。
下面是一个在复合键上连接时得到准确基数估计的例子:
```sql
EXPLAIN SELECT * FROM segments s
JOIN boarding_passes bp ON s.flight_id = bp.flight_id
AND s.ticket_no = bp.ticket_no;
QUERY PLAN
------------------------------------------------------------
Hash Join (cost=275309.45..625075.75 rows=5982418 widt...
Hash Cond: ((s.flight_id = bp.flight_id) AND (s.ticke...
-> Seq Scan on segments s
(cost=0.00..134750.62 rows=7349462 width=31)
-> Hash (cost=109624.18..109624.18 rows=5982418 widt...
-> Seq Scan on boarding_passes bp
(cost=0.00..109624.18 rows=5982418 width=80)
(7 rows)
```
不过,如果删除外键,估计就会变得不准确。这是相关谓词问题的另一种表现:
```sql
BEGIN;
ALTER TABLE boarding_passes
DROP CONSTRAINT boarding_passes_ticket_no_flight_id_fkey;
EXPLAIN SELECT * FROM segments s
JOIN boarding_passes bp ON s.flight_id = bp.flight_id
AND s.ticket_no = bp.ticket_no;
QUERY PLAN
------------------------------------------------------------
Hash Join (cost=275309.45..625075.75 rows=504 width=111)
Hash Cond: ((s.flight_id = bp.flight_id) AND (s.ticke...
-> Seq Scan on segments s
(cost=0.00..134750.62 rows=7349462 width=31)
-> Hash (cost=109624.18..109624.18 rows=5982418 widt...
-> Seq Scan on boarding_passes bp
(cost=0.00..109624.18 rows=5982418 width=80)
(7 rows)
ROLLBACK;
```
## 4. 查询 {#qpt-section-9-4}
### 通往优化的路径 {#qpt-p178-paths-to-optimization}
查询调优的直接目标是获得足够好的执行计划,但有多种途径可以做到。
一种方法是战术性的:检查糟糕的计划,找出错误选择,然后强制或引导采用替代方案。遗憾的是,罪魁祸首并不总是显而易见,调优往往会变成与规划器较劲。如果走这条路,你会希望能够完全或部分禁用规划器,自己构建执行计划。这项功能称为提示(hint),而 PostgreSQL 没有显式提供它。
另一种方法是解释性的:找出规划器为何认为糟糕的计划代价很低。修正基数估计、统计信息、表达式和代价假设,让规划器自己得到更好的计划。
第二种方法更稳健,因为当数据和条件变化时,它保留了规划器的自由度,但这种方法并不总是容易。有时生产事故首先需要一个战术性的临时解决方案。
两种方法都有用。区别在于你是在修正规划器掌握的信息,还是在约束它的选择。
### 短查询 {#qpt-p179-short-queries}
这里的“短”和“长”是非正式分类,不是 PostgreSQL 的正式概念。
**短查询**常见于对延迟敏感的 OLTP 工作中:它读取少量数据,通常返回几行。它也可能访问超大表,但其谓词通常具有**高选择率**:只有很小一部分输入行符合条件。
短查询通常服务于用户界面,因此尽快执行非常重要。响应时间优先。
典型的高效构件包括:扫描很小的关系;对大型关系进行索引查找;使用低代价参数化内部探测的嵌套循环。
连接通常使用嵌套循环执行。与哈希连接不同,嵌套循环不需要准备工作;当连接的行数很少时,它的效果很好。考虑一个返回某个特定小时内预订的航段列表的查询。对于这个短查询示例,我们禁用并行执行。
考虑一个返回在一小时时间区间内起飞航班的登机牌的查询(由于并行执行对这个短查询没有用处,因此禁用它):
```sql
SET max_parallel_workers_per_gather = 0;
EXPLAIN (analyze, timing off)
SELECT t.*
FROM bookings b
JOIN tickets t ON t.book_ref = b.book_ref
WHERE date_trunc('hour', b.book_date) =
'2025-11-01 12:00:00+03';
QUERY PLAN
------------------------------------------------------------
Hash Join (cost=53312.08..181808.82 rows=27993 width=52)
(actual rows=1338.00 loops=1)
Hash Cond: (t.book_ref = b.book_ref)
Buffers: shared hit=12738 read=60934
-> Seq Scan on tickets t
(cost=0.00..113800.73 rows=5598473 width=52)
(actual rows=5598473.00 loops=1)
Buffers: shared read=57816
-> Hash (cost=53156.65..53156.65 rows=12434 width=7)
(actual rows=567.00 loops=1)
Buckets: 16384 Batches: 1 Memory Usage: 150kB
Buffers: shared hit=12738 read=3118
-> Seq Scan on bookings b
(cost=0.00..53156.65 rows=12434 width=7)
(actual rows=567.00 loops=1)
Filter: (date_trunc('hour'::text, book_date) ...
Rows Removed by Filter: 2486143
Buffers: shared hit=12738 read=3118
Planning:
Buffers: shared hit=172 read=18
Planning Time: 0.704 ms
Execution Time: 380.957 ms
(22 rows)
```
这是一个短查询:它只需要两个大表中远少于百分之一的数据。然而两个表都被完整扫描,估计基数与实际值相差很大。
从 `bookings` 上最内层的 `Seq Scan` 开始。问题在于 `date_trunc`:它没有规划器支持函数,因此 PostgreSQL 使用固定的 0.5% 选择率估计。
```sql
EXPLAIN (analyze, timing off, buffers off, summary off)
SELECT * FROM bookings b
WHERE b.book_date >= '2025-11-01 12:00:00+03'
AND b.book_date < '2025-11-01 13:00:00+03';
QUERY PLAN
------------------------------------------------------------
Seq Scan on bookings b
(cost=0.00..53156.65 rows=546 width=21)
(actual rows=567.00 loops=1)
Filter: ((book_date >= '2025-11-01 12:00:00+03'::time...
Rows Removed by Filter: 2486143
(5 rows)
```
现在估计接近实际,但 PostgreSQL 仍没有可以避免扫描该表的访问路径。创建一个:
```sql
CREATE INDEX ON bookings(book_date);
EXPLAIN (analyze, timing off)
SELECT t.* FROM bookings b
JOIN tickets t ON t.book_ref = b.book_ref
WHERE b.book_date >= '2025-11-01 12:00:00+03'
AND b.book_date < '2025-11-01 13:00:00+03';
QUERY PLAN
------------------------------------------------------------
Nested Loop (cost=0.99..13265.14 rows=1229 width=52) (...
Buffers: shared hit=2630 read=782
-> Index Scan using bookings_book_date_idx on booking...
Index Cond: ((book_date >= '2025-11-01 12:00:00+0...
Index Searches: 1
Buffers: shared hit=542 read=5
-> Index Scan using tickets_book_ref_passenger_id_out...
Index Cond: (book_ref = b.book_ref)
Index Searches: 567
Buffers: shared hit=2088 read=777
Planning:
Buffers: shared hit=46 read=1
Planning Time: 0.153 ms
Execution Time: 128.876 ms
(14 rows)
```
这正是我们想要的:规划器选择了索引扫描,并使用嵌套循环连接数据。
一种可能的改进是完全不访问 `bookings` 表,只扫描索引。将连接键包含在索引中,就能使其成为覆盖索引,满足第一次查找的需要:
```sql
DROP INDEX bookings_book_date_idx;
CREATE INDEX ON bookings(book_date) INCLUDE (book_ref);
EXPLAIN (analyze, timing off)
SELECT t.*
FROM bookings b
JOIN tickets t ON t.book_ref = b.book_ref
WHERE b.book_date >= '2025-11-01 12:00:00+03'
AND b.book_date < '2025-11-01 13:00:00+03';
QUERY PLAN
------------------------------------------------------------
Nested Loop (cost=0.99..13246.54 rows=1229 width=52) (...
Buffers: shared hit=2866 read=6
-> Index Only Scan using bookings_book_date_book_ref_...
Index Cond: ((book_date >= '2025-11-01 12:00:00+0...
Heap Fetches: 0
Index Searches: 1
Buffers: shared hit=1 read=6
-> Index Scan using tickets_book_ref_passenger_id_out...
Index Cond: (book_ref = b.book_ref)
Index Searches: 567
Buffers: shared hit=2865
Planning:
Buffers: shared hit=42 read=1
Planning Time: 0.171 ms
Execution Time: 2.089 ms
(15 rows)
```
这又节省了约 15% 的读取。PostgreSQL 现在可以在 `bookings` 上使用仅索引扫描。这部分额外索引载荷是否值得其维护和存储成本,取决于这种访问模式出现的频率。对一条很少执行的查询而言,微优化如果只节省几次缓冲区访问,可能得不偿失。
### 长查询 {#qpt-p183-long-queries}
**长查询**是指面向吞吐量的查询,它必须处理大量数据才能得到答案。长查询聚合后可以只返回一行,同时仍然读取数百万行。
此类查询通常具有**低选择率**谓词:大部分输入都能通过。因此全表扫描和哈希连接更有吸引力,总吞吐量比立即返回第一行更重要。
再次强调,这是趋势,不是规则。长计划可能包含针对某个维度、筛选作用很强的索引查找,也可能对真正很小的输入执行嵌套循环。最需要警惕的是重复工作。相关子查询、隐藏的函数调用或糟糕的嵌套循环计划,都可能导致同一大数据集被读取多次。
长查询处理大量数据,通常还会对其进行聚合——用户很少需要数百万行——因此可以从并行执行中获益。
考虑下面的查询:统计起飞和到达都延误了一分钟至四小时的航班上的乘客数量。
```sql
\timing on
SELECT count(*)
FROM flights f
JOIN segments tf ON tf.flight_id = f.flight_id
JOIN boarding_passes bp ON bp.flight_id = tf.flight_id
AND bp.ticket_no = tf.ticket_no
WHERE f.actual_departure - f.scheduled_departure
BETWEEN interval '1 min' AND interval '4 hours'
AND f.actual_arrival - f.scheduled_arrival
BETWEEN interval '1 min' AND interval '4 hours';
```
```text
count
---------
5871849
(1 row)
Time: 26956.143 ms (00:26.956)
\timing off
```
查询返回了正确结果,但执行时间令人不满意。
先确定问题的形态。`flights` 表中的总行数:
```sql
SELECT count(*)
FROM flights f;
count
-------
37671
(1 row)
```
这些谓词保留了相当多的行:
```sql
SELECT count(*) FROM flights f
WHERE f.actual_departure - f.scheduled_departure
BETWEEN interval '1 min' AND interval '4 hours'
AND f.actual_arrival - f.scheduled_arrival
BETWEEN interval '1 min' AND interval '4 hours';
count
-------
26364
(1 row)
```
约 70% 的 `flights` 符合条件。其他参与连接的表都很大,也没有筛选作用较强的限制条件。
显然,这是一个长查询。但计划看起来像一次筛选作用较强的 OLTP 查找:
```text
QUERY PLAN
------------------------------------------------------------
Aggregate (cost=1713.52..1713.53 rows=1 width=8)
-> Nested Loop
(cost=0.86..1713.12 rows=159 width=0)
-> Nested Loop
(cost=0.43..1626.77 rows=195 width=22)
-> Seq Scan on flights f
(cost=0.00..1498.13 rows=1 width=4)
Filter: (((actual_departure -scheduled_d...
-> Index Scan using segments_flight_id_idx on...
(cost=0.43..125.95 rows=269 width=18)
Index Cond: (flight_id = f.flight_id)
-> Index Only Scan using boarding_passes_pkey on ...
(cost=0.43..1.99 rows=150 width=36)
Index Cond: ((ticket_no = tf.ticket_no) AND (...
(14 rows)
```
核心错误一眼可见:规划器估计只有 **一** 个符合条件的航班,而实际超过 26,000 个。按照这个估计,嵌套循环和索引探测看起来完全合理。
作为诊断实验,降低嵌套循环的优先级:
```sql
SET enable_nestloop = off;
SET
```
现在再次运行 `EXPLAIN`:
```sql
EXPLAIN (analyze, timing off, costs off)
SELECT count(*)
FROM flights f
JOIN segments tf ON tf.flight_id = f.flight_id
JOIN boarding_passes bp ON bp.flight_id = tf.flight_id
AND bp.ticket_no = tf.ticket_no
WHERE f.actual_departure - f.scheduled_departure
BETWEEN interval '1 min' AND interval '4 hours'
AND f.actual_arrival - f.scheduled_arrival
BETWEEN interval '1 min' AND interval '4 hours';
```
```text
QUERY PLAN
------------------------------------------------------------
Aggregate (actual rows=1.00 loops=1)
Buffers: shared hit=11393 read=100031, temp read=8496...
-> Hash Join (actual rows=5871849.00 loops=1)
Hash Cond: ((bp.flight_id = tf.flight_id) AND (bp...
Buffers: shared hit=11393 read=100031, temp read=...
-> Seq Scan on boarding_passes bp (actual rows=59...
Buffers: shared hit=2632 read=47168
-> Hash (actual rows=5871849.00 loops=1)
Buckets: 262144 (originally 1024) Batches: 6...
Buffers: shared hit=8761 read=52863, temp wri...
-> Hash Join (actual rows=5871849.00 loops=1)
Hash Cond: (tf.flight_id = f.flight_id)
Buffers: shared hit=8761 read=52863
-> Seq Scan on segments tf (actual rows=7...
Buffers: shared hit=8393 read=52863
-> Hash (actual rows=26364.00 loops=1)
Buckets: 32768 (originally 1024) Bat...
Buffers: shared hit=368
-> Seq Scan on flights f (actual rows...
Filter: (((actual_departure -sch...
Rows Removed by Filter: 11307
Buffers: shared hit=368
Planning:
Buffers: shared hit=14
Planning Time: 0.117 ms
Execution Time: 2756.711 ms
(26 rows)
RESET enable_nestloop;
```
表访问自动切换为顺序扫描,速度也更快了。如果用 `buffers` 选项检查计划,会看到查询必须读取大约 110,000 个页面。我们没有查看第一个版本带 buffers 选项的执行计划,但它读取的数据量几乎是这个版本的 200 倍——你可以自己检查!
巨大的改进证实了诊断结果,但为什么选择率估计会糟糕到这种程度?两个谓词都对时间戳列应用算术表达式,而规划器没有这些表达式的分布统计信息。按照 [第六章“统计信息”](/06-statistics/#qpt-chapter-6)所述,收集表达式统计信息:
```sql
CREATE STATISTICS
ON (actual_departure - scheduled_departure) FROM flights;
CREATE STATISTICS
ON (actual_arrival - scheduled_arrival) FROM flights;
ANALYZE flights;
EXPLAIN SELECT count(*)
FROM flights f
JOIN segments tf ON tf.flight_id = f.flight_id
JOIN boarding_passes bp ON bp.flight_id = tf.flight_id
AND bp.ticket_no = tf.ticket_no
WHERE f.actual_departure - f.scheduled_departure
BETWEEN interval '1 min' AND interval '4 hours'
AND f.actual_arrival - f.scheduled_arrival
BETWEEN interval '1 min' AND interval '4 hours';
QUERY PLAN
------------------------------------------------------------
Aggregate (cost=517827.35..517827.36 rows=1 width=8)
-> Hash Join
(cost=247829.93..510415.83 rows=2964608 width=0)
Hash Cond: ((tf.flight_id = bp.flight_id) AND (tf...
-> Hash Join
(cost=1731.48..155776.61 rows=3642052 width=22)
Hash Cond: (tf.flight_id = f.flight_id)
-> Seq Scan on segments tf
(cost=0.00..134750.62 rows=7349462 width=18)
-> Hash
(cost=1498.13..1498.13 rows=18668 width=4)
-> Seq Scan on flights f
(cost=0.00..1498.13 rows=18668 width=4)
Filter: (((actual_departure -schedul...
-> Hash
(cost=109624.18..109624.18 rows=5982418 width...
-> Seq Scan on boarding_passes bp
(cost=0.00..109624.18 rows=5982418 width=36)
(18 rows)
```
规划器现在估计有更多航班符合条件,并在没有强制的情况下选择了哈希连接方案。但统计信息并不是查询优化的终点。再问一个问题:我们是否读取了超出需要的数据?对于这个模式,`boarding_passes` 已经包含 `flight_id`,而外键关系保证了结果所需的数据完整性。`segments` 连接在本查询中并不会再过滤任何行,因此可以将 `flights` 直接连接到 `boarding_passes`:
```sql
EXPLAIN (analyze, timing off)
SELECT count(*)
FROM flights f
JOIN boarding_passes bp ON bp.flight_id = f.flight_id
WHERE f.actual_departure - f.scheduled_departure
BETWEEN interval '1 min' AND interval '4 hours'
AND f.actual_arrival - f.scheduled_arrival
BETWEEN interval '1 min' AND interval '4 hours';
QUERY PLAN
------------------------------------------------------------
Aggregate (cost=134472.80..134472.81 rows=1 width=8) (...
Buffers: shared hit=3094 read=47074
-> Hash Join (cost=1731.48..127061.28 rows=2964609 w...
Hash Cond: (bp.flight_id = f.flight_id)
Buffers: shared hit=3094 read=47074
-> Seq Scan on boarding_passes bp (cost=0.00..10...
Buffers: shared hit=2726 read=47074
-> Hash (cost=1498.13..1498.13 rows=18668 width=...
Buckets: 32768 Batches: 1 Memory Usage: 1183kB
Buffers: shared hit=368
-> Seq Scan on flights f (cost=0.00..1498.13...
Filter: (((actual_departure -scheduled_d...
Rows Removed by Filter: 11307
Buffers: shared hit=368
Planning Time: 0.067 ms
Execution Time: 465.082 ms
(16 rows)
```
两个堆关系包含的页面数如下:
```sql
SELECT sum(relpages) FROM pg_class
WHERE relname IN ('flights','boarding_passes');
sum
-------
50168
(1 row)
```
使用 `buffers` 选项,可以看到这个版本读取的数据量大致符合所涉及关系的预期。第一个版本没有用 `buffers` 展示,但你可以检查,它读取的数据量几乎是这个版本的 200 倍。
一般来说,重写查询是影响性能最灵活的方式。规划器自己可以执行一些等价变换,但我们还可以,例如:
- 重写条件,使其可以使用索引,或者反过来使其无法使用索引
- 把本质上是嵌套循环的相关子查询替换为连接
- 消除冗余扫描,就像本例中这样,或者使用窗口函数
- 使用规划器无法使用的变换,例如用 `UNION` 替换 `OR` 条件
示例完成后,进行清理:
```sql
DROP INDEX bookings_book_date_book_ref_idx;
DROP INDEX
SELECT 'DROP STATISTICS ' || statistics_name
FROM pg_stats_ext \gexec
DROP STATISTICS
DROP STATISTICS
```
### 规划器建议与提示 {#qpt-p189-planner-advice-and-hints}
PostgreSQL 18 没有能让查询文本直接规定特定连接顺序、扫描方法或连接方法的核心 SQL 提示语法。熟悉的 `enable_*` 设置可用作粗粒度诊断控制,显式的 `JOIN` 结构加上 `join_collapse_limit` 在某些情况下可以约束连接顺序搜索,但这些并不是通用的提示语言。
PostgreSQL 19 包含 `pg_plan_advice` 模块,它可以描述并约束选定的规划器决策;还包含 `pg_stash_advice`,可以把这类建议关联到查询标识符,而无需修改应用的 SQL 文本。
第三方扩展长期以来一直提供提示机制;由 Kyotaro Horiguchi 最初开发的 `pg_hint_plan` 是一个知名例子。
当规划器反复做出已知的错误选择,而且我们了解相应风险时,提示和计划建议是有价值的工具。如果用它们掩盖尚未解释清楚的基数或代价模型问题,就不那么合适了。提示会冻结一个决策;良好的统计信息和模型能保留适应变化的能力。
## 参考资源 {#referenced-resources}
- [postgrespro.ru/docs/postgresql/16/postgres-fdw]()
- [github.com/ossc-db/pg\_hint\_plan]()
- [postgrespro.ru/docs/postgresql/18/runtime-config-query]()
- [www.postgresql.org/docs/18/ddl-partitioning]()
- [www.postgresql.org/docs/18/runtime-config-query]()
- [www.postgresql.org/docs/19/pgplanadvice.html]()