# 物化与函数
> 了解物化、CTE、函数易变性、返回集合的函数、COST 和 ROWS 估计、规划器支持以及函数内联。
---
LLMS 索引: [llms.txt](/llms.txt)
---
## 1. 物化 {#qpt-section-8-1}
**物化**(materialization)是指保存一个中间行集,以便再次使用,通常不止一次。保存的结果可以存在于不同范围内:一条查询内部、一个会话中,或者作为数据库对象存在。
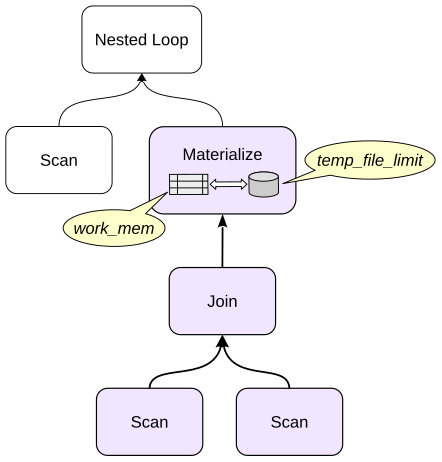
大多数执行器节点以流水线方式工作。父节点向子节点请求下一行,请求沿着计划树向下传播。不过,有些节点需要读取全部输入、将其保存,然后反复读取保存的结果。PostgreSQL 使用 `Materialize` 节点完成这项工作。
物化的行集只要能够放进该操作可用的内存预算,就会保存在后端本地内存中。如果行集增长到超过预算,PostgreSQL 就会使用临时存储。`temp_file_limit` 限制单个 PostgreSQL 进程使用的临时文件空间;这一限制也适用于单个客户端会话内活动的各个并行工作进程。
在下图中,上层 `Nested Loop` 无法高效地参数化访问其内部输入。这个内部输入本身由另一个操作产生。
{#qpt-fig-8-1 num="8.1" caption="物化中间结果" .book-original-figure .d-flex .flex-column .align-items-center width=295 height=308}
如果每个外部行都重新计算一次,代价会很高,因此 PostgreSQL 可以先物化一次,然后重新扫描保存的行。
例如,查找机场对,其中一个机场使用莫斯科时间,另一个机场位于北极圈以北:
```sql
EXPLAIN (costs off)
SELECT a1.city, a2.city
FROM airports a1, airports a2
WHERE a1.timezone = 'Europe/Moscow'
AND abs(a2.coordinates[1]) > 66.652;
QUERY PLAN
------------------------------------------------------------
Nested Loop
-> Seq Scan on airports_data ml_1
Filter: (abs(coordinates[1]) > '66.652'::double p...
-> Materialize
-> Seq Scan on airports_data ml
Filter: (timezone = 'Europe/Moscow'::text)
(6 rows)
```
在这个例子中,内部谓词没有可用的索引。与针对每个外部行再次扫描和过滤内部结果相比,重复使用很小的内部结果代价更低。
### CTE 物化 {#qpt-p144-cte-materialization}
公用表表达式(common table expression,CTE)也称为 `WITH` 子查询,是组织查询并提高可读性的好方法。与普通子查询不同,使用 CTE 不会导致深层嵌套。
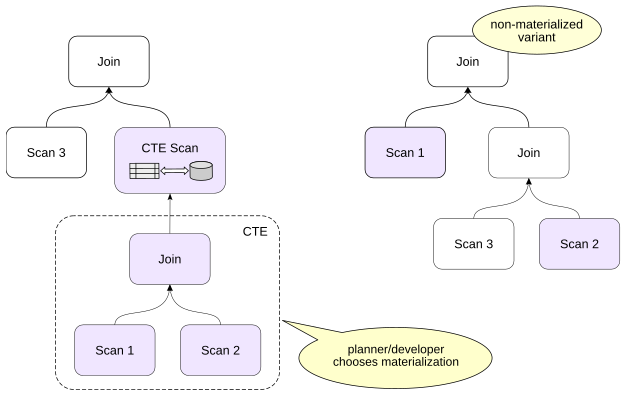
只要可能,规划器就会把 CTE 合并到父查询中,而不是将其物化。这样规划器就可以选择最佳的连接顺序。
默认情况下,CTE 会在以下情况下物化:
- 主查询引用 CTE 超过一次,这样就不必重复计算结果。在这种情况下,可以使用 `AS NOT MATERIALIZED` 禁用物化;
- CTE 具有副作用,包括修改数据或调用易变函数,这样副作用就恰好发生一次。在这种情况下,不能禁用物化。
始终可以使用 `AS MATERIALIZED` 强制物化。
{#qpt-fig-8-2 num="8.2" caption="物化与内联的 CTE 计划" .book-original-figure .d-flex .flex-column .align-items-center width=418 height=264}
考虑一个只使用一次的 CTE:
```sql
EXPLAIN (costs off)
WITH q AS (
SELECT r.route_no, a.airplane_code
FROM routes r
JOIN airplanes a ON a.airplane_code = r.airplane_code
)
SELECT *
FROM q
JOIN seats s ON s.airplane_code = q.airplane_code
WHERE s.seat_no = '1A';
QUERY PLAN
-------------------------------------------------------
Hash Join
Hash Cond: (ml.airplane_code = s.airplane_code)
-> Hash Join
Hash Cond: (r.airplane_code = ml.airplane_code)
-> Seq Scan on routes r
-> Hash
-> Seq Scan on airplanes_data ml
-> Hash
-> Seq Scan on seats s
Filter: (seat_no = '1A'::text)
(10 rows)
```
这里没有 `CTE Scan`:CTE 已经直接合并进主查询。
强制物化:
```sql
EXPLAIN (costs off)
WITH q AS MATERIALIZED (
SELECT r.route_no, a.airplane_code
FROM routes r
JOIN airplanes a ON a.airplane_code = r.airplane_code
)
SELECT *
FROM q
JOIN seats s ON s.airplane_code = q.airplane_code
WHERE s.seat_no = '1A';
QUERY PLAN
---------------------------------------------------------
Hash Join
Hash Cond: (q.airplane_code = s.airplane_code)
CTE q
-> Hash Join
Hash Cond: (r.airplane_code = ml.airplane_code)
-> Seq Scan on routes r
-> Hash
-> Seq Scan on airplanes_data ml
-> CTE Scan on q
-> Hash
-> Seq Scan on seats s
Filter: (seat_no = '1A'::text)
(12 rows)
```
现在,CTE 作为独立单元进行规划,父查询通过 `CTE Scan` 读取它。当计算代价高的结果会被重复使用时,物化通常是不错的选择。但如果父查询只需要大型 CTE 中极小的一部分,物化可能造成灾难性后果。
例如:
```sql
EXPLAIN (analyze, costs off, buffers)
WITH b AS (
SELECT * FROM bookings
)
SELECT *
FROM b AS b1
JOIN b AS b2 ON b1.book_ref = b2.book_ref
WHERE b2.book_ref = '000112';
QUERY PLAN
------------------------------------------------------------
Nested Loop (actual time=228.999..229.000 rows=0.00 loo...
Buffers: shared read=15856, temp written=9746
CTE b
-> Seq Scan on bookings (actual time=0.064..71.089 ...
Buffers: shared read=15856
-> CTE Scan on b b1 (actual time=228.999..228.999 row...
Filter: (book_ref = '000112'::bpchar)
Rows Removed by Filter: 2486710
Storage: Disk Maximum Storage: 77968kB
Buffers: shared read=15856, temp written=9746
-> CTE Scan on b b2 (never executed)
Filter: (book_ref = '000112'::bpchar)
Storage: Disk Maximum Storage: 77968kB
Planning:
Buffers: shared hit=23 read=1
Planning Time: 0.106 ms
Execution Time: 232.733 ms
(17 rows)
```
即使父查询只请求一个键,整张 `bookings` 表也会被物化。现在允许两个引用分别进行优化:
```sql
EXPLAIN (analyze, costs off, buffers)
WITH b AS NOT MATERIALIZED (
SELECT * FROM bookings
)
SELECT *
FROM b AS b1
JOIN b AS b2 ON b1.book_ref = b2.book_ref
WHERE b2.book_ref = '000112';
```
```text
QUERY PLAN
------------------------------------------------------------
Nested Loop (actual time=0.020..0.020 rows=0.00 loops=1)
Buffers: shared read=3
-> Index Scan using bookings_pkey on bookings (actual...
Index Cond: (book_ref = '000112'::bpchar)
Index Searches: 1
Buffers: shared read=3
-> Index Scan using bookings_pkey on bookings booking...
Index Cond: (book_ref = '000112'::bpchar)
Index Searches: 0
Planning:
Buffers: shared hit=5
Planning Time: 0.075 ms
Execution Time: 0.028 ms
(13 rows)
```
现在规划器可以把键限制下推到两次扫描中,并使用主键索引。将这个版本的 `Buffers` 值与前一个版本进行比较。
不过,如果 CTE 修改数据,它无论如何都会物化:修改必须恰好发生一次。
### 临时表 {#qpt-p148-temporary-tables}
如果数据必须被多条查询复用,就不能在一个 CTE 中为所有查询计算它,但可以把数据放进临时表,供这些查询使用。临时表有几个有用的性质:
- 它们属于一个会话;
- `ON COMMIT` 可以在事务结束时保留行、删除行或删除表;
- 它们的数据不会按普通方式写入 WAL。
- 它们的缓冲区是后端本地缓冲区,而不是共享缓冲区的一部分。
临时表并非没有代价。PostgreSQL 仍然会创建系统目录条目和关系文件。
以极高频率创建和删除临时表的工作负载,可能给系统目录和文件系统带来压力。某些应用生态过去曾携带 PostgreSQL 补丁或采用专门设计来降低这项开销;这是应用特定的工程问题,不是一般性避免临时表的理由。
`temp_buffers` 限制一个会话可用于临时关系的本地缓冲区内存量。只有在会话首次访问临时表之前,才能修改它的值。
创建一张包含北半球机场的临时表:
```sql
CREATE TEMP TABLE airports_nh -- Northern Hemisphere
ON COMMIT PRESERVE ROWS -- default
AS SELECT *
FROM airports
WHERE coordinates[1] > 0;
SELECT 4328
```
该表会创建在临时的 `pg_temp` 模式中。
在使用新填充的临时表执行查询之前,对它进行分析通常是有意义的。后端进程的本地内存对 autovacuum 进程不可见,因此必须手动清理和分析临时表。
比较运行分析前后的基数估计:
```sql
EXPLAIN SELECT *
FROM airports_nh;
QUERY PLAN
------------------------------------------
Seq Scan on airports_nh
(cost=0.00..91.52 rows=2752 width=160)
(2 rows)
ANALYZE airports_nh;
EXPLAIN SELECT *
FROM airports_nh;
QUERY PLAN
------------------------------------------
Seq Scan on airports_nh
(cost=0.00..107.28 rows=4328 width=63)
(2 rows)
```
### 物化视图 {#qpt-p150-materialized-views}
物化视图是一个命名的查询结果,作为数据库关系存储。可以像查询普通只读表一样查询它。
可以在物化视图上创建索引,但不能添加完整性约束:约束必须在基表上检查。PostgreSQL 也会为物化视图收集规划器统计信息。
与普通视图不同,基表发生变化时,物化视图中的行不会改变。刷新操作是显式执行的。
完整刷新可能代价很高。当前 PostgreSQL 核心不会随着基表变化逐行增量维护物化视图。Yugo Nagata 的 `pg_ivm` 扩展为受支持的情况实现了增量视图维护。
在 airports 上创建物化视图:
```sql
CREATE MATERIALIZED VIEW airports_mv AS
SELECT * FROM airports;
SELECT 5501
```
创建索引:
```sql
CREATE UNIQUE INDEX ON airports_mv(airport_code);
EXPLAIN (costs off) SELECT *
FROM airports_mv
ORDER BY airport_code
LIMIT 3;
QUERY PLAN
------------------------------------------------------------
Limit
-> Index Scan using airports_mv_airport_code_idx on a...
(2 rows)
```
现在修改一个基表值。2025 年 8 月,马纳斯国际机场把 IATA 代码从 `FRU` 改为 `BSZ`;演示数据库允许我们把它作为一个方便的例子。
```sql
UPDATE airports_data
SET airport_code = 'BSZ'
WHERE airport_code = 'FRU';
UPDATE 1
SELECT count(*)
FROM airports_mv
WHERE airport_code = 'BSZ';
count
-------
0
(1 row)
```
保存的物化视图行不会改变。同步是显式操作;刷新物化视图:
```text
REFRESH MATERIALIZED VIEW CONCURRENTLY airports_mv;
```
```sql
SELECT count(*) FROM airports_mv
WHERE airport_code = 'BSZ';
count
-------
1
(1 row)
```
## 2. 函数 {#qpt-section-8-2}
### 易变性类别 {#qpt-p152-volatility-categories}
每个函数都有一个易变性类别(volatility category)。这个类别是就函数行为向**优化器**作出的一项**承诺**。
`VOLATILE` 是默认值。易变函数在参数相同的连续调用中可能返回不同结果,也可能具有副作用。PostgreSQL 不能假定两次调用可以互相替换。
`STABLE` 承诺,对于相同参数,函数在一条语句的整个执行期间返回相同结果,并且不修改数据库。这样的函数可以在查询执行期间执行一次,然后复用计算出的值。
`IMMUTABLE` 更强:它承诺相同参数的结果永远相同。因此,可以在规划期间折叠常量调用。
这些标签只是允许优化器采用某些处理方式,并不规定精确的执行调度。`STABLE` 并不意味着每个稳定函数都一定严格执行一次;它意味着只要计划允许,优化器就可以把重复的相同参数求值视为等价。
错误的标签可能产生错误结果。如果函数依赖时间、配置、表内容或其他会变化的状态,却把它标记为 `IMMUTABLE`,就可能把过时的值冻结在可复用的计划中。
创建一个 `random()` 的封装函数:
```sql
CREATE FUNCTION rnd() RETURNS float
LANGUAGE sql VOLATILE
RETURN random();
```
使用正确的 `VOLATILE` 标签时,谓词会针对每行求值:
```sql
EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;
QUERY PLAN
------------------------------------------------
Function Scan on generate_series
Filter: (random() > '0.5'::double precision)
(2 rows)
```
一次运行可能返回十行中的任意子集:
```sql
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;
generate_series
-----------------
1
3
4
9
10
(5 rows)
```
现在对 PostgreSQL 撒个谎:
```sql
ALTER FUNCTION rnd() STABLE;
```
```sql
EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;
QUERY PLAN
------------------------------------------------------
Result
One-Time Filter: (rnd() > '0.5'::double precision)
-> Function Scan on generate_series
(3 rows)
```
在这个计划中,稳定表达式变成了一个 `One-Time Filter`,因此结果要么是全部十行,要么是一行也没有:
```sql
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;
generate_series
-----------------
(0 rows)
```
把封装函数标记为 `IMMUTABLE` 会给规划器更多自由:
```sql
ALTER FUNCTION rnd() IMMUTABLE;
EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;
QUERY PLAN
--------------------------
Result
One-Time Filter: false
(2 rows)
EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;
QUERY PLAN
---------------------------------
Function Scan on generate_series
(2 rows)
```
两次独立的规划尝试可能冻结不同的随机结果。令人意外的计划并不是 PostgreSQL 的错误:是我们给了优化器一份虚假的契约。
### 函数内联 {#qpt-p155-function-inlining}
PostgreSQL 可以把符合条件的 SQL 语言函数的函数体内联到外围查询中,对标量函数和返回集合的函数(set-returning function)都可以这样做。两种情况都有许多限制:函数必须使用 SQL 编写,只能使用一条 `SELECT` 语句,并且还要满足其他条件。标量函数不能访问数据库表,也不能调用易变性类别更宽松的函数;返回集合的函数必须是 `STABLE` 或 `IMMUTABLE`。
内联很重要,因为从规划器的角度看,它会移除函数边界。这样,外围查询中的谓词有时就可以下推到函数体中,连接也可以跨越原来的边界重新排序。
简单标量 SQL 函数的函数体可以在规划前直接替换进主 SQL 语句。在这种情况下,不存在函数调用开销。
对于标量 SQL 函数,限制包括易变性的一致性。声明为 `STABLE` 的函数不能安全地内联调用 `random()` 这类易变操作的函数体。将 `rnd()` 标记为 `STABLE`:
```sql
ALTER FUNCTION rnd() STABLE;
EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;
QUERY PLAN
------------------------------------------------------
Result
One-Time Filter: (rnd() > '0.5'::double precision)
-> Function Scan on generate_series
(3 rows)
```
封装函数仍然可见。
恢复真实的易变性:
```sql
ALTER FUNCTION rnd() VOLATILE;
EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;
QUERY PLAN
------------------------------------------------
Function Scan on generate_series
Filter: (random() > '0.5'::double precision)
(2 rows)
```
现在过滤条件直接引用 `random()`,绕过了 `rnd()` 封装函数。
### 调用返回集合的函数 {#qpt-p156-calling-set-returning-functions}
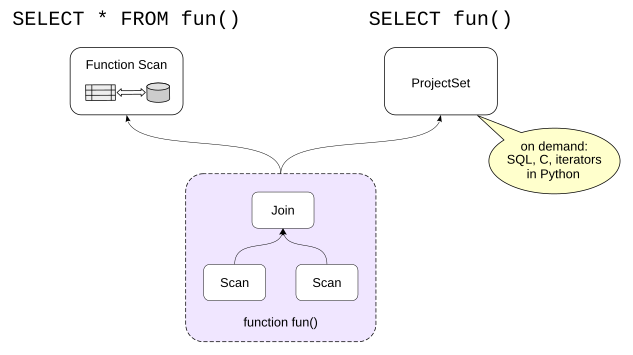
当返回集合的函数作为表表达式出现在 `FROM` 中时,PostgreSQL 使用 `Function Scan` 表示它。在这种情况下,函数返回的所有行都会先物化,然后才传给父计划节点。这是当前实现的限制。
当返回集合的表达式出现在目标列表中时,PostgreSQL 使用 `ProjectSet`,可以按需产生行。SQL 函数、以 C 编写的大多数内置函数,以及返回迭代器的 PL/Python 函数都以这种方式工作。如果语言实现支持相同接口,其他编程语言中的函数也可以采用这种方式。
在 `LIMIT` 下,两者的差异可能非常大。在 `FROM` 中调用 `generate_series`:
```sql
EXPLAIN (analyze, costs off, buffers off)
SELECT * FROM generate_series(1,10_000_000)
LIMIT 10;
```
```text
QUERY PLAN
------------------------------------------------------------
Limit (actual time=290.495..290.497 rows=10.00 loops=1)
-> Function Scan on generate_series (actual time=290....
Planning Time: 0.025 ms
Execution Time: 296.988 ms
(4 rows)
```
现在把返回集合的函数放入目标列表:
```sql
EXPLAIN (analyze, costs off, buffers off)
SELECT generate_series(1,10_000_000)
LIMIT 10;
QUERY PLAN
------------------------------------------------------------
Limit (actual time=0.002..0.003 rows=10.00 loops=1)
-> ProjectSet (actual time=0.001..0.002 rows=10.00 lo...
-> Result (actual time=0.000..0.000 rows=1.00 loo...
Planning Time: 0.020 ms
Execution Time: 0.010 ms
(5 rows)
```
在第一个计划中,`Function Scan` 在应用 `Limit` 之前从函数获取全部行。在第二个计划中,`ProjectSet` 只产生十行——正好是 `Limit` 请求的数量。
{#qpt-fig-8-3 num="8.3" caption="Function Scan 与 ProjectSet" .book-original-figure .d-flex .flex-column .align-items-center width=422 height=237}
查询执行时间下降了几个数量级。`Result` 节点表示被省略的 `FROM` 子句,并向父节点恰好传递一行。
这并不意味着所有函数语言都能流式产生行。例如,PL/pgSQL 返回集合的函数当前会在将完整结果返回给调用方的执行器接口之前,先将结果全部物化。
```sql
CREATE FUNCTION plpgsql_rows() RETURNS SETOF integer
AS $$
BEGIN
RETURN QUERY
SELECT * FROM generate_series(1,10_000_000);
END
$$ LANGUAGE plpgsql;
CREATE FUNCTION
EXPLAIN (analyze, costs off, buffers off)
SELECT plpgsql_rows() LIMIT 10;
QUERY PLAN
------------------------------------------------------------
Limit (actual time=652.500..652.502 rows=10.00 loops=1)
-> ProjectSet (actual time=652.499..652.500 rows=10.0...
-> Result (actual time=0.000..0.000 rows=1.00 loo...
Planning Time: 0.020 ms
Execution Time: 660.376 ms
(5 rows)
```
计划仍然包含 `ProjectSet`,但函数实现已经在第一行产生之前完成了昂贵工作。执行时间清楚地显示了这一点。
### COST 和 ROWS {#qpt-p158-cost-and-rows}
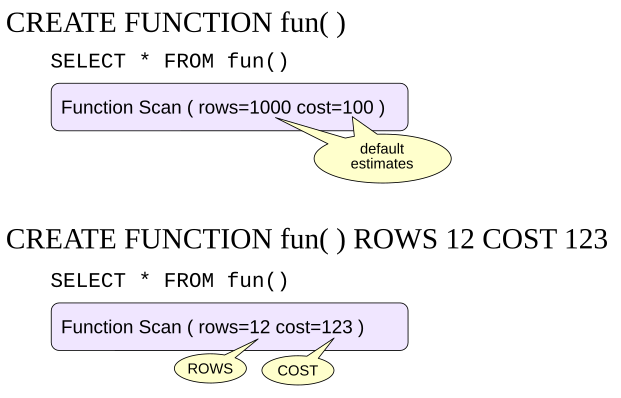
函数无法内联时,规划器通常只能把它基本当成黑盒。`CREATE FUNCTION` 允许我们提供两个重要的估计值。
`COST` 是以 `cpu_operator_cost` 为单位的估计执行代价。对于返回集合的函数,它表示每个返回行的代价。对于 C 语言函数和内部函数,默认值是 1;对于其他语言的函数,默认值是 100。
`ROWS` 是返回集合的函数预计返回的行数。默认值是 1000。
{#qpt-fig-8-4 num="8.4" caption="函数 COST 和 ROWS 估计" .book-original-figure .d-flex .flex-column .align-items-center width=414 height=265}
创建一个返回一周各日名称的 PL/pgSQL 函数:
```sql
CREATE FUNCTION days_of_week() RETURNS SETOF text
AS $$
BEGIN
FOR i IN 7 .. 13 LOOP
RETURN NEXT to_char(to_date(i::text,'J'),'TMDy');
END LOOP;
END;
$$ LANGUAGE plpgsql;
CREATE FUNCTION
```
```sql
SELECT * FROM days_of_week();
days_of_week
--------------
Mon
Tue
Wed
Thu
Fri
Sat
Sun
(7 rows)
```
查询计划:
```sql
EXPLAIN SELECT * FROM days_of_week();
QUERY PLAN
-----------------------------------------
Function Scan on days_of_week
(cost=0.25..10.25 rows=1000 width=32)
(2 rows)
```
服务器把这个函数结果的基数估计为 1000 行,尽管实际值为 7。
启动部分反映函数代价估计:
```sql
SELECT 100 * current_setting('cpu_operator_cost')::float;
?column?
----------
0.25
(1 row)
```
提高函数代价:
```sql
ALTER FUNCTION days_of_week COST 10000;
EXPLAIN SELECT * FROM days_of_week();
QUERY PLAN
------------------------------------------
Function Scan on days_of_week
(cost=25.00..35.00 rows=1000 width=32)
(2 rows)
```
设置函数预计返回的行数:
```sql
ALTER FUNCTION days_of_week ROWS 10;
EXPLAIN SELECT * FROM days_of_week();
QUERY PLAN
----------------------------------------
Function Scan on days_of_week
(cost=25.00..25.10 rows=10 width=32)
(2 rows)
```
得到的估计代价为:
```sql
SELECT 10000 * current_setting('cpu_operator_cost')::float
+ 10 * current_setting('cpu_tuple_cost')::float;
?column?
----------
25.1
(1 row)
```
在 `pg_proc` 中或通过元命令检查这些值:
```sql
SELECT procost, prorows
FROM pg_proc WHERE proname='days_of_week';
procost | prorows
---------+---------
10000 | 10
(1 row)
```
```sql
\sf days_of_week
CREATE OR REPLACE FUNCTION bookings.days_of_week()
RETURNS SETOF text
LANGUAGE plpgsql
COST 10000 ROWS 10
AS $function$
BEGIN
FOR i IN 7 .. 13 LOOP
RETURN NEXT to_char(to_date(i::text,'J'),'TMDy');
END LOOP;
END;
$function$
```
### 规划器支持函数 {#qpt-p162-planner-support-functions}
`COST` 和 `ROWS` 子句允许我们把函数代价和行数指定为常量。不过,固定值并不总是足够好。
在 PostgreSQL 中,目标函数可以拥有一个**规划器支持函数**(planner support function),根据目标函数的参数值向规划器提供相关信息。
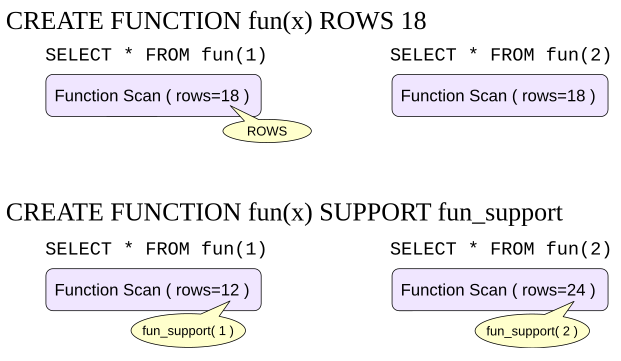
{#qpt-fig-8-5 num="8.5" caption="感知参数的规划器支持" .book-original-figure .d-flex .flex-column .align-items-center width=414 height=240}
规划器支持函数可以提供以下信息(以及其他信息):
- 函数代价估计;
- 返回行数估计;
- 与函数调用等价的表达式。
对于 `boolean` 函数,它还可以提供:
- 选择率估计;
- 使用可索引操作符的等价谓词。
规划器支持函数使用 PostgreSQL 的内部规划器 API,目前必须用 C 编写。
### 并行安全标签 {#qpt-p163-parallel-safety-labels}
并非每个查询都能并行运行。规划器无法安全推断用户定义函数的所有可能影响。因此,并行执行依赖显式的函数标签。
函数可以是:
- `PARALLEL UNSAFE`:它的存在会阻止查询使用并行计划;
- `PARALLEL RESTRICTED`:它可以参与使用并行的查询,但只能在并行组领导者中执行;
- `PARALLEL SAFE`:它可以在并行工作进程中执行。
用户定义函数的默认值是 `PARALLEL UNSAFE`。用户定义的聚合函数也会指定并行安全标签。
所有基本标准函数都是并行安全的。
```sql
SELECT proparallel, count(*)
FROM pg_proc
GROUP BY proparallel;
proparallel | count
-------------+-------
r | 202
s | 3374
u | 109
(3 rows)
```
具体数量取决于已安装的扩展和 PostgreSQL 小版本。
`psql` 也会显示这个标签:
```text
\x \df+ random numeric \x
Expanded display is on.
List of functions
-[ RECORD 1 ]-------+-------------------------
Schema | pg_catalog
Name | random
Result data type | numeric
Argument data types | min numeric, max numeric
Type | func
Volatility | volatile
Parallel | restricted
Owner | postgres
Security | invoker
Leakproof? | no
Access privileges |
Language | internal
Internal name | numeric_random
Description | random numeric in range
Expanded display is off.
```
现在创建一个函数,计算一张机票对应的航段价格总和:
```sql
CREATE FUNCTION ticket_price(ticket_no char(13))
RETURNS numeric
LANGUAGE plpgsql STABLE PARALLEL SAFE
AS $$
BEGIN
RETURN (SELECT sum(price)
FROM segments s
WHERE s.ticket_no = ticket_price.ticket_no
);
END;
$$;
CREATE FUNCTION
```
在一个子查询中使用它,并将该总和与另一个子查询得到的预订总金额进行比较:
```sql
EXPLAIN (costs off) SELECT
(SELECT sum(ticket_price(ticket_no)) FROM tickets) =
(SELECT sum(total_amount) FROM bookings);
QUERY PLAN
--------------------------------------------------
Result
InitPlan 1
-> Finalize Aggregate
-> Gather
Workers Planned: 2
-> Partial Aggregate
-> Parallel Seq Scan on tickets
InitPlan 2
-> Finalize Aggregate
-> Gather
Workers Planned: 2
-> Partial Aggregate
-> Parallel Seq Scan on bookings
(13 rows)
```
函数标记为安全后,两个子查询都可以使用并行计划。
将它标记为不安全:
```sql
ALTER FUNCTION ticket_price PARALLEL UNSAFE;
EXPLAIN (costs off) SELECT
(SELECT sum(ticket_price(ticket_no)) FROM tickets) =
(SELECT sum(total_amount) FROM bookings);
QUERY PLAN
---------------------------------
Result
InitPlan 1
-> Aggregate
-> Seq Scan on tickets
InitPlan 2
-> Aggregate
-> Seq Scan on bookings
(7 rows)
```
一个不安全函数就会禁用该语句的并行查询。
现在把它标记为受限:
```sql
ALTER FUNCTION ticket_price PARALLEL RESTRICTED;
EXPLAIN (costs off) SELECT
(SELECT sum(ticket_price(ticket_no)) FROM tickets) =
(SELECT sum(total_amount) FROM bookings);
QUERY PLAN
--------------------------------------------------
Result
InitPlan 1
-> Aggregate
-> Seq Scan on tickets
InitPlan 2
-> Finalize Aggregate
-> Gather
Workers Planned: 2
-> Partial Aggregate
-> Parallel Seq Scan on bookings
(10 rows)
```
调用受限函数的子查询必须在领导者中运行,而独立的 `bookings` 子查询仍然可以使用并行工作进程。
安全标签不只是性能提示。错误标记函数可能导致报错或返回错误结果。如果不确定,应使用更严格的标签。
## 参考资源 {#referenced-resources}
- [github.com/sraoss/pg\_ivm]()
- [postgrespro.ru/docs/enterprise/16/sql-createfunction]()
- [wiki.postgresql.org/wiki/Inlining\_of\_SQL\_functions]()
- [www.postgresql.org/docs/18/parallel-safety]()
- [www.postgresql.org/docs/18/queries-with]()
- [www.postgresql.org/docs/18/sql-creatematerializedview]()
- [www.postgresql.org/docs/18/sql-createtable]()
- [www.postgresql.org/docs/18/xfunc-optimization]()
- [www.postgresql.org/docs/18/xfunc-volatility]()