5 连接方法比较嵌套循环、哈希和归并连接,了解 Memoize 缓存、哈希批次、并行连接计划以及连接顺序选择。
1. 什么是连接方法 使用前几章讨论的访问方法获取行,只是工作的一部分。我们还需要组合行集。
连接方法是组合两个行集的一种算法。PostgreSQL 不仅使用这些算法实现 SQL JOIN 操作,也用它们实现其他 SQL 结构,例如 EXISTS。这里有两个不同的层次:SQL 连接 是一种逻辑操作,用来定义哪些行属于结果;连接方法 则是高效产生该结果的一种可能的物理算法。
我们经常说 PostgreSQL 连接表。这是一种方便的简写,但执行器实际连接的是行集。行集可以通过访问方法直接来自表,也可以是另一个连接、聚合、子查询或其他计划子树的结果。
连接是二元的:每个连接节点组合两个输入。对于普通内连接,多个关系的连接顺序通常不会改变逻辑结果,但可能显著改变性能。一个物理连接的两个输入顺序也可能影响性能。
PostgreSQL 有三种主要连接方法:嵌套循环、哈希连接和归并连接。
2. 嵌套循环连接 基本的嵌套循环算法很简单:对于一个输入中的每一行,扫描另一个输入,并返回匹配的行。从概念上看,它就是两个嵌套循环,因此得名。
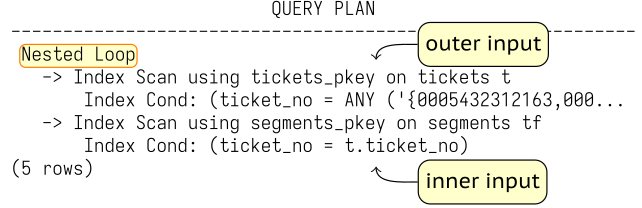
第一个输入通常称为外部 输入(outer input),第二个输入称为内部 输入(inner input)。当 PostgreSQL 可以使用当前外部行中的值,在内部输入中执行廉价查找时,嵌套循环尤其有吸引力。索引就是典型例子。如果内部一侧必须针对每个外部行从头到尾扫描,那么可能会多次检查同一批无关的行。
对于非常小的输入,即使重复扫描也可能很便宜。下面是一个小结果集的典型嵌套循环计划。我们查找属于两张机票的航段:
EXPLAIN ( costs off ) SELECT *
FROM tickets t
JOIN segments tf ON tf . ticket_no = t . ticket_no
WHERE t . ticket_no IN ( '0005432312163' , '0005432312164' );
QUERY PLAN
------------------------------------------------------------
Nested Loop
-> Index Scan using tickets_pkey on tickets t
Index Cond : ( ticket_no = ANY ( '{0005432312163,000...
-> Index Scan using segments_pkey on segments tf
Index Cond: (ticket_no = t.ticket_no)
(5 rows) 说明
外部输入:tickets t 上的 Index Scan。内部输入:segments tf 上的 Index Scan。
图 5.1 嵌套循环连接 这是一个参数化 嵌套循环。外部 Index Scan 产生一行机票数据。该行中的 t.ticket_no 值会成为对 segments 执行内部 Index Scan 时的一个参数。在每次迭代中,内部查找实际上会使用类似 ticket_no = 常量的条件执行。
这个过程会持续到外部输入耗尽。
现在考虑另一个嵌套循环。我们列出航程足以覆盖两个所需距离的飞机:
EXPLAIN ( costs off ) SELECT *
FROM ( VALUES ( 1000 ), ( 10000 ) ) d ( range )
JOIN airplanes a ON a . range >= d . range ;
QUERY PLAN
-------------------------------------------------
Nested Loop
Join Filter : ( ml . range >= "*VALUES*" . column1 )
-> Seq Scan on airplanes_data ml
-> Materialize
-> Values Scan on "*VALUES*"
( 5 rows ) 这个连接不是参数化的 。内部输入没有使用从当前外部行推导出的访问条件。相反,内部行集会被反复读取,并由 Join Filter 检查行对。Materialize 保留很小的 VALUES 结果,以便重复扫描,因此 PostgreSQL 不必在每次迭代时都从头构造它。从概念上说,这是先做笛卡尔积,再进行过滤。
嵌套循环不要求存在相等条件。它基本上可以实现 PostgreSQL 能够计算的任何连接谓词。
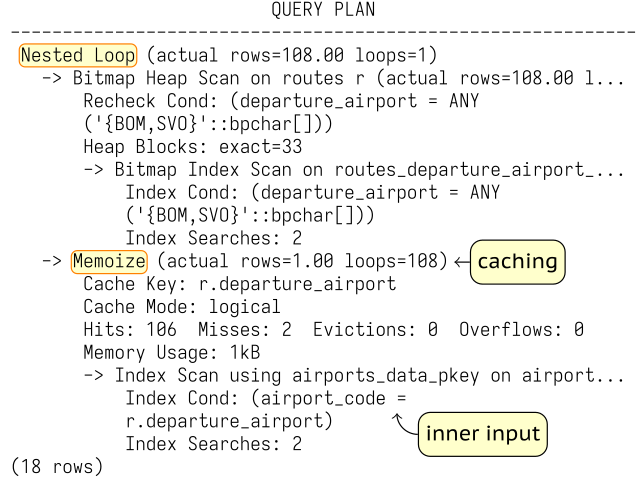
Memoize 如果参数化的内部查找会以相同的参数值执行很多次,重复完成相同工作就很浪费。PostgreSQL 可以把结果缓存在放置于内部计划之上的 Memoize 节点中。
如果规划器的估计错误地表明记忆化(memoization)有益,可以使用 enable_memoize = off 将其禁用。
考虑 routes 和 airports 之间的连接:
EXPLAIN ( analyze , costs off , timing off , buffers off )
SELECT * FROM routes r
JOIN airports a ON a . airport_code = r . departure_airport
WHERE r . departure_airport in ( 'BOM' , 'SVO' );
QUERY PLAN
------------------------------------------------------------
Nested Loop ( actual rows = 108 . 00 loops = 1 )
-> Bitmap Heap Scan on routes r ( actual rows = 108 . 00 l ...
Recheck Cond : ( departure_airport = ANY
( '{BOM,SVO}' :: bpchar []))
Heap Blocks : exact = 33
-> Bitmap Index Scan on routes_departure_airport_ ...
Index Cond : ( departure_airport = ANY
( '{BOM,SVO}' :: bpchar []))
Index Searches : 2
-> Memoize ( actual rows = 1 . 00 loops = 108 )
Cache Key : r . departure_airport
Cache Mode : logical
Hits : 106 Misses : 2 Evictions : 0 Overflows : 0
Memory Usage : 1 kB
-> Index Scan using airports_data_pkey on airport ...
Index Cond : ( airport_code =
r . departure_airport )
Index Searches : 2
( 18 rows ) 说明
缓存:Memoize。内部输入:airports_data 上的 Index Scan。
图 5.2 Memoize 这个例子经过有意选择,使得只有两个非重复的参数值到达内部一侧:BOM 和 SVO。
每个值的第一次查找都会发生缓存未命中:Misses: 2。
其余 106 次查找都由缓存提供:Hits: 106。
没有条目需要被驱逐(Evictions: 0),没有缓存结果溢出其空间(Overflows: 0),缓存只使用了 1 kB。
在内部,缓存以内部扫描的参数值为键。如果外部一侧重复使用相同的键,Memoize
执行代价 一个好的第一近似是 N × cost ( inner probe ) N \times \operatorname{cost}(\text{inner probe}) N × cost ( inner probe ) O ( N × M ) O(N \times M) O ( N × M )
不过,对于参数化嵌套循环,一次内部探测的代价可能远小于扫描 M 行的代价。例如,唯一 B-树查找经过一次很短的树下降后,至多可以找到一个匹配行。重复探测也可能受益于缓存或 Memoize。
当外部输入很小,并且内部输入的行可以廉价访问时,嵌套循环连接很有效。特别是,这种方法与索引访问结合使用,是 OLTP 查询的典型方式,适合快速返回少量行。
并行计划中的嵌套循环 嵌套循环可以参与并行计划。
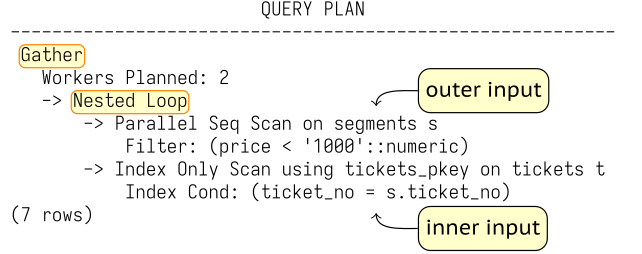
多个工作进程会并行扫描外部行集。每个工作进程接收一些外部行,并独立执行相应的内部扫描。
查找与低价航段关联的机票:
EXPLAIN ( costs off )
SELECT t . ticket_no , s . price
FROM tickets t
JOIN segments s ON s . ticket_no = t . ticket_no
WHERE s . price < 1000 ;
                        QUERY PLAN
----------------------------------------------------------
 Gather
   Workers Planned: 2
   -> Nested Loop
       -> Parallel Seq Scan on segments s
           Filter: (price < '1000'::numeric)
       -> Index Only Scan using tickets_pkey on tickets t
           Index Cond: (ticket_no = s.ticket_no)
(7 rows)
说明
外部输入:segments s 上的 Parallel Seq Scan。内部输入:tickets t 上的 Index Only Scan。
图 5.3 并行计划中的嵌套循环 每个参与的进程都会扫描 segments 的一部分。对于每个符合条件的航段,它都会在 tickets 中执行一次自己的仅索引查找。内部一侧不会因为外部扫描是并行的就自动共享;每个进程都会为分配给它的外部行执行内部计划。
3. 哈希连接
单批次哈希连接 在构建阶段 (build phase),PostgreSQL 读取内部行,并根据连接键计算哈希值。
内存中的哈希表保存连接在后续阶段所需的数据:哈希值,以及连接本身或其上方节点所需的内部行投影数据。
哈希操作的内存预算基于 work_mem × hash_mem_multiplier。
对于串行哈希连接,最佳情况是完整哈希表能够放进这个预算。在这种情况下,EXPLAIN ANALYZE 会报告 Batches: 1。
在探测阶段 (probe phase),PostgreSQL 按顺序读取外部输入。对于每个外部行,它计算相应的哈希值,定位候选桶,然后检查实际的连接条件。
仅检查哈希码是不够的。首先,查询中的并非所有连接条件都能用于哈希连接:由于哈希函数不保持值的顺序,哈希连接只支持等值连接。其次,冲突是可能发生的,不同的值可能得到相同的哈希码。发生冲突的概率很小,但不能排除。
下面的例子需要两个输入的大部分内容,因此哈希连接是自然的选择:
EXPLAIN ( costs off )
SELECT *
FROM airplanes a
JOIN seats s ON a . airplane_code = s . airplane_code ;
QUERY PLAN
---------------------------------------------------
Hash Join
Hash Cond : ( s . airplane_code = ml . airplane_code )
-> Seq Scan on seats s
-> Hash
-> Seq Scan on airplanes_data ml
( 5 rows ) 说明
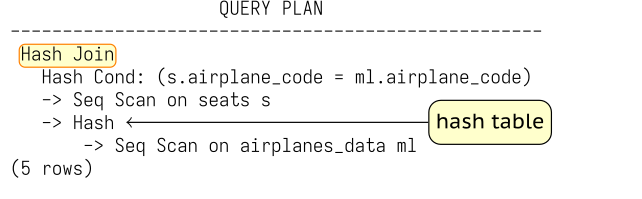
哈希表:airplanes_data 上的 Seq Scan 之上的 Hash 节点。
图 5.4 单批次哈希连接 Hash Join 首先请求其 Hash 子节点读取内部输入并构建哈希表。然后它读取外部输入并探测该表,在找到匹配项时返回它们。
运行查询:
EXPLAIN ( analyze , costs off , timing off , buffers off )
SELECT *
FROM airplanes a
JOIN seats s ON a . airplane_code = s . airplane_code ;
                         QUERY PLAN
------------------------------------------------------------
 Hash Join (actual rows=1741.00 loops=1)
   Hash Cond: (s.airplane_code = ml.airplane_code)
   -> Seq Scan on seats s (actual rows=1741.00 loops=1)
   -> Hash (actual rows=10.00 loops=1)
       Buckets: 1024  Batches: 1  Memory Usage: 10kB
       -> Seq Scan on airplanes_data ml (actual rows=10....
 Planning Time: 0.047 ms
 Execution Time: 1.255 ms
(8 rows)
哈希表可以放进内存。它使用 1024 个桶,约占 10 kB。规划器选择小得多的 airplanes_data 输入作为构建侧。
规划器选择小得多的 airplanes_data 输入作为构建侧。
多批次哈希连接 如果规划器估计哈希表无法放进大小为 work_mem × hash_mem_multiplier 的内存中,就会把内部输入划分成多个批次 ,分别处理每个批次。和桶的数量一样,批次的数量总是 2 的幂;批次编号由哈希值中的若干位决定。可能彼此匹配的行总是属于同一个批次。理想情况下,每个批次包含大致相同数量的行,但如果行中的值重复,就可能出现偏斜。
规划查询时,会预先计算所需的最小批次数,以便每个批次的哈希表都能放入内存。即使规划器的估计后来被证明过于保守,这个数量也不会
首先,PostgreSQL 读取内部输入并构建哈希表。属于第一个批次的行保留在内存中。属于其他批次的行则写入不同的临时文件。
然后 PostgreSQL 读取外部输入。属于第一个批次的行会立即与内存中的第一个哈希表批次匹配。属于其他批次的行会写入不同的临时文件。因此,对于 N 个批次,最多会使用 2 ( N − 1 ) 2(N-1) 2 ( N − 1 )
会话中临时文件使用的磁盘空间受 temp_file_limit 的值限制;临时表不包含在这个限制中。
之后,哈希表占用的内存会被释放。此时,连接已经得到第一个批次的部分结果。
接着 PostgreSQL 逐个处理保存在磁盘上的批次。它从临时文件把某个批次的内部行加载进哈希表,从另一个临时文件读取匹配的外部行,然后将它们连接起来。已经处理过的临时文件会被删除。这个过程会重复,直到所有批次都完成连接。
连接 bookings 和 tickets 这两张大表:
EXPLAIN ( analyze , costs off , timing off , summary off )
SELECT *
FROM bookings b
JOIN tickets t ON b . book_ref = t . book_ref ;
                         QUERY PLAN
------------------------------------------------------------
 Hash Join (actual rows=5598473.00 loops=1)
   Hash Cond: (t.book_ref = b.book_ref)
   Buffers: shared hit=15839 read=57833 written=2, temp
   read=60337 written=60337
   -> Seq Scan on tickets t (actual rows=5598473.00 loop...
       Buffers: shared read=57816 written=2
   -> Hash (actual rows=2486710.00 loops=1)
       Buckets: 131072  Batches: 32  Memory Usage: 5155kB
       Buffers: shared hit=15839 read=17, temp
       written=12364
       -> Seq Scan on bookings b (actual rows=2486710.00...
           Buffers: shared hit=15839 read=17
 Planning:
   Buffers: shared hit=34 read=14
(14 rows)
哈希连接使用 32 个批次。Hash 节点会溢出构建侧数据,而在处理这些批次时,Hash Join 节点也会读写临时数据。
现在只返回一列:
EXPLAIN ( analyze , costs off , timing off , summary off )
SELECT b . book_ref
FROM bookings b
JOIN tickets t ON b . book_ref = t . book_ref ;
QUERY PLAN
------------------------------------------------------------
Hash Join ( actual rows = 5598473 . 00 loops = 1 )
Hash Cond : ( t . book_ref = b . book_ref )
Buffers : shared hit = 15950 read = 57722 , temp read = 25850
written = 25850
-> Seq Scan on tickets t ( actual rows = 5598473 . 00 loop ...
Buffers : shared hit = 94 read = 57722
-> Hash ( actual rows = 2486710 . 00 loops = 1 )
Buckets : 262144 Batches : 32 Memory Usage : 5002 kB
Buffers : shared hit = 15856 , temp written = 7927
-> Seq Scan on bookings b ( actual rows = 2486710 . 00 ...
Buffers : shared hit = 15856
Planning :
Buffers : shared hit = 18
( 13 rows )
内存消耗降低了,因为现在哈希表只包含一个字段,而不是构成 bookings 表一行的三个字段。
因此,下面两点很重要:
只有实际需要的字段才应放进哈希表;
哈希表应在较小的输入上构建。
第一点是查询作者的责任,第二点是规划器的责任。
执行代价 如果哈希分布良好且哈希表位于内存中,构建和探测的基本工作量预计大致与两个输入大小之和 N + M N+M N + M
不过,哈希表必须构建完成后连接才能开始,因此对于少量行,嵌套循环更高效。
哈希连接与整表扫描结合,典型用于处理大量行的 OLAP 查询;这类查询更重视总体吞吐量,而不是响应时间。
并行哈希连接 与其他连接方法不同,哈希连接不仅可以参与并行计划,还拥有高效的并行感知算法。它会将连接的两个阶段都并行化:从内部输入构建哈希表,以及使用enable_parallel_hash 控制,默认启用。
在这种情况下,内存预算是 work_mem × hash_mem_multiplier × 进程数。所有进程都可以协助扫描内部输入并构建一张共享哈希表。构建阶段完成后,它们协作扫描外部输入并探测这张共享表。
增加每个进程可用于构建哈希表的内存量,并运行聚合查询:
SET work_mem = '32MB' ;
EXPLAIN ( analyze , costs off , timing off , buffers off )
SELECT count ( * )
FROM bookings b
JOIN tickets t ON b . book_ref = t . book_ref ;
QUERY PLAN
------------------------------------------------------------
Finalize Aggregate ( actual rows = 1 . 00 loops = 1 )
-> Gather ( actual rows = 3 . 00 loops = 1 )
Workers Planned : 2
Workers Launched : 2
-> Partial Aggregate ( actual rows = 1 . 00 loops = 3 )
-> Parallel Hash Join ( actual rows = 1866157 . 67 ...
Hash Cond : ( t . book_ref = b . book_ref )
-> Parallel Seq Scan on tickets t ( actual ...
-> Parallel Hash ( actual rows = 828903 . 33 l ...
Buckets : 4194304 Batches : 1 Memory
Usage : 130080 kB
-> Parallel Seq Scan on bookings b ( a ...
Planning Time : 0 . 161 ms
Execution Time : 625 . 430 ms
( 14 rows ) 注意,分配的内存超过了单个进程的预算:在这个例子中,work_mem × hash_mem_multiplier = 64 MB。Batches: 1 表明连接保持为单批次 。
如果并行进程合计可用的内存仍不足以容纳整个哈希表,PostgreSQL 会使用多批次 并行算法。
首先,进程并行读取内部输入,将其划分为批次,并把批次写入临时文件。与串行算法不同,包括第一个批次在内的所有批次都会写入磁盘:每个进程只读取内部输入的一部分,因此没有任何一个进程单独拥有完整批次。
之后,外部输入也会并行读取、划分为批次并写入临时文件。外部输入读取完成后,对于 N 个批次会有 2N 个临时文件:每个批次各有一个内部文件和一个外部文件。
然后,每个进程选择一个尚未处理的批次,将该批次的内部行加载进哈希表,读取对应的外部行,并执行连接。在多批次算法中,每个进程都有一张大小为 work_mem × hash_mem_multiplier 的哈希表,但这些表位于共享内存中,这意味着每个并行工作进程都可以访问每张表。
一个进程完成一个批次后,会选择另一个批次。如果没有未处理的批次,空闲进程可以协助处理其他进程尚未完成的批次,因为哈希表位于共享内存中。
使用多张较小的哈希表可以让协调更简单。与让所有进程共同使用一张大型共享哈希表相比,这种方式也能减少同步开销。
降低内存设置:
运行同一查询:
EXPLAIN ( analyze , costs off , timing off , buffers off )
SELECT count ( * )
FROM bookings b
JOIN tickets t ON b . book_ref = t . book_ref ;
QUERY PLAN
------------------------------------------------------------
Finalize Aggregate ( actual rows = 1 . 00 loops = 1 )
-> Gather ( actual rows = 3 . 00 loops = 1 )
Workers Planned : 2
Workers Launched : 2
-> Partial Aggregate ( actual rows = 1 . 00 loops = 3 )
-> Parallel Hash Join ( actual rows = 1866157 . 67 ...
Hash Cond : ( t . book_ref = b . book_ref )
-> Parallel Seq Scan on tickets t ( actual ...
-> Parallel Hash ( actual rows = 828903 . 33 l ...
Buckets : 1048576 Batches : 8 Memory
Usage : 20416 kB
-> Parallel Seq Scan on bookings b ( a ...
Planning Time : 0 . 112 ms
Execution Time : 647 . 388 ms
( 14 rows ) 连接现在使用八个批次。
4. 归并连接 第三种主要连接方法是归并连接。归并连接利用有序输入。如果两个行集都按兼容的连接键排序,PostgreSQL 就可以按键顺序推进它们,并组合匹配的组。Gather Merge 节点的工作方式类似:它把已经排序的流合并成一个有序流。
排序可能很昂贵——比较排序通常为 O ( N log N ) O(N \log N) O ( N log N )
B-树索引可能已经提供了所需顺序,或者较早的计划节点可能保留了这个顺序。
一个简化的思维模型是:当前键较小的输入不断前进,直到其键值追上另一侧。当键相等时,就产生匹配行。重复的连接键会使这个模型复杂一些。如果一侧或两侧输入都包含多个相同键的行,PostgreSQL 必须为该键产生所有匹配组合。
考虑一个连接,其中两个输入已经具有所需的顺序:
EXPLAIN ( costs off ) SELECT *
FROM tickets t
JOIN segments tf ON tf . ticket_no = t . ticket_no
ORDER BY t . ticket_no ;
QUERY PLAN
----------------------------------------------------
Merge Join
Merge Cond : ( t . ticket_no = tf . ticket_no )
-> Index Scan using tickets_pkey on tickets t
-> Index Scan using segments_pkey on segments tf
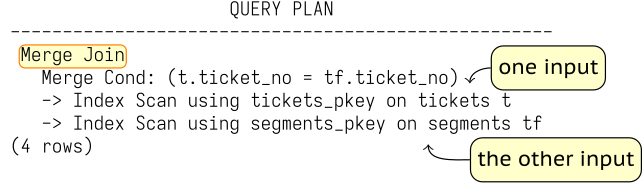
( 4 rows ) 说明
一个输入:tickets t 上的 Index Scan。另一个输入:segments tf 上的 Index Scan。
图 5.5 归并连接 归并连接的一个重要性质是,它按排序顺序返回连接结果。特别是,得到的行集可以在无需再次排序的情况下用于另一个归并连接;也可以像这个例子一样,直接返回给客户端。
下面的例子中,一个 Merge Join 从另一个 Merge Join 接收已经排序的行集:
EXPLAIN ( costs off )
SELECT t . ticket_no , bp . flight_id , bp . seat_no
FROM tickets t
JOIN segments tf ON t . ticket_no = tf . ticket_no
JOIN boarding_passes bp ON bp . ticket_no = tf . ticket_no
AND bp . flight_id = tf . flight_id
ORDER BY t . ticket_no ;
                         QUERY PLAN
------------------------------------------------------------
 Merge Join
   Merge Cond: (tf.ticket_no = t.ticket_no)
   -> Merge Join
       Merge Cond: ((tf.ticket_no = bp.ticket_no) AND (t...
       -> Index Only Scan using segments_pkey on segment...
       -> Index Scan using boarding_passes_pkey on board...
   -> Index Only Scan using tickets_pkey on tickets t
(7 rows) 这里,segments 与 boarding_passes 连接,然后 tickets 再与这个已经按机票号排序的行集连接。
执行代价 如果两个输入都已经按归并键排序,基本的归并过程与输入大小成线性关系:O ( N + M ) O(N+M) O ( N + M )
不过,如果需要排序,代价会与 N log N 成正比;对于大量数据,这种方法很可能输给哈希连接。
并行计划中的归并连接 归并连接可以参与并行计划,但 Merge Join 节点本身并不是一种与 Parallel Hash Join 同意义上的并行感知连接算法。
一种常见模式是:并行扫描一个输入,同时每个工作进程独立读取另一个完整输入,直到找到自己需要的匹配行。
对于大型连接,这种重复工作可能使并行哈希连接更有吸引力,因为并行哈希连接的设计就是为了共享构建工作和探测工作。
创建一个索引,让 PostgreSQL 能够廉价地按 book_ref 顺序获取 tickets:
CREATE INDEX ON tickets ( book_ref ); 现在考虑:
EXPLAIN ( costs off ) SELECT count ( * )
FROM bookings b
JOIN (
SELECT book_ref FROM tickets GROUP BY book_ref
) t ON b . book_ref = t . book_ref ;
QUERY PLAN
------------------------------------------------------------
Finalize Aggregate
-> Gather
Workers Planned : 2
-> Partial Aggregate
-> Merge Join
Merge Cond : ( b . book_ref = tickets . book_ref )
-> Parallel Index Only Scan using booking ...
-> Group
Group Key : tickets . book_ref
-> Index Only Scan using tickets_book ...
( 10 rows ) bookings_pkey 的扫描是并行的。不过,tickets 上的分组子查询会由每个执行归并连接的参与进程独立读取。
移除演示索引:
DROP INDEX tickets_book_ref_idx;
DROP INDEX