4 排序与分组
了解 PostgreSQL 18 中的内存排序、外部排序和增量排序、哈希聚合、有序数据分组以及窗口帧。
1. 排序
B-树索引可以按索引顺序产生行。当这个顺序与查询的 ORDER BY 相匹配时,PostgreSQL 有时可以避免显式排序:
EXPLAIN (costs off)
SELECT * FROM flights
ORDER BY flight_id;
                QUERY PLAN
------------------------------------------
 Index Scan using flights_pkey on flights
(1 row)
如果访问路径无法提供所需的排序,PostgreSQL 就需要两个独立的步骤:获取行,再对行排序。
EXPLAIN (costs off)
SELECT * FROM flights
ORDER BY status;
        QUERY PLAN
--------------------------
 Sort
   Sort Key: status
   -> Seq Scan on flights
(3 rows)
内存排序
最简单的情况是,要排序的数据能够放进 work_mem 为排序操作提供的内存中。此时 PostgreSQL 可以在内存中完成排序。EXPLAIN ANALYZE 会显示排序方法和使用的内存量:
EXPLAIN (analyze, timing off, summary off, buffers off)
SELECT *
FROM seats
ORDER BY seat_no;
                         QUERY PLAN
------------------------------------------------------------
 Sort  (cost=121.13..125.48 rows=1741 width=15) (actual ...
   Sort Key: seat_no
   Sort Method: quicksort  Memory: 103kB
   -> Seq Scan on seats  (cost=0.00..27.41 rows=1741 wid...
(4 rows)
普通的 Sort 节点必须读取并排序完输入后才能返回第一行。因此,它的启动代价包括读取完整输入的代价。对于比较排序,典型的工作量按 O(MlogM) 的量级增长,其中 M 是输入行数。
如果查询只需要排序结果中的前 N 行,例如因为使用了 LIMIT,PostgreSQL 可以使用有界的前 N 排序,而不必完整排序每一行:
EXPLAIN (analyze, timing off, summary off, buffers off)
SELECT *
FROM seats
ORDER BY seat_no
LIMIT 100;
                         QUERY PLAN
------------------------------------------------------------
 Limit  (cost=93.95..94.20 rows=100 width=15) (actual ro...
   -> Sort  (cost=93.95..98.30 rows=1741 width=15) (actu...
       Sort Key: seat_no
       Sort Method: top-N heapsort  Memory: 30kB
       -> Seq Scan on seats  (cost=0.00..27.41 rows=1741...
(5 rows)
估计的查询代价更低,排序使用的内存也更少。前 N 堆排序的工作量按 O(MlogN) 的量级增长,而不是完整排序全部 M 行。
外部排序
如果数据集过大,无法在可用内存中完成排序,PostgreSQL 就会使用外部排序。
排序器会在内存所能处理的范围内读取尽可能多的输入,将这部分数据排序,然后把排好序的有序段(run)写入临时文件。
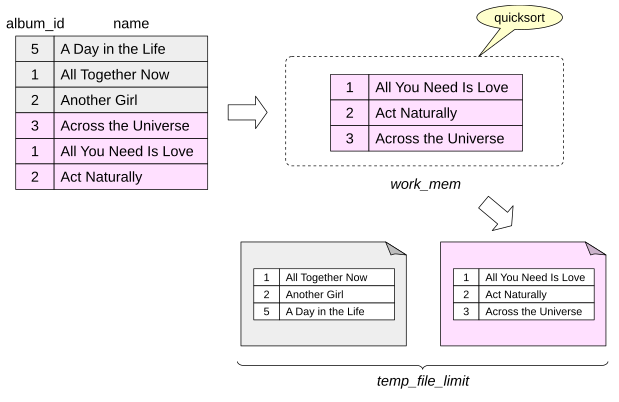 图 4.1 外部排序:写入有序段
这个过程会重复进行,直到所有输入都被转换为各自有序的有序段。
temp_file_limit 限制 PostgreSQL 进程所属临时文件在任一时刻使用的总空间。显式临时表不计入这个限制。
然后合并这些有序段。从概念上看,归并过程会跟踪每个输入有序段的下一个候选值,选择其中最小或最大的一个,将它返回,然后推进对应的有序段。实际实现会以带缓冲的块读取数据,而不是逐行读取,这样可以保持 I/O 效率。
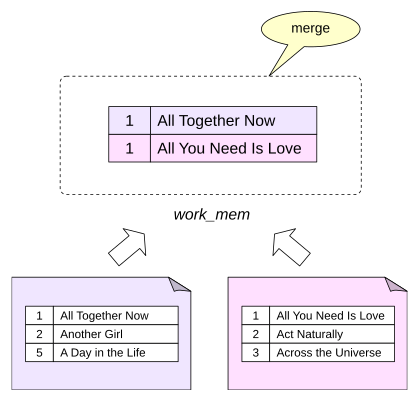 图 4.2 外部排序:合并有序段
如果内存不足以在一趟中合并所有有序段,PostgreSQL 会执行多趟归并:先把多个有序段分组并合并成更大的有序段,再继续合并,直到能够产生最终的有序流。大型排序会在 EXPLAIN ANALYZE 中显示临时存储的使用情况:
EXPLAIN (analyze, timing off, summary off)
SELECT *
FROM bookings
ORDER BY total_amount;
                         QUERY PLAN
------------------------------------------------------------
 Sort  (cost=406880.90..413097.68 rows=2486710 width=21)...
   Sort Key: total_amount
   Sort Method: external merge  Disk: 78176kB
   Buffers: shared read=15856, temp read=19539
   written=19578
   -> Seq Scan on bookings  (cost=0.00..40723.10 rows=24...
       Buffers: shared read=15856
 Planning:
   Buffers: shared hit=34 read=2 dirtied=1
(9 rows)
Sort Method: external merge 告诉我们排序溢出到了磁盘。Disk 值报告排序使用的临时磁盘空间,而临时缓冲区计数器显示临时 I/O。
增量排序
假设查询要求按 K1,…,Km,…,Kn 这些键排序,但输入已经按前 m 个键排好序。此时无需再次对整个数据集排序。PostgreSQL 可以把输入划分为连续的组,这些组在预排序前缀 K1,…,Km 上具有相同值,然后只按剩余键 Km+1,…,Kn 对这些组排序。这就是增量排序。
增量排序可以减少内存需求和溢出到磁盘的可能性,因为每次排序只处理输入中较小的一部分。它还具有延迟优势:第一个组完成排序后,PostgreSQL 就可以开始返回行,不必等待整个输入排序完成。
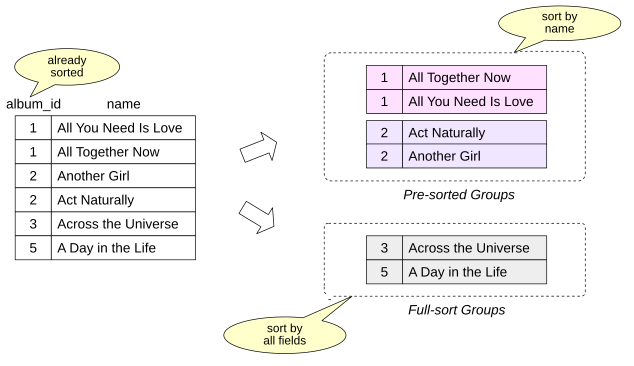 图 4.3 增量排序
代价是识别和处理大量组会带来额外开销。
PostgreSQL 在内部使用两种策略。共享相同预排序前缀的较大组可以分别排序。较小的组可以先累积起来,再一起进行完整排序,以避免每个组都产生过高的处理开销。
可以使用 enable_incremental_sort 禁用增量排序。
在 bookings.total_amount 上创建一个索引:
CREATE INDEX ON bookings(total_amount);
现在增大 work_mem,并按 total_amount 和 book_date 排序:
SET work_mem = '8 MB';
EXPLAIN (analyze, costs off, timing off, buffers off)
SELECT *
FROM bookings
ORDER BY total_amount, book_date;
                         QUERY PLAN
------------------------------------------------------------
 Incremental Sort (actual rows=2486710.00 loops=1)
   Sort Key: total_amount, book_date
   Presorted Key: total_amount
   Full-sort Groups: 3132  Sort Method: quicksort
   Average Memory: 27kB  Peak Memory: 27kB
   Pre-sorted Groups: 2449  Sort Method: quicksort
   Average Memory: 6442kB  Peak Memory: 6464kB
   -> Index Scan using bookings_total_amount_idx on book...
       Index Searches: 1
 Planning Time: 0.128 ms
 Execution Time: 934.215 ms
(11 rows)
索引扫描已经提供了按 total_amount 排序的行,这一点由 Presorted Key 表示。Incremental Sort 只需要建立按 book_date 排序的剩余顺序。
Pre-sorted Groups 描述使用已有 total_amount 顺序处理、再按 book_date 进一步排序的较大组。Full-sort Groups 描述合并后作为完整组排序的较小组。
在这个例子中,两类组都完全放入内存,并使用快速排序。
现在减少 work_mem:
再次运行查询:
EXPLAIN (analyze, costs off, timing off, buffers off)
SELECT *
FROM bookings
ORDER BY total_amount, book_date;
                         QUERY PLAN
------------------------------------------------------------
 Incremental Sort (actual rows=2486710.00 loops=1)
   Sort Key: total_amount, book_date
   Presorted Key: total_amount
   Full-sort Groups: 3132  Sort Method: quicksort
   Average Memory: 27kB  Peak Memory: 27kB
   Pre-sorted Groups: 2449  Sort Method: external merge
   Average Disk: 2662kB  Peak Disk: 2672kB
   -> Index Scan using bookings_total_amount_idx on book...
       Index Searches: 1
 Planning Time: 0.044 ms
 Execution Time: 912.199 ms
(11 rows)
内存减少后,较大的预排序组现在使用外部归并处理,EXPLAIN 也明确报告了它们使用的临时磁盘空间。
恢复设置并移除演示索引:
RESET work_mem;
DROP INDEX bookings_total_amount_idx;
构建 B-树
原则上,PostgreSQL 可以从一棵空树开始,在扫描表时逐个插入索引项,以此构建 B-树索引。对于批量索引构建,这种方式效率很低。
相反,PostgreSQL 会先生成索引项,按索引键对它们排序,再依次填充叶级,随后逐层构建上层,直到只剩下根节点。这里使用的排序机制与上面讨论的排序密切相关,但创建索引使用的是 maintenance_work_mem,而不是普通的 work_mem。维护操作相对不频繁,因此通常可以为它们提供更大的内存预算。
B-树索引构建也可以并行运行。工作进程数量的选择方式与并行查询相同,会根据表的大小决定,但受 max_parallel_maintenance_workers 限制。
对于并行索引构建,maintenance_work_mem 适用于整个构建过程,而不是分别适用于每个工作进程。
2. 分组
分组出现在哪里
SQL 可以使用 GROUP BY 把行划分为多个组。聚合函数通常与这些组一起使用,为每个组计算一个结果。窗口函数通过 PARTITION BY 也有相关概念,但与普通分组不同,窗口函数不会把分区中的行压缩成一行结果。
当必须删除重复项时,也会隐式出现分组,例如使用:DISTINCT;不带 ALL 的 UNION;不带 ALL 的 INTERSECT;不带 ALL 的 EXCEPT。PostgreSQL 可以使用不同的物理策略执行分组和重复消除。
其中两个重要策略是哈希,以及按分组键顺序处理数据。规划器会根据估计代价、内存、下层计划节点已经提供的排序以及查询的其他属性,在可用方案中进行选择。
哈希聚合
哈希表使用哈希函数把值映射到有限数量的桶中。查找时:
- 计算哈希值。
使用哈希值的一部分选择一个桶。
检查桶中的条目,并使用相等比较来区分哈希值或桶分配发生冲突的值。
在负载因子合理且分布良好的情况下,查找预计只需要近似常数时间。分布不佳或哈希表过载会增加处理冲突的工作量。
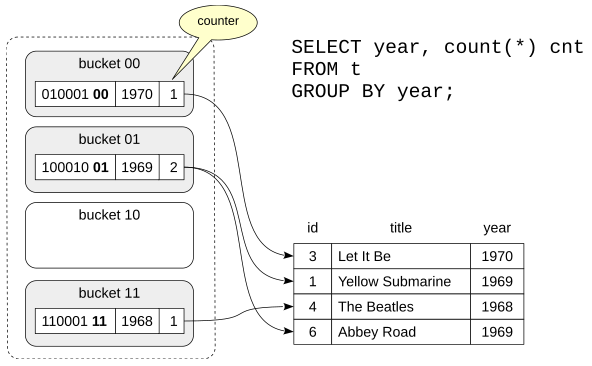 图 4.4 哈希聚合
基于哈希的聚合使用的计划节点是 HashAggregate:
EXPLAIN
SELECT airplane_code, count(*)
FROM seats
GROUP BY airplane_code;
                         QUERY PLAN
------------------------------------------------------------
 HashAggregate  (cost=36.12..36.20 rows=8 width=12)
   Group Key: airplane_code
   -> Seq Scan on seats  (cost=0.00..27.41 rows=1741 wid...
(3 rows)
启动代价很高,因为 HashAggregate 必须读取输入并构建聚合状态,然后才能产生最终的分组。
EXPLAIN ANALYZE 会显示内存使用情况:
EXPLAIN (analyze, timing off, costs off, buffers off)
SELECT airplane_code, count(*)
FROM seats
GROUP BY airplane_code;
                      QUERY PLAN
------------------------------------------------------
 HashAggregate (actual rows=8.00 loops=1)
   Group Key: airplane_code
   Batches: 1  Memory Usage: 32kB
   -> Seq Scan on seats (actual rows=1741.00 loops=1)
 Planning Time: 0.021 ms
 Execution Time: 0.424 ms
(6 rows)
对有序数据分组
重复消除和分组也可以利用按分组键顺序到达的行。
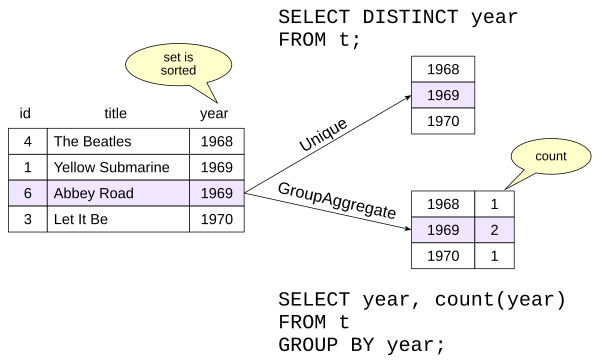 图 4.5 对有序数据分组
Unique 会删除相邻的重复项。由于相等的键彼此相邻,它只需把当前值与前一个值比较。
GroupAggregate 节点返回聚合数据。在图中的例子里,该节点建立 year 字段的非重复值列表,并计算数据集中每个值出现的次数。
当输入已经具有所需的顺序时,Unique 或 GroupAggregate 可能很有吸引力,因为它们只需要相对少量的工作内存,并且可以增量处理数据流。当输入必须先完整排序时,哈希聚合往往代价更低,不过规划器会根据实际估计值做决定,而不是遵循固定规则。
这些节点会保留分组键的顺序,因此有时可以在后续 ORDER BY 中避免再次排序。
下面是一个输入顺序直接来自索引的 GroupAggregate:
EXPLAIN (costs off)
SELECT ticket_no, count(ticket_no)
FROM segments
GROUP BY ticket_no;
                      QUERY PLAN
------------------------------------------------------
 GroupAggregate
   Group Key: ticket_no
   -> Index Only Scan using segments_pkey on segments
(3 rows)
DISTINCT 查询可以使用 Unique:
EXPLAIN (costs off)
SELECT DISTINCT ticket_no
FROM segments
ORDER BY ticket_no;
                      QUERY PLAN
------------------------------------------------------
 Unique
   -> Index Only Scan using segments_pkey on segments
(2 rows)
索引已经按 ORDER BY 所需的顺序产生 ticket_no,而 Unique 会保留这个顺序,因此不需要额外的 Sort 节点。
窗口函数
与普通聚合函数不同,窗口函数为每个输出行计算一个值,而不是把一个组缩减为一行。在函数名之后,OVER 子句指定一个窗口:一条规则,用来确定对于每个结果行,窗口函数应处理哪一组行。这样的行集称为窗口帧(frame)。
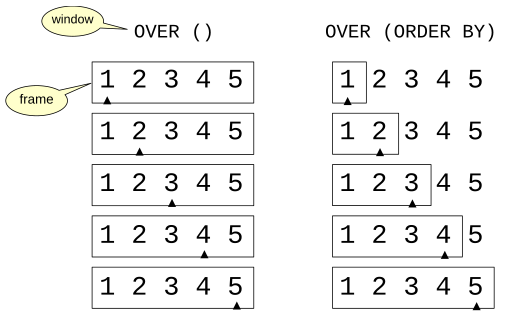 图 4.6 有序与无序时的窗口帧
使用 OVER () 时,没有 PARTITION BY,也没有 ORDER BY。因此这里只有一个包含所有行的分区,默认帧就是整个分区。
如果窗口定义包含用于排列行的 ORDER BY 子句,默认窗口帧会覆盖从第一行到当前行的行。
考虑一个预订金额的累计和:
EXPLAIN
SELECT *, sum(total_amount) OVER (ORDER BY book_date)
FROM bookings;
                         QUERY PLAN
------------------------------------------------------------
 WindowAgg  (cost=406880.92..450398.33 rows=2486710 widt...
   Window: w1 AS (ORDER BY book_date)
   -> Sort  (cost=406880.90..413097.68 rows=2486710 widt...
       Sort Key: book_date
       -> Seq Scan on bookings  (cost=0.00..40723.10 row...
(5 rows)
窗口函数由 WindowAgg 计算。在这里,它的子节点 Sort 建立窗口所需的顺序。排序可以使用任何合适的排序策略。较小的输入可以留在内存中:
EXPLAIN (analyze, timing off, summary off, buffers off)
SELECT *, count(*) OVER (ORDER BY seat_no)
FROM seats;
                         QUERY PLAN
------------------------------------------------------------
 WindowAgg  (cost=121.18..151.59 rows=1741 width=23) (ac...
   Window: w1 AS (ORDER BY seat_no)
   Storage: Memory  Maximum Storage: 17kB
   -> Sort  (cost=121.13..125.48 rows=1741 width=15) (ac...
       Sort Key: seat_no
       Sort Method: quicksort  Memory: 103kB
       -> Seq Scan on seats  (cost=0.00..27.41 rows=1741...
(7 rows)
较大的输入可能需要外部排序:
EXPLAIN (analyze, timing off, summary off, buffers off)
SELECT *, sum(total_amount) OVER (ORDER BY book_date)
FROM bookings;
                         QUERY PLAN
------------------------------------------------------------
 WindowAgg  (cost=406880.92..450398.33 rows=2486710 widt...
   Window: w1 AS (ORDER BY book_date)
   Storage: Memory  Maximum Storage: 17kB
   -> Sort  (cost=406880.90..413097.68 rows=2486710 widt...
       Sort Key: book_date
       Sort Method: external merge  Disk: 75760kB
       -> Seq Scan on bookings  (cost=0.00..40723.10 row...
(7 rows)
对于使用内部行存储的节点,例如 WindowAgg、CTE Scan 或 Recursive Union,Storage 行显示使用的最大存储量及其类型:当数据能放入内存时为 Memory,使用临时文件时为 Disk。
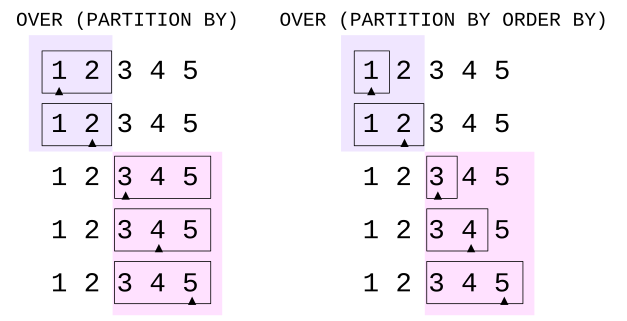 图 4.7 分区中的窗口帧
PARTITION BY 把输入划分为相互独立的行组。对于每个组,窗口帧的边界都会在该组内部变化。如果没有另行指定,窗口帧覆盖整个组。
如果窗口定义还包含 ORDER BY,行会按相应顺序处理。此时,窗口帧覆盖从第一行到当前行的行。
与普通的 GROUP BY 不同,PARTITION BY 总是使用排序:计划会保证 WindowAgg 节点接收到的行,先按 PARTITION BY 键排序,再按 ORDER BY 键排序。即使没有 ORDER BY 子句,也不会使用哈希。