# 访问方法
> 比较顺序扫描、索引扫描、位图扫描、仅索引扫描和并行扫描,了解可见性检查、覆盖索引以及选择率的作用。
---
LLMS 索引: [llms.txt](/llms.txt)
---
## 1. 顺序扫描 {#qpt-section-3-1}
规划器有多种访问表数据的方式。最简单的一种是**顺序扫描**(`Seq Scan`)。
顺序扫描逐页读取表的主分支。和通常一样,普通表通过共享缓冲区缓存读取;临时表使用会话的本地缓冲区。
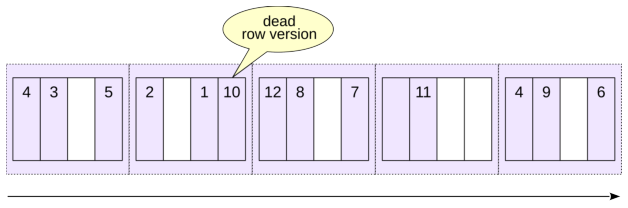
{#qpt-fig-3-1 num="3.1" caption="堆页的顺序扫描" .book-original-figure .d-flex .flex-column .align-items-center width=418 height=138}
顺序扫描期间,PostgreSQL 可以使用操作系统预读或异步 I/O 高效地预取相邻页面,而不必发起彼此无关的随机读取。
当查询必须读取整张表或表的大部分内容时,顺序扫描通常是不错的选择,也就是谓词**筛选作用弱**时:输入行中有很大一部分能够通过谓词。
在查询计划中,顺序扫描由 `Seq Scan` 节点表示:
```sql
EXPLAIN SELECT * FROM flights;
QUERY PLAN
-------------------------------------------
Seq Scan on flights
(cost=0.00..744.71 rows=37671 width=51)
(2 rows)
```
括号中的值很重要:
- `cost` 是估计代价。
- `rows` 是该操作返回的估计行数。
- `width` 是估计的平均行宽,单位为字节。
代价以规划器的任意单位计量,由两个部分组成。
- 第一个数字是**启动代价**:节点返回第一行之前必须支付的代价。对于顺序扫描来说,这个值为零,因为不需要准备工作。
- 第二个数字是产生全部行的**总代价**。
PostgreSQL 的代价模型同时考虑 I/O 工作和 CPU 工作。在本例使用的简化计算中,I/O 部分等于表页数乘以一次顺序页面读取的代价:
```sql
SELECT relpages,
current_setting('seq_page_cost'),
relpages * current_setting('seq_page_cost')::real AS total
FROM pg_class WHERE relname = 'flights';
```
```text
relpages | current_setting | total
----------+-----------------+-------
368 | 1 | 368
(1 row)
```
CPU 部分包括处理表行的代价:
```sql
SELECT reltuples,
current_setting('cpu_tuple_cost'),
reltuples * current_setting('cpu_tuple_cost')::real AS total
FROM pg_class WHERE relname = 'flights';
reltuples | current_setting | total
-----------+-----------------+--------
37671 | 0.01 | 376.71
(1 row)
```
### 死行版本 {#qpt-p36-dead-row-versions}
顺序扫描期间,PostgreSQL 必须检查每个页面中的行版本,其中也包括尚未由清理操作移除的过时版本。如果一张表包含大量死行版本,扫描它的代价可能会显著增加。
这也是及时清理能够提升某些查询性能的原因之一。
创建 `flights` 的副本,并禁用自动清理,使死行版本不会被自动清理:
```sql
CREATE TABLE flights_copy
WITH (autovacuum_enabled = false)
AS SELECT * FROM flights;
SELECT 37671
```
```sql
SELECT pg_size_pretty(
pg_total_relation_size('flights_copy')
);
pg_size_pretty
----------------
3024 kB
(1 row)
```
删除所有行:
```sql
DELETE FROM flights_copy;
DELETE 37671
```
旧的行版本会保留在表文件中,直到清理操作回收它们,因此文件大小仍然相同:
```sql
SELECT pg_size_pretty(
pg_total_relation_size('flights_copy')
);
pg_size_pretty
----------------
3024 kB
(1 row)
```
使用 `analyze` 选项获取查询计划。隐式启用的 `buffers` 选项会显示块的数量:
- `hit`:所需块已经在 PostgreSQL 的缓存中。
- `read`:所需块不在缓冲区缓存中,因此向操作系统请求该块。
- `written`:当前后端写出了一个此前已脏的块。
- `dirtied`:一个此前干净的块变成了脏块。
```sql
EXPLAIN (analyze, timing off, summary off)
SELECT count(*) FROM flights_copy;
QUERY PLAN
------------------------------------------------------------
Aggregate (cost=673.89..673.90 rows=1 width=8) (actual...
Buffers: shared hit=377
-> Seq Scan on flights_copy (cost=0.00..614.51 rows=...
Buffers: shared hit=377
Planning:
Buffers: shared hit=3
(6 rows)
```
这次扫描触碰了三百多个堆页,尽管其中已经没有任何存活行。清理表并再次检查大小:
```sql
VACUUM flights_copy;
SELECT pg_size_pretty(pg_total_relation_size('flights_copy'));
VACUUM
pg_size_pretty
----------------
24 kB
(1 row)
```
死行版本已经被移除,表的大小也随之减小。再次运行查询:
```sql
EXPLAIN (analyze, timing off, summary off)
SELECT count(*) FROM flights_copy;
QUERY PLAN
------------------------------------------------------------
Aggregate (cost=0.00..0.01 rows=1 width=8) (actual row...
-> Seq Scan on flights_copy (cost=0.00..0.00 rows=1 ...
Planning:
Buffers: shared hit=2
(4 rows)
```
表是空的,因此没有需要检查的行版本,估计代价也很小。在大得多的表上,遍历充满过时版本的页面可能会耗费大量工作。
```text
DROP TABLE flights_copy;
DROP TABLE
```
### 缓冲区环与同步扫描 {#qpt-p39-buffer-rings-and-synchronized-scans}
大型顺序扫描可能会让许多只使用一次的页面经过缓冲区缓存,从而驱逐有用的缓存页面。为避免这种情况,对于足够大的堆扫描,PostgreSQL 会使用批量读取缓冲区访问策略。当一个关系大于缓冲区缓存的四分之一时,缓存中只有一部分会被用作**缓冲区环**(buffer ring),替换操作只发生在这个环中,而缓存数据的其余部分不受影响。
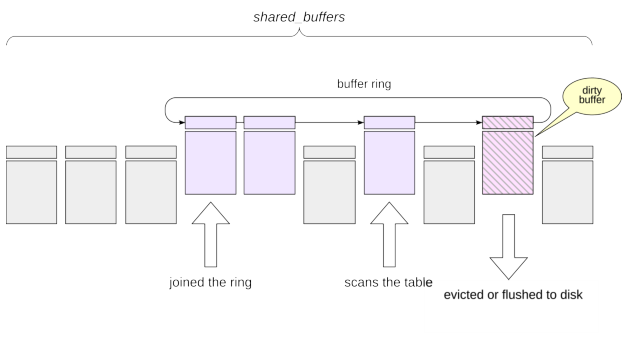
{#qpt-fig-3-2 num="3.2" caption="顺序扫描的缓冲区环" .book-original-figure .d-flex .flex-column .align-items-center width=418 height=226}
大型顺序扫描还可以使用**同步扫描**。当多个后端扫描同一张大表时,新扫描可以从另一个扫描当前所在的位置附近开始,继续读到末尾,然后绕回开头。这样一来,多个后端就更有可能在页面仍处于缓冲区环缓存中时使用同一批页面。
临时表使用本地缓冲区,因此这种缓冲区缓存访问策略和同步扫描机制对临时表不起同样的作用。
## 2. 索引扫描 {#qpt-section-3-2}
我们将使用 PostgreSQL 的一种索引类型——**B-树**(B-tree)——来解释 `Index Scan`。它是标量数据最常用的索引类型。
和 PostgreSQL 的其他索引一样,B-树是一种二级结构。它占用额外的磁盘空间,可以删除,再根据表中的数据重新创建。它的用途是降低访问表中相对较小部分数据的操作代价;B-树索引还用于实施主键约束和唯一约束。
索引把索引值——**搜索键**——与表行版本的引用关联起来。B-树按照明确的排序顺序保存键,因此 PostgreSQL 可以沿树导航到所需的键,然后通过相应的元组标识符进入表。B-树操作符类必须为数据类型定义线性排序。数字、字符串和日期是典型例子。相比之下,几何点没有适用于通常 B-树语义的单一自然全序;PostgreSQL 为空间数据提供了其他索引类型。
PostgreSQL 的 B-树是平衡的,并且具有很高的分支度。它的深度取决于键的大小和索引项的数量,但在实践中,即使是非常大的索引通常也只需要几层。
{#qpt-fig-3-3 num="3.3" caption="B-树索引与堆页" .book-original-figure .d-flex .flex-column .align-items-center width=418 height=256}
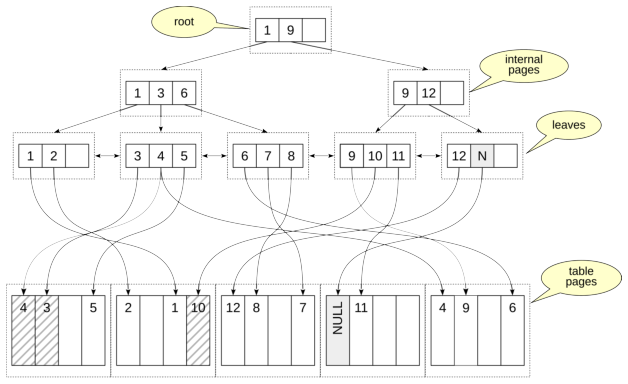
图中展示了一个 B-树示例。它的页面由索引项组成,每个索引项包含:
- 一个**键**——来自索引列(键列)的值;
- 要么是指向另一个索引页的向下链接,要么在叶级包含一个或多个表行版本的引用。
页面内的键按顺序排列。
**叶页**是树的最底层。它们的索引项引用表行版本。叶页沿两个方向相互链接,因此可以高效地向前或向后扫描键。
**内部页**指向下一层的页面。分隔键告诉搜索过程哪个子树可能包含请求的值。最顶层的页面是**根页**。
B-树页面不必完全填满;空闲空间可供未来插入使用。
当一个页面无法容纳新项时,PostgreSQL 会拆分该页面。一半保留在原页面中,并分配一个新的兄弟页面。B-树页面通常不会在拆分后重新合并,因此某些工作负载可能导致索引增长和碎片化。
默认情况下,B-树索引在升序时将空值存储在非空值之后(`NULLS LAST`)。创建索引时,可以结合 `ASC` 或 `DESC`(视需要而定)使用 `NULLS FIRST` 或 `NULLS LAST` 改变排序方式。
### 查找单个值 {#qpt-p42-looking-up-one-value}
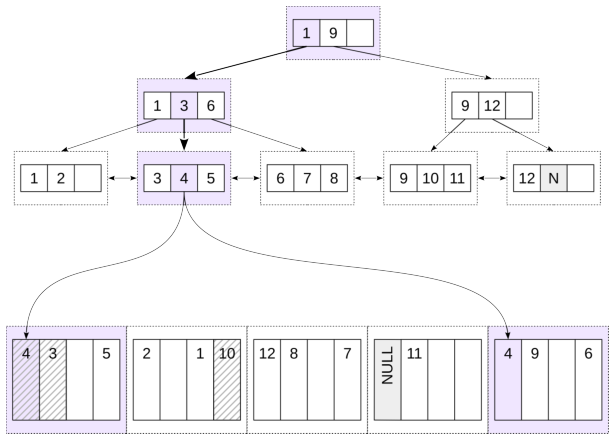
假设我们要查找索引值为 4 的行。
搜索从树的根开始。根页中的索引项定义了下方页面的键范围:“从 1 到 9”和“9 及以上”。我们需要“从 1 到 9”的范围,它对应于键为 1 的索引项。键是有序的,因此在页面内搜索非常高效。
{#qpt-fig-3-4 num="3.4" caption="单个值的索引查找" .book-original-figure .d-flex .flex-column .align-items-center width=410 height=292}
我们找到的索引项引用指向第二层的一个页面。在那里,我们找到“从 3 到 6”的范围
(键为 3),然后移动到第三层的一个页面。这是一个叶页。在那里我们找到键 4,并沿着它的引用进入表页。
请注意,即使是唯一索引也可能包含重复键,因为 MVCC 可以为同一行创建多个版本。为了节省空间,相等的键可以作为一个索引项存储在索引页中,该索引项包含多个指针。
返回一个堆元组之前,必须检查其可见性。
图中突出显示了必须访问的页面和索引项。
考虑 `bookings` 表。列 `book_ref` 是主键,因此 PostgreSQL 自动创建了唯一 B-树索引 `bookings_pkey`。
检查查找一个键时的计划:
```sql
EXPLAIN SELECT * FROM bookings WHERE book_ref = 'CDEFD8';
QUERY PLAN
---------------------------------------------
Index Scan using bookings_pkey on bookings
(cost=0.43..8.45 rows=1 width=21)
Index Cond: (book_ref = 'CDEFD8'::bpchar)
(3 rows)
```
所选择的访问方法是 `Index Scan`,计划中也给出了索引名称。对索引和堆的访问由一个计划节点表示。`Index Cond` 显示索引使用的条件。
对于这类查找,启动代价包括下降到相关叶页所需的工作。这个估计值很小,是因为规划器预计 B-树的上层页面已经在缓存中,主要只对向下查找过程收取 CPU 工作的代价。
总代价还要加上预期的叶页和堆页访问。
由于该索引是唯一索引,而且相等条件至多能识别一个可见行,粗略的代价直觉大致是访问一个叶页,再访问一个堆页。随机页面读取使用 `random_page_cost` 计价:
```sql
SELECT current_setting('random_page_cost');
current_setting
-----------------
4
(1 row)
```
它的默认值高于 `seq_page_cost`,反映了传统上为非顺序访问设定的更高代价。在 SSD 上,或者大多数数据都已缓存时,实际部署中通常会缩小这两个参数之间的差距。
正确的取值取决于存储和工作负载,而不是某条适用于所有情况的 SSD 规则。
`Index Cond` 包含能够驱动索引扫描的条件,或能够在索引层检查的其他条件。
需要访问堆行的条件会单独显示为 `Filter`:
```sql
EXPLAIN SELECT * FROM bookings
WHERE book_ref = 'CDEFD8' AND total_amount > 1000;
QUERY PLAN
---------------------------------------------
Index Scan using bookings_pkey on bookings
(cost=0.43..8.45 rows=1 width=21)
Index Cond: (book_ref = 'CDEFD8'::bpchar)
Filter: (total_amount > '1000'::numeric)
(4 rows)
```
### 查找一个范围 {#qpt-p45-looking-up-a-range}
B-树不仅适合相等查找,也适合有序范围:`<`、`<=`、`>`、`>=` 和 `BETWEEN`。
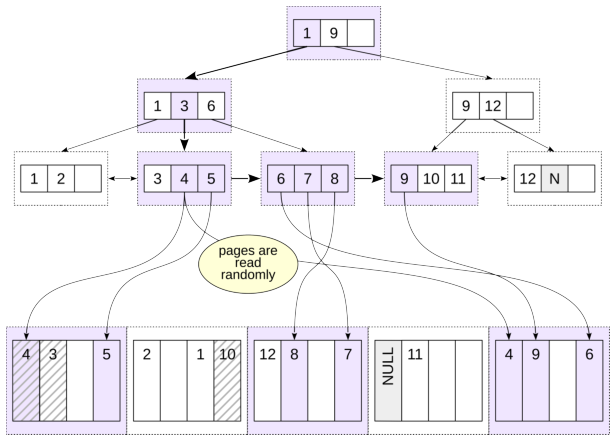
首先,找到条件的边界键。例如,对于从 4 到 9 的范围,可以选择 4 或 9;而对于“小于 9”的条件,则必须选择 9。然后,像前面的例子一样下降到叶索引页,取得表中的第一个值。从那里开始,根据条件向右或向左经过叶索引页,检查索引项,直到遇到范围外的键。
{#qpt-fig-3-5 num="3.5" caption="索引范围扫描" .book-original-figure .d-flex .flex-column .align-items-center width=411 height=293}
图中展示了对 `x BETWEEN 4 AND 9` 的搜索,它等价于 `x >= 4 AND x <= 9`。PostgreSQL 下降到第一个符合条件的键,然后访问 5、6 等值,一直到 9。到达 10 时,范围扫描停止。
有两个性质使这一过程成为可能:所有页面上的键都是有序的,叶页通过双向链表相互连接。搜索结果会自动排序。
注意,我们不得不多次访问同一个表页。我们先为值 4 读取第一个表页,然后再次为值 4 读取最后一个页面;接着为值 5 再次读取第一个页面,为值 6 再次读取最后一个页面,如此反复。
B-树提供的排序可以消除单独的排序操作:
```sql
EXPLAIN (costs off)
SELECT * FROM bookings
WHERE book_ref > '000CTL' AND book_ref < '000FHR'
ORDER BY book_ref;
QUERY PLAN
------------------------------------------------------------
Index Scan using bookings_pkey on bookings
Index Cond: ((book_ref > '000CTL'::bpchar) AND (book_...
(2 rows)
```
同一个 B-树也可以反向扫描:
```sql
EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM bookings
WHERE book_ref > '000CTL' AND book_ref < '000FHR'
ORDER BY book_ref DESC;
QUERY PLAN
------------------------------------------------------------
Index Scan Backward using bookings_pkey on bookings (ac...
Index Cond: ((book_ref > '000CTL'::bpchar) AND (book_...
Index Searches: 1
Buffers: shared hit=3 read=5
Planning:
Buffers: shared hit=13
(6 rows)
```
在这里,扫描到达适当的右侧叶位置,然后沿叶页链反向移动。`Buffers` 显示页面流量,而 `Index Searches` 显示发起了多少次独立的 B-树搜索。
## 3. 位图扫描 {#qpt-section-3-3}
反复访问相同的堆页可能使普通索引扫描变得昂贵。即使页面已经在缓冲区缓存中,PostgreSQL 仍然必须定位并固定页面,还要完成所需的元组工作。**位图扫描**把查找候选元组位置和访问堆页分离开来。
{#qpt-fig-3-6 num="3.6" caption="从索引构建位图" .book-original-figure .d-flex .flex-column .align-items-center width=410 height=292}
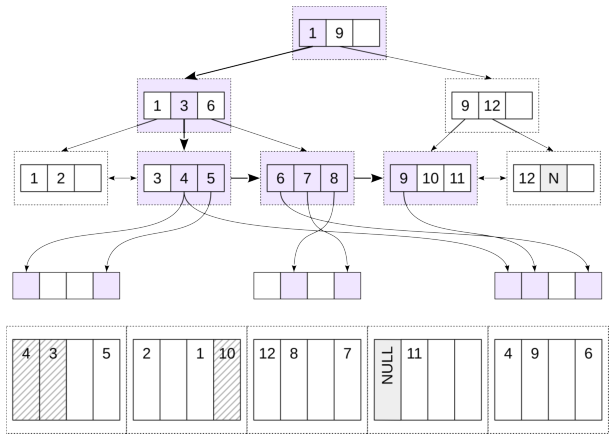
首先扫描索引(`Bitmap Index Scan`),并在进程的本地内存中构建位图。位图由多个块组成。每个块对应一个表页,块中的每一位对应该页面中的一个行版本。构建位图时,会标记满足条件且必须读取的行版本。由于位图被分成多个块,只标记少数行版本的位图占用的空间很小。
从概念上说,精确位图项标识堆页以及这些页面中的元组偏移量。
{#qpt-fig-3-7 num="3.7" caption="通过位图读取堆页" .book-original-figure .d-flex .flex-column .align-items-center width=418 height=118}
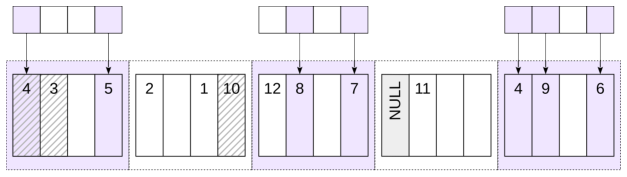
位图准备好后,`Bitmap Heap Scan` 会访问堆页。
一个堆页可能包含多个候选元组,但页面本身只需访问一次。当许多匹配的索引项分散在较少的堆页中时,这就是相对于普通索引扫描的主要优势。
```sql
CREATE INDEX ON bookings(book_date);
CREATE INDEX ON bookings(total_amount);
```
上面创建的两个索引为规划器提供了可供选择的位图来源。对于返回大量行的查询,它会选择位图扫描:
```sql
EXPLAIN SELECT *
FROM bookings WHERE total_amount < 5000;
QUERY PLAN
-----------------------------------------------------
Bitmap Heap Scan on bookings
(cost=6241.15..26259.60 rows=332996 width=21)
Recheck Cond: (total_amount < '5000'::numeric)
-> Bitmap Index Scan on bookings_total_amount_idx
(cost=0.00..6157.90 rows=332996 width=0)
Index Cond: (total_amount < '5000'::numeric)
(6 rows)
```
计划中有两个相关节点:
- `Bitmap Index Scan` 读取索引并构建位图。
- `Bitmap Heap Scan` 使用位图读取堆页。
启动代价体现了这种权衡:位图必须完整构建后才能使用。位图访问放弃了普通索引扫描的流式行为,换取组织得更好的堆访问。
### 组合位图 {#qpt-p49-combining-bitmaps}
位图还可以组合多个索引条件。对于同一索引上的两个范围:
```sql
EXPLAIN (costs off)
SELECT * FROM bookings
WHERE total_amount < 5000
OR total_amount > 500000;
QUERY PLAN
------------------------------------------------------------
Bitmap Heap Scan on bookings
Recheck Cond: ((total_amount < '5000'::numeric) OR (t...
-> BitmapOr
-> Bitmap Index Scan on bookings_total_amount_idx
Index Cond: (total_amount < '5000'::numeric)
-> Bitmap Index Scan on bookings_total_amount_idx
Index Cond: (total_amount > '500000'::numeric)
(7 rows)
```
PostgreSQL 构建两个位图,再使用 `BitmapOr` 将它们组合起来。
不同的索引也可以参与组合位图扫描:
```sql
EXPLAIN (costs off)
SELECT * FROM bookings
WHERE total_amount < 5000
OR book_date = bookings.now() - INTERVAL '1 day';
```
```text
QUERY PLAN
------------------------------------------------------------
Bitmap Heap Scan on bookings
Recheck Cond: ((total_amount < '5000'::numeric) OR (b...
-> BitmapOr
-> Bitmap Index Scan on bookings_total_amount_idx
Index Cond: (total_amount < '5000'::numeric)
-> Bitmap Index Scan on bookings_book_date_idx
Index Cond: (book_date = ('2026-03-01 03:00:0...
(7 rows)
```
### 有损位图页 {#qpt-p50-lossy-bitmap-pages}
位图存储在后端本地内存中,并受 `work_mem` 限制;位图扫描不会把位图溢出到临时文件。
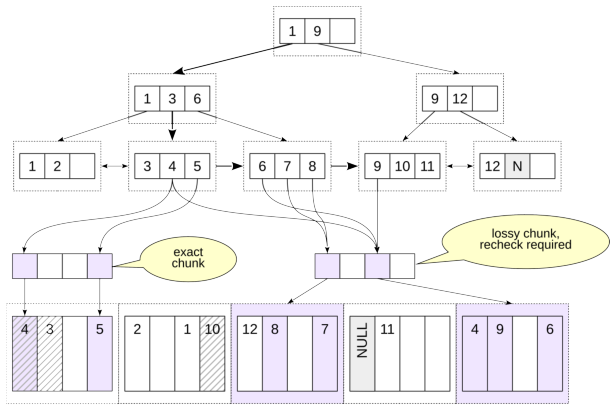
如果精确位图增长得太大,PostgreSQL 可以把其中一部分变成**有损**位图项。精确项标识堆页中的单独元组偏移量;有损项只记住某个堆页可能包含匹配项。
{#qpt-fig-3-8 num="3.8" caption="精确位图项与有损位图项" .book-original-figure .d-flex .flex-column .align-items-center width=411 height=273}
当 `work_mem` 非常小而结果集非常大时,即使完全有损的位图也可能无法放入内存。在这个例外情况下,PostgreSQL 可以超出 `work_mem` 预算,分配足够的内存来表示所需的堆页。
有损位图块可以节省内存,但当 `Bitmap Heap Scan` 到达这样的块时,必须重新检查对应表页上每个行版本的条件。
有损块需要重新检查表页中每个行版本的条件,这会影响性能。如果两个位图被组合,而其中至少一个位图中的某个块是有损的,那么合并后的块也必须是有损的。因此,`work_mem` 的取值可能对位图扫描性能产生很大影响。
`Bitmap Heap Scan` 会显示重新检查条件(`Recheck Cond`)。条件并不总是重新检查,只有当位图无法放入内存而失去精度时才需要重新检查。
使用正常的内存设置:
```sql
EXPLAIN (analyze, costs off, buffers off, timing off)
SELECT * FROM bookings WHERE total_amount < 5000;
QUERY PLAN
------------------------------------------------------------
Bitmap Heap Scan on bookings (actual rows=332628.00 loo...
Recheck Cond: (total_amount < '5000'::numeric)
Heap Blocks: exact=15839
-> Bitmap Index Scan on bookings_total_amount_idx (ac...
Index Cond: (total_amount < '5000'::numeric)
Index Searches: 1
Planning Time: 0.029 ms
Execution Time: 39.772 ms
(8 rows)
```
`Heap Blocks: exact=15839` 告诉我们,所有堆页项都保持精确。
现在减少可用内存,再运行同一查询:
```sql
SET work_mem = '512kB';
EXPLAIN (analyze, costs off, buffers off, timing off)
SELECT * FROM bookings WHERE total_amount < 5000;
QUERY PLAN
------------------------------------------------------------
Bitmap Heap Scan on bookings (actual rows=332628.00 loo...
Recheck Cond: (total_amount < '5000'::numeric)
Rows Removed by Index Recheck: 1121673
Heap Blocks: exact=7581 lossy=8258
-> Bitmap Index Scan on bookings_total_amount_idx (ac...
Index Cond: (total_amount < '5000'::numeric)
Index Searches: 1
Planning Time: 0.053 ms
Execution Time: 84.084 ms
(9 rows)
```
现在有些堆页由有损位图项表示。`Rows Removed by Index Recheck` 显示 PostgreSQL 必须重新检查条件时,有多少候选行未通过该条件。
恢复设置:
```text
RESET work_mem;
```
### 聚簇 {#qpt-p52-clustering}
当堆行与索引顺序在物理上相关时,普通索引扫描会变得有吸引力得多。
此时,相邻的索引项往往会指向同一个堆页或相邻堆页,因此扫描执行的随机堆访问会大幅减少。
当物理相关性非常高时,位图按页面分组的优势可能基本消失,规划器也许会偏好普通索引扫描。
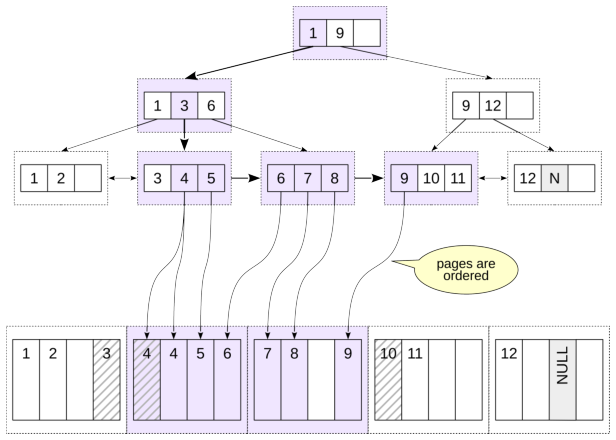
{#qpt-fig-3-9 num="3.9" caption="按索引顺序聚簇堆行" .book-original-figure .d-flex .flex-column .align-items-center width=411 height=293}
`CLUSTER` 命令可以根据索引对表进行物理重写。最初,`bookings` 中的行并未按物理顺序排列,下面这条不带 `ORDER BY` 的查询可以说明这一点:
```sql
SELECT * FROM bookings LIMIT 10;
book_ref | book_date | total_amount
----------+-------------------------------+--------------
2EW1SQ | 2025-09-01 03:00:12.557744+03 | 8125.00
3ZY3O5 | 2025-09-03 03:25:35.278453+03 | 7500.00
756UAS | 2025-09-10 19:24:02.978559+03 | 6325.00
GC7I6S | 2025-09-03 03:26:37.085293+03 | 18000.00
RBUUIQ | 2025-09-01 03:00:33.126206+03 | 13000.00
GB7E53 | 2025-09-10 18:58:23.948989+03 | 11000.00
6TAS39 | 2025-09-01 03:00:06.265219+03 | 5000.00
UEX925 | 2025-09-03 03:27:39.815145+03 | 19550.00
GGY5EU | 2025-09-01 03:00:07.565193+03 | 5750.00
MS148V | 2025-09-03 03:29:12.70515+03 | 6750.00
(10 rows)
```
按照 `total_amount` 上的索引重新排列行。
我们在事务中执行代码,这样聚簇就不会影响后续命令:
```sql
BEGIN;
CLUSTER bookings USING bookings_total_amount_idx;
CLUSTER
```
现在,普通顺序读取恰好会按新的物理顺序遇到行:
```sql
SELECT * FROM bookings LIMIT 10;
book_ref | book_date | total_amount
----------+-------------------------------+--------------
7ZHP9E | 2025-09-10 19:44:37.68484+03 | 1750.00
PZO1NI | 2025-11-12 03:45:47.817622+03 | 1750.00
6BC1L3 | 2025-09-03 05:32:45.971723+03 | 1750.00
YQQ1XT | 2025-09-24 03:35:58.864739+03 | 1750.00
EQXEG8 | 2025-11-05 03:52:11.774956+03 | 1750.00
BS0GMN | 2025-09-17 03:36:35.340508+03 | 1750.00
9HLHGP | 2026-02-18 04:09:04.979717+03 | 1750.00
SFR4P7 | 2025-10-15 03:37:58.510102+03 | 1750.00
XDD0AF | 2025-11-26 04:06:02.505752+03 | 1750.00
BKVSNB | 2025-10-02 07:44:39.551269+03 | 1750.00
(10 rows)
ANALYZE bookings;
EXPLAIN (costs off)
SELECT * FROM bookings WHERE total_amount < 5000;
QUERY PLAN
--------------------------------------------------------
Index Scan using bookings_total_amount_idx on bookings
Index Cond: (total_amount < '5000'::numeric)
(2 rows)
ROLLBACK;
```
上面的 `ANALYZE` 会刷新统计信息,使规划器了解新的物理相关性。在聚簇之前,这个谓词使用位图扫描;相关性很强时,普通索引扫描的代价更低。最后的 `ROLLBACK` 将表恢复到后续示例所需的状态。
有两点实践因素很重要:
- `CLUSTER` 会重写表,并需要 `ACCESS EXCLUSIVE` 锁,类似于其他整表重写操作;
- PostgreSQL 不会自动维护聚簇顺序。之后的插入和更新可能会逐渐降低相关性。
## 4. 覆盖索引 {#qpt-section-3-4}
### 仅索引扫描 {#qpt-p55-index-only-scan}
如果查询只需要索引中已有的值,那么对于该查询来说,这个索引就可以是**覆盖索引**。
原则上,PostgreSQL 此时可以不访问堆就回答查询。MVCC 的可见性使事情变得复杂。B-树叶项会告诉 PostgreSQL 它引用的是哪个表元组,但索引项没有携带足够的可见性信息,无法证明该元组对当前快照可见。
**可见性映射**(visibility map)为已知**全可见**(all-visible)的页面解决了这个问题。如果映射表明表页中的每个元组对所有事务都可见,那么仅索引扫描可以跳过从叶索引项跟随引用访问该堆页。
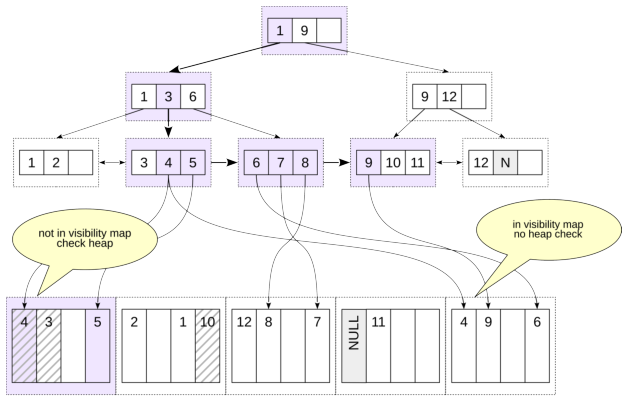
{#qpt-fig-3-10 num="3.10" caption="仅索引扫描与可见性映射" .book-original-figure .d-flex .flex-column .align-items-center width=418 height=268}
因此,清理活动对仅索引扫描很重要:必要时,更新和删除会清除全可见信息;清理在验证页面后可以再次设置全可见位。
规划器不知道未来确切会发生多少次堆获取。它在为仅索引扫描计算代价时,会使用关系统计信息,其中包括全可见页面所占比例的估计值。如果预计堆访问次数过多,规划器可能会认为另一种访问方法的代价更低。
对于每个匹配的索引项,执行器都会检查可见性映射。如果堆页是全可见的,就不需要访问堆;否则必须获取堆元组以检查可见性。即使需要访问部分堆页,这个计划节点仍然称为 `Index Only Scan`。
```sql
EXPLAIN (analyze, buffers off, costs off, timing off)
SELECT total_amount
FROM bookings
WHERE total_amount > 200000;
```
```text
QUERY PLAN
------------------------------------------------------------
Index Only Scan using bookings_total_amount_idx on book...
Index Cond: (total_amount > '200000'::numeric)
Heap Fetches: 0
Index Searches: 1
Planning Time: 0.122 ms
Execution Time: 0.148 ms
(6 rows)
```
`Heap Fetches` 显示为了进行可见性检查而需要获取多少个堆元组。这里可见性映射已经足够,因此不需要访问堆。
现在更新一行:
```sql
UPDATE bookings
SET total_amount = total_amount
WHERE book_ref = '00EV9A';
UPDATE 1
```
这次更新会清除受影响堆页的全可见状态。当匹配的索引项指向该页面时,执行器必须访问堆:
```sql
EXPLAIN (analyze, buffers off, costs off, timing off)
SELECT total_amount
FROM bookings
WHERE total_amount > 200000;
QUERY PLAN
------------------------------------------------------------
Index Only Scan using bookings_total_amount_idx on book...
Index Cond: (total_amount > '200000'::numeric)
Heap Fetches: 3
Index Searches: 1
Planning Time: 0.033 ms
Execution Time: 0.136 ms
(6 rows)
```
执行器并没有扫描修改页面中的每个元组。相反,需要进行可见性检查的索引项触发了堆获取,因为该页面已经不能再被信任为全可见。
### INCLUDE 索引 {#qpt-p58-include-indexes}
覆盖索引可以大幅降低查询代价,但把每个所需列都作为索引**键**加入并不总是合适。例如:
- 向唯一索引中加入键列,会改变被声明为唯一的值组合。
- 新增列的数据类型可能不受该索引支持。
PostgreSQL 允许通过 `INCLUDE` 子句让索引携带**非键列**。
包含的值不参与搜索树的键语义。它们作为载荷存储在叶项中,因此仅索引扫描可以在不访问表的情况下返回这些值。
在 PostgreSQL 18 中,B-树、GiST 和 SP-GiST 索引都支持 `INCLUDE`。
**INCLUDE 索引**和**覆盖索引**不是同一个概念。一个索引可以在不使用 `INCLUDE` 的情况下覆盖特定查询;反过来,带有包含列的索引也可能无法覆盖另一个查询。
主键索引 `tickets_pkey` 包含 `ticket_no`,但不包含 `book_ref`,因此它对于这个查询不是覆盖索引:
```sql
EXPLAIN (analyze, costs off, summary off)
SELECT ticket_no, book_ref
FROM tickets
WHERE ticket_no > '0005435990286';
QUERY PLAN
------------------------------------------------------------
Index Scan using tickets_pkey on tickets (actual time=0...
Index Cond: (ticket_no > '0005435990286'::text)
Index Searches: 1
Buffers: shared hit=1496831 read=23275 written=17
Planning:
Buffers: shared hit=46 read=6
(6 rows)
```
`Buffers` 行报告页面访问情况。这里,数量非常大的缓冲区命中反映了这样一个代价:对于索引中不存在的值,访问表仍然需要大量工作。创建一个以 `book_ref` 作为载荷的唯一索引:
```sql
CREATE UNIQUE INDEX ON tickets (ticket_no)
INCLUDE (book_ref);
CREATE INDEX
EXPLAIN (analyze, costs off, summary off)
SELECT ticket_no, book_ref
FROM tickets
WHERE ticket_no > '0005435990286';
QUERY PLAN
------------------------------------------------------------
Index Only Scan using tickets_ticket_no_book_ref_idx on...
Index Cond: (ticket_no > '0005435990286'::text)
Heap Fetches: 0
Index Searches: 1
Buffers: shared hit=1 read=8033
Planning:
Buffers: shared hit=18 read=1 dirtied=1
(7 rows)
```
现在规划器选择了 `Index Only Scan`,并使用新建的索引。由于相关堆页都是全可见的,`Heap Fetches` 为零,访问的页面数量也大幅减少。
由于通过 `INCLUDE` 加入的列不会被索引访问方法使用,INCLUDE 索引可以包含 B-树不支持的数据类型,例如几何类型或 `xml`。
## 5. 并行访问 {#qpt-section-3-5}
PostgreSQL 可以并行执行查询计划的部分内容。**领导者**(leader)进程启动并行工作进程,后者执行计划中支持并行的部分。它们的输出由 `Gather` 或 `Gather Merge` 节点收集。
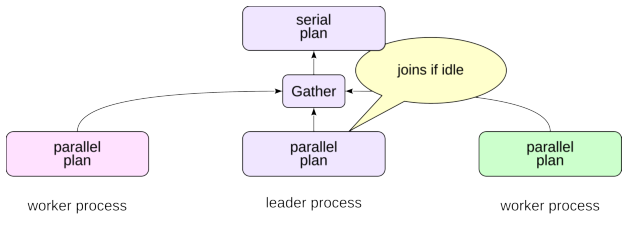
{#qpt-fig-3-11 num="3.11" caption="并行计划中的领导者与工作进程" .book-original-figure .d-flex .flex-column .align-items-center width=418 height=151}
领导者也可以参与执行并行计划,尤其是在它没有一直忙于从工作进程消费元组时。
启动工作进程、协调它们以及传输元组都有代价。因此,并行执行并不适用于每个查询。此外,只有部分计划节点和操作支持并行;计划的其余部分仍由领导者串行运行。
### 工作进程池限制 {#qpt-p61-worker-pool-limits}
有几个配置参数会限制并行执行。
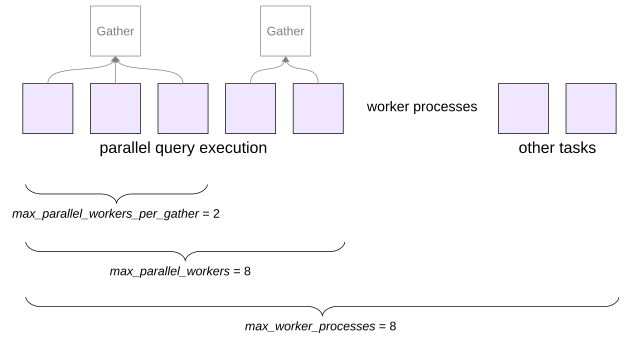
{#qpt-fig-3-12 num="3.12" caption="并行工作进程的限制" .book-original-figure .d-flex .flex-column .align-items-center width=420 height=227}
PostgreSQL 工作进程的用途并不局限于查询并行化。逻辑复制和扩展也可以使用后台工作进程。应用程序代码也可以使用工作进程;参见 DEV2 课程的“后台进程”一课。
`max_worker_processes` 限制可以处于活动状态的后台工作进程总数。其默认值为 8。
`max_parallel_workers` 限制服务器范围内可用于并行查询执行的工作进程数量。其默认值同样为 8。
`max_parallel_workers_per_gather` 限制一个领导者进程可以同时运行的工作进程数。其默认值为 2。
适当的取值取决于 CPU 能力、I/O 带宽、内存、工作负载以及并发会话数。
提高限制并不会让每个查询都更快;它只会改变规划器和执行器可以使用的并行工作量。
### 并行顺序扫描 {#qpt-p62-parallel-seq-scan}
`Parallel Seq Scan` 允许多个进程协作扫描一张表。
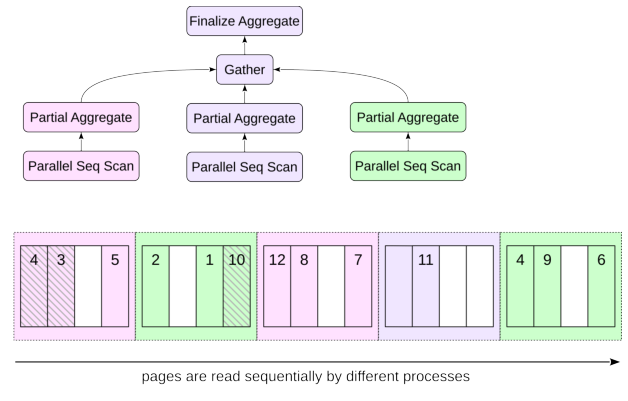
{#qpt-fig-3-13 num="3.13" caption="并行顺序扫描" .book-original-figure .d-flex .flex-column .align-items-center width=418 height=267}
这个名称并不矛盾。堆块仍然按顺序访问,就像普通的 `Seq Scan` 一样。区别在于,参与并行的进程会并发读取这些块。它们共享同一个并行扫描状态,以便彼此保持同步。
收益并不只是存储可以由多个进程读取。每个工作进程还会对收到的页面执行谓词计算和其他逐行 CPU 工作。当节省下来的执行时间超过启动工作进程、同步和元组传输的开销时,并行才会带来收益。聚合就是一个很好的例子,因为工作进程可以扫描并部分聚合许多行,同时只向上发送紧凑的部分结果。
在小表上,`count(*)` 以串行方式执行的代价更低:
```sql
EXPLAIN SELECT count(*) FROM seats;
QUERY PLAN
------------------------------------------------------------
Aggregate (cost=31.76..31.77 rows=1 width=8)
-> Seq Scan on seats (cost=0.00..27.41 rows=1741 wid...
(2 rows)
```
`Aggregate` 必须读取全部输入后才能返回最终计数,因此它的启动代价接近总代价。
对大得多的 `bookings` 表运行同类查询:
```sql
EXPLAIN SELECT count(*) FROM bookings;
QUERY PLAN
------------------------------------------------------------
Finalize Aggregate (cost=29807.83..29807.84 rows=1 wid...
-> Gather (cost=29807.61..29807.82 rows=2 width=8)
Workers Planned: 2
-> Partial Aggregate (cost=28807.61..28807.62 ro...
-> Parallel Seq Scan on bookings (cost=0.00....
(5 rows)
```
`Gather` 以下的所有内容都属于计划的并行部分。它由规划好的工作进程执行,领导者也可能执行这部分。`Gather` 以及其上方的节点在领导者中运行。
每个工作进程计算部分计数;领导者收集这些部分结果,然后由 `Finalize Aggregate` 产生最终值。
并非每个查询都能使用并行执行。例如,许多修改数据或锁定行的操作都不符合条件,而函数和其他操作的并行安全规则也可能使计划变为串行。这些限制会随着 PostgreSQL 版本变化,因此应根据当前文档检查版本特定的细节。
### 并行索引扫描和并行仅索引扫描 {#qpt-p64-parallel-index-scan-and-parallel-index-only-scan}
B-树索引访问也可以参与并行计划。
并行 B-树扫描分两个阶段工作。首先,领导者进程从树根下降到叶页。然后,工作进程并行读取叶索引页,沿着页面链移动。读取索引页的进程也会读取所需的表页。
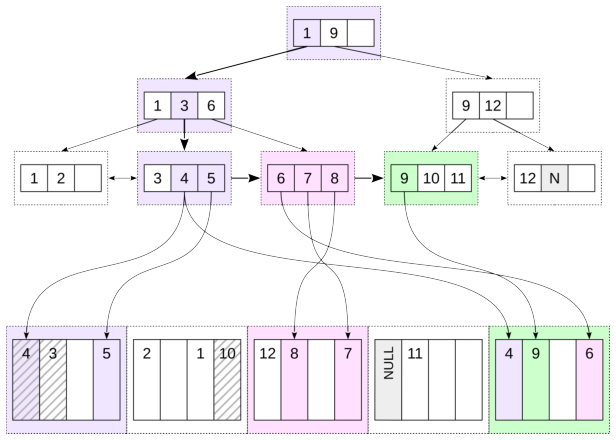
{#qpt-fig-3-14 num="3.14" caption="并行索引扫描" .book-original-figure .d-flex .flex-column .align-items-center width=411 height=293}
多个进程可能需要读取同一个表页。图中展示了这种情况:最后一个表页包含由不同进程读取的多个索引页所引用的行。当然,缓冲区缓存中只会有该页面的一个副本。并行仅索引扫描的工作方式类似,只是对于堆页全可见的索引项,可以避免访问堆。
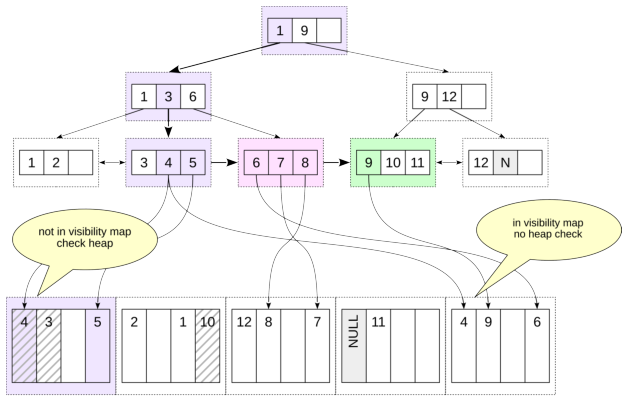
{#qpt-fig-3-15 num="3.15" caption="并行仅索引扫描" .book-original-figure .d-flex .flex-column .align-items-center width=418 height=268}
例如,统计上个月创建的预订:
```sql
EXPLAIN (costs off)
SELECT count(*)
FROM bookings
WHERE book_date > '2026-02-01 03:00:00+03';
QUERY PLAN
------------------------------------------------------------
Finalize Aggregate
-> Gather
Workers Planned: 2
-> Partial Aggregate
-> Parallel Index Only Scan using bookings_bo...
Index Cond: (book_date > '2026-02-01 03:0...
(6 rows)
```
其结构与前面的并行顺序扫描计划相似,但行是通过 `Parallel Index Only Scan` 获取的。
### 并行位图堆扫描 {#qpt-p66-parallel-bitmap-heap-scan}
堆的位图访问也可以并行执行。
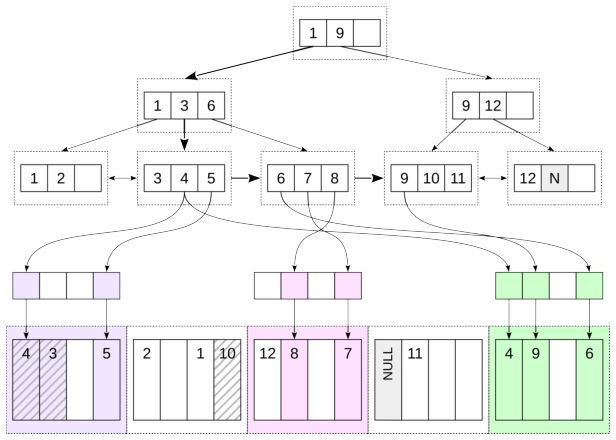
{#qpt-fig-3-16 num="3.16" caption="并行位图堆扫描" .book-original-figure .d-flex .flex-column .align-items-center width=411 height=293}
位图本身是串行构建的:领导者执行 `Bitmap Index Scan`,并构建共享的位图状态。
随后,工作进程可以通过 `Parallel Bitmap Heap Scan` 协作执行堆阶段。
统计最近三个月内创建且金额低于 5,000 的预订:
```sql
EXPLAIN (costs off)
SELECT count(*)
FROM bookings
WHERE total_amount < 5000
AND book_date > '2025-12-01 03:00:00+03';
```
```text
QUERY PLAN
------------------------------------------------------------
Finalize Aggregate
-> Gather
Workers Planned: 2
-> Partial Aggregate
-> Parallel Bitmap Heap Scan on bookings
Recheck Cond: (total_amount < '5000'::num...
Filter: (book_date > '2025-12-01 03:00:00...
-> Bitmap Index Scan on bookings_total_am...
Index Cond: (total_amount < '5000'::n...
(9 rows)
```
领导者在 `Bitmap Index Scan` 中构建位图。位图选出的堆块由 `Parallel Bitmap Heap Scan` 并行处理。
移除示例中创建的索引:
```text
DROP INDEX bookings_book_date_idx;
DROP INDEX bookings_total_amount_idx;
DROP INDEX tickets_ticket_no_book_ref_idx;
```
## 6. 比较访问方法 {#qpt-section-3-6}
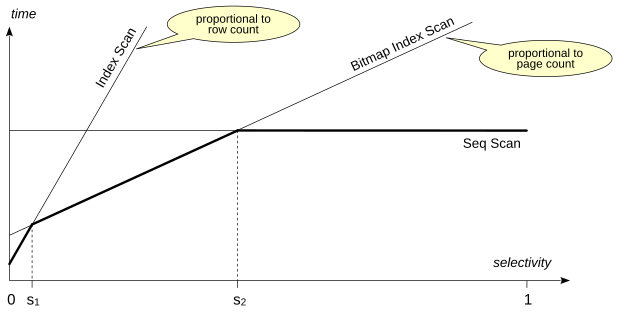
不存在一个普适的选择率阈值,能在该阈值处明确说明某种访问方法优于另一种;但总体模式很容易看出来。
当谓词**筛选作用很强**时——只需要一行或表的一小部分——普通索引扫描最有吸引力。此时,导航索引并获取少量堆页的代价远小于扫描整个关系。
在**中等选择率**下,位图扫描通常具有竞争力。它要支付构建位图的启动代价,但会减少重复的堆页访问。在最坏情况下,普通索引扫描的堆工作量可能大致随着匹配元组数量增长,而位图堆扫描会围绕包含候选行的堆页数量组织这些工作。
{#qpt-fig-3-17 num="3.17" caption="扫描代价与选择率" .book-original-figure .d-flex .flex-column .align-items-center width=413 height=208}
在**低选择率**下,也就是大多数行都能通过谓词时,顺序扫描通常最好。除了读取大部分堆之外再读取索引只会增加工作。在旋转磁盘上,这种效果更明显,因为随机读取远慢于读取物理位置连续的页面。
交叉点高度依赖于表、索引、物理相关性、行宽、缓存状态、存储、规划器代价参数以及具体查询。规划器会综合这些估计,而不是采用固定的“低于 X% 就使用索引”规则。
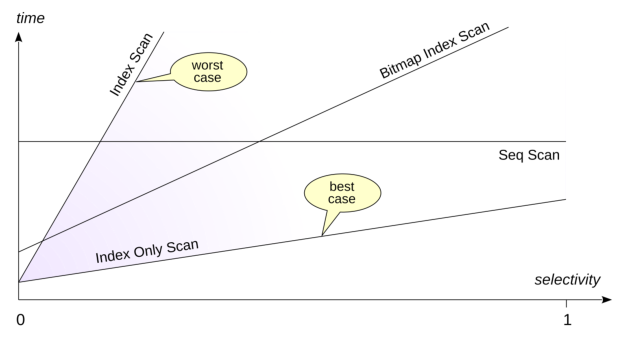
还有一个因素是排序。B-树索引扫描按索引顺序交付行,因此可以避免单独的排序。这可能使它很有吸引力,即使它原始的行访问代价并不是最低的。
{#qpt-fig-3-18 num="3.18" caption="仅索引扫描的最佳与最坏情况" .book-original-figure .d-flex .flex-column .align-items-center width=418 height=226}
仅索引扫描的性能很大程度上取决于可见性映射,以及有多少堆页是全可见的。
因此,规划器在计算仅索引访问的代价时,会纳入全可见页面比例的估计值。
## 参考资源 {#referenced-resources}
- [www.postgresql.org/docs/18/indexes-index-only-scans]()
- [www.postgresql.org/docs/18/mvcc]()
- [www.postgresql.org/docs/18/parallel-query]()
- [www.postgresql.org/docs/18/sql-vacuum]()
- [www.postgresql.org/docs/18/when-can-parallel-query-be-used]()