2 规划与执行
1. 简单查询协议
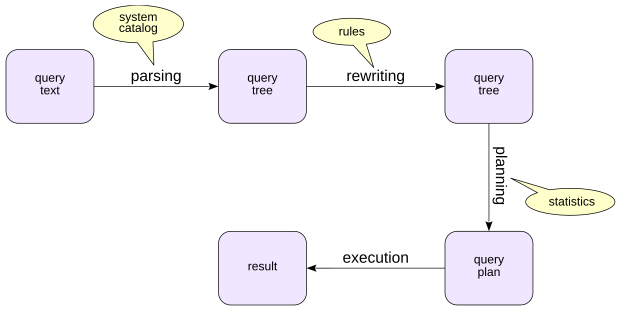
先从最简单的情况开始:当你在 psql 中输入一条 SELECT 命令时会发生什么?查询处理会经历以下几个阶段:
- 解析
- 重写
规划(优化)
执行
解析
语法分析
第一步是解析:PostgreSQL 将查询文本拆分为标识符、数字、字符串字面量等词法单元,并检查这些词法单元能否组成语法有效的结构。
以一条简单查询为例:
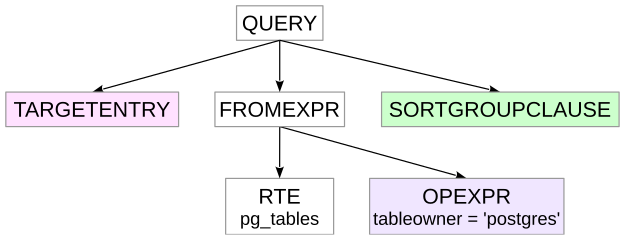
在这个阶段,后端会在内存中构建一棵语法解析树(parse tree)。图中展示了这棵树的简化版本。颜色表示查询文本各部分与树中节点之间的大致对应关系。
RTE 是范围表项(Range Table Entry)的缩写,这个名称从外部看并不直观。PostgreSQL 在内部使用 RTE 表示表、子查询、连接结果以及 SQL 查询中可能出现的其他行集。
语义分析
接下来是语义分析,在 PostgreSQL 中称为解析分析(parse analysis)。在这个阶段,PostgreSQL 会确定查询引用了哪些数据库对象,以及用户是否有权访问这些对象。
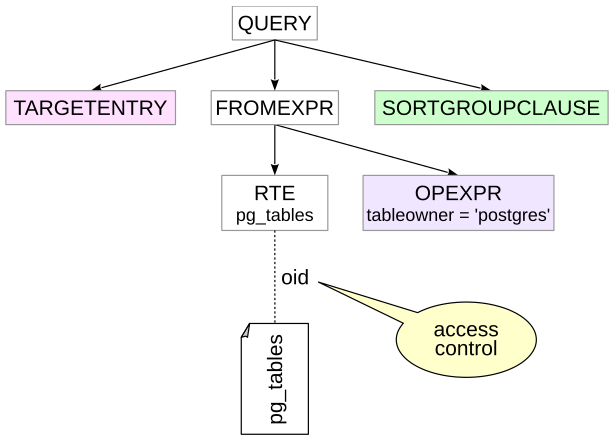
在解析分析期间,PostgreSQL 会查询系统目录。在这个例子中,它把名称 pg_tables 解析为目录中由 oid 标识的某个具体视图,同时也会检查该视图上的访问权限。
重写
然后,查询会根据规则进行重写。
其中一个重要的特殊情况是视图:对视图的引用会展开为定义该视图的查询。严格来说,处理过程并不像这个简化序列所暗示的那样泾渭分明,因为视图定义本身也必须经过解析和分析。
对于我们的示例,可以近似地把结果画成下面这样:
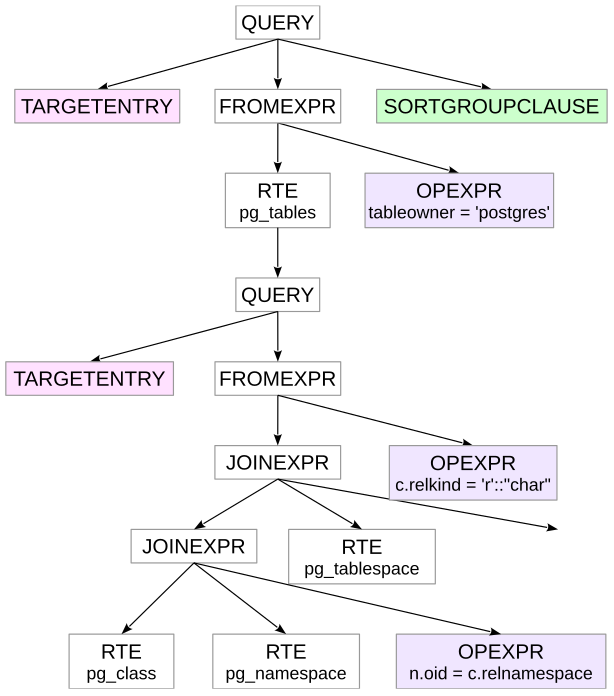
这里的 SQL 仅用于说明。重写操作的对象是查询树,而不是替换 SQL 文本。在树中,与视图查询对应的节点会挂接到 pg_tables 的 RTE 下方。
规划
接下来 PostgreSQL 会规划查询。
规划器(planner)会考虑执行查询的不同方式,并通过数学模型估计它们的代价。这个模型使用有关数据的信息,称为统计信息(statistics)。估计代价最低的候选方案会表示为一棵计划树。
我们的示例对应的计划片段如下:
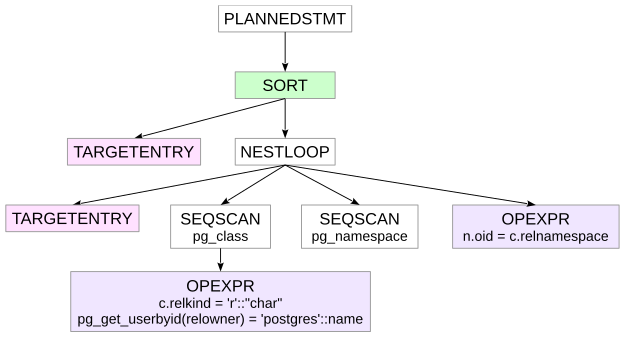
Seq Scan 从表中读取行,而 Nested Loop 连接两个行集。图中的文本表示形式就是 EXPLAIN 命令生成的形式。后续章节会详细讨论访问方法和连接方法。
注意,原来的三张表中现在只剩下两张:规划器已经确定其中一张表不是生成结果所必需的,因此将它从计划中移除了。
执行
最后,执行器运行选定的计划,并将结果返回给客户端。
计划树的工作方式类似一条流水线。下图重新绘制了计划树,只保留其基本结构。
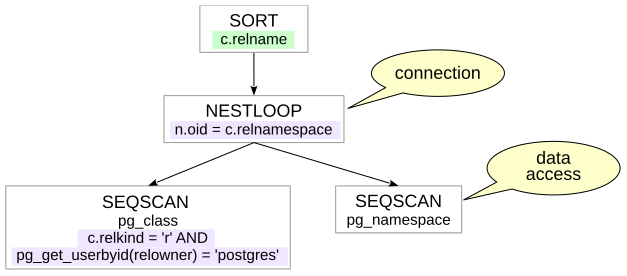
执行从树的根节点开始。在这个例子中,根节点是 Sort,它向子节点请求数据。获得所需数据后,根节点执行自己的操作并将行向上返回,最终送达客户端。
Nested Loop 这样的节点会组合来自不同来源的数据。连接节点向两个子节点请求行,根据连接条件比较这些行,然后把匹配的行对返回给父节点。下方的 Seq Scan 节点从对应的表中读取行,并将行向上交给连接节点。
有些节点必须读取完所需的全部输入后才能返回任何结果。普通排序就是一个例子:它必须先看到输入,才能确定排序后的顺序。
另一些节点可以随着行到达而返回行。例如,表扫描通常可以在读取表的同时产生行。这样就有可能迅速返回结果的前一部分,例如应用程序逐页显示数据时。PostgreSQL 文档把这种执行器机制称为按需拉取的流水线(demand-pull pipeline):父节点向子节点请求下一行,这个请求沿着计划树向下传播。
2. 扩展查询协议
默认情况下,客户端使用简单查询协议:它向服务器发送一条 SQL 语句,然后对于 SELECT 或带有 RETURNING 的命令接收结果行。
例如:
使用简单查询协议时,即使同一条查询被反复执行,每次查询仍然会经历上面描述的全部处理阶段。
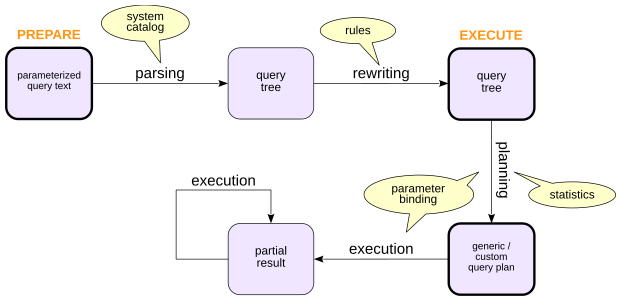
PostgreSQL 还提供扩展查询协议,把查询处理分成更明确的步骤。在实践中,这使得准备语句和使用游标成为可能。
预备语句
为了准备一条语句,客户端向服务器发送一个查询,其中可以包含参数。服务器会解析、分析并重写查询,然后在后端进程中保留预备语句状态。
要执行预备语句,客户端为它的参数提供值。然后,PostgreSQL 可以构建一份考虑了这些具体值的自定义计划(custom plan)并执行它。
准备语句可以避免在同一会话中反复执行同一条语句时重复解析、分析和重写。
如果语句没有参数,那么没有必要为每次执行重新规划,因此 PostgreSQL 可以复用一份通用计划(generic plan)。
如果语句确实有参数,PostgreSQL 起初可以使用自定义计划;当它估计通用计划的平均表现不会显著变差时,之后也可能切换到通用计划。我们会在 第六章“统计信息”中回到这个决策。
预备语句也是避免 SQL 注入的重要手段:来自不可信来源的值可以作为参数单独发送,而不必拼接进 SQL 文本。这种保护适用于作为参数传递的值;对于表名、列名等动态 SQL 结构,仍然必须采用安全方式构造。
准备一条参数化语句:
按名称执行它:
在执行时,参数值会被绑定,语句按需进行规划,然后执行。
可以通过 pg_prepared_statements 视图检查预备语句:
使用通用计划的执行次数
使用自定义计划的执行次数
最后两列显示该语句使用通用计划和自定义计划的次数。当预备语句不再需要时,可以使用 DEALLOCATE 将其移除。
PREPARE、EXECUTE 和 DEALLOCATE 是 SQL 命令。其他编程语言以不同方式提供相同的功能,但数据库驱动最终都会使用相同的客户端/服务器协议。
游标
游标可以让我们逐步获取查询结果,而不是一次接收所有行。游标很常见,因为应用程序通常使用命令式语言编写,并且经常迭代处理结果集。
打开游标的信息保存在后端进程中。
在 SQL 中声明游标并获取第一行。游标通常存在于事务内部:
获取第二行(事务结束时游标会自动关闭):
数据库 API 提供了判断是否还有结果数据的方法,因此应用程序可以在循环中从游标获取数据。
3. 深入了解规划
规划值得进一步了解,因为它既是查询性能的核心,也是查询处理过程中较为复杂的阶段之一。
规划过程
规划器会探索不同的执行计划,估计它们的代价,并从中选择找到的代价最低者。
计划节点的代价取决于正在执行的操作以及它所处理的数据的性质。显然,按顺序从表中读取行与通过索引获取行使用的是不同的代价模型,而正在处理的数据量也非常重要。
估计数据量时,有两个概念尤其重要:
基数(cardinality):节点产生的行数估计值
选择率(selectivity):满足某个条件或谓词的输入行所占的比例
估计选择率和基数需要有关数据的信息:表的大小、列中的值分布等等。在实践中,这会把我们引向统计信息。PostgreSQL 通过 autovacuum 的自动分析工作以及 ANALYZE 命令收集和刷新统计信息。基数错误是造成糟糕计划的最重要原因之一。
基数错误可能来自统计信息不足,可能来自现有统计信息没有描述的相关性,可能来自没有可用有效统计信息的表达式,也可能来自规划器估计模型的局限。即使基数估计正确,也不能保证代价估计完美——代价模型及其参数都是近似值——但基数是后续几乎每项规划决策的重要输入。
基数估计
基数估计是递归进行的。为了估计某个节点的基数,PostgreSQL 会先估计其子节点的基数,然后根据节点类型和节点的谓词估计该节点本身会产生多少行。
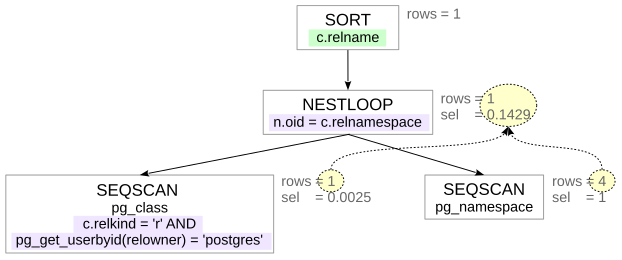
这个过程从叶节点开始,访问方法在叶节点读取数据。估计叶节点需要知道关系的大小以及其谓词的选择率。后续章节会说明这些估计来自哪里。
暂且假设我们可以估计简单谓词的选择率。这样,就可以使用如下公式近似计算复合谓词的选择率:
这些公式假定条件 x 和 y 相互独立。如果谓词之间存在相关性,估计就可能出错。PostgreSQL 的扩展统计信息可以改善其中一些情况。
接下来是连接。我们已经有了两个输入行集的基数估计,因此还需要估计连接条件的选择率。具体细节暂且留到后面,之后会回到具体示例。
其他节点也可以用类似方式处理,例如聚合。排序通常保持基数不变,而其他操作可能会改变基数。
计划树底部引入的估计误差会向上传播。随着更多操作符依赖错误估计,误差可能会被放大,最终导致规划器选择一个糟糕的计划。
代价估计
代价估计同样是递归进行的。为了估计计划子树的代价,PostgreSQL 会从子节点的代价开始,再加上当前节点执行操作的代价。
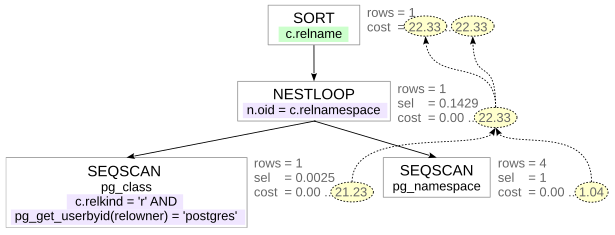
节点的代价由规划器的数学模型计算得出,该模型使用了为节点估计的基数和其他属性。
EXPLAIN 展示两个代价组成部分:启动代价定义了节点开始产生行之前必须完成的工作量估计值;总代价定义了产生全部行的代价估计值。
有些操作几乎不需要启动工作。另一些操作则必须在返回第一行之前完成大量工作。
例如,普通排序必须先读取要排序的输入,才能输出排好序的结果。这样的节点具有非零启动代价,即使消费者只需要最终结果中的一小部分,也必须支付这部分代价。
必须理解,代价反映的是规划器的估计,而且可能与实际执行时间没有关联。可以把代价看作用任意单位表示的量,这些单位本身没有意义。代价的用途只是让规划器能够比较同一查询的不同计划。
选择最佳计划
优化器会尝试在不过度耗费规划时间的前提下找到最佳计划。
对于连接,PostgreSQL 通常使用动态规划:从较小的连接关系构建更大的连接关系,同时丢弃那些按照规划器标准不可能胜出的替代方案。随着关系数量增加,穷举考虑所有连接顺序的代价会变得过高。PostgreSQL 可以通过只考虑部分成对连接方案,或切换到遗传查询优化器(Genetic Query Optimizer,GEQO),来减少需要考虑的计划数量。这又带来了计划不佳的另一种可能来源:问题不在于代价估计错误,而在于最佳计划从未被考虑。在这种情况下,查询作者有时可以通过约束连接顺序来提供帮助。
对于普通查询,什么样的计划算是“最佳”计划?PostgreSQL 通常会优化获取完整结果的过程,因此总代价占主导地位。
然而,使用游标时,快速获得前几行可能更加重要。参数 cursor_tuple_fraction(默认值为 0.1)告诉规划器预计会获取游标结果的多少比例。这个值越小,启动代价相对于总代价的影响就越大。
查看查询计划
EXPLAIN 会显示查询计划。它是查询性能工作不可或缺的工具,学会正确阅读它十分重要。下面是上面使用过的查询对应的计划:
加入 analyze 后,PostgreSQL 会执行查询,并显示实际执行统计信息以及估计值:
对会修改数据的语句使用 EXPLAIN ANALYZE 时要小心:该语句确实会被执行。
在某些平台上,为每个计划节点收集计时信息可能会明显拖慢查询。如果不需要每个节点的计时信息,可以使用 timing off 将其禁用。
参考资源
- www.postgresql.org/docs/18/protocol-flow
- www.postgresql.org/docs/18/query-path
- www.postgresql.org/docs/18/using-explain